奥特曼和Dario同台唱rap!Genspark新视频Agent上线,零基础也能拍短剧
奥特曼和Dario同台唱rap!Genspark新视频Agent上线,零基础也能拍短剧Genspark的视频Agent工作台,Genspark Media Studio,正式发布了!
来自主题: AI技术研报
10035 点击 2026-10-30 11:46

 搜索
Genspark的视频Agent工作台,Genspark Media Studio,正式发布了!
5600亿总参数,主攻个人智能体与复杂工作流。
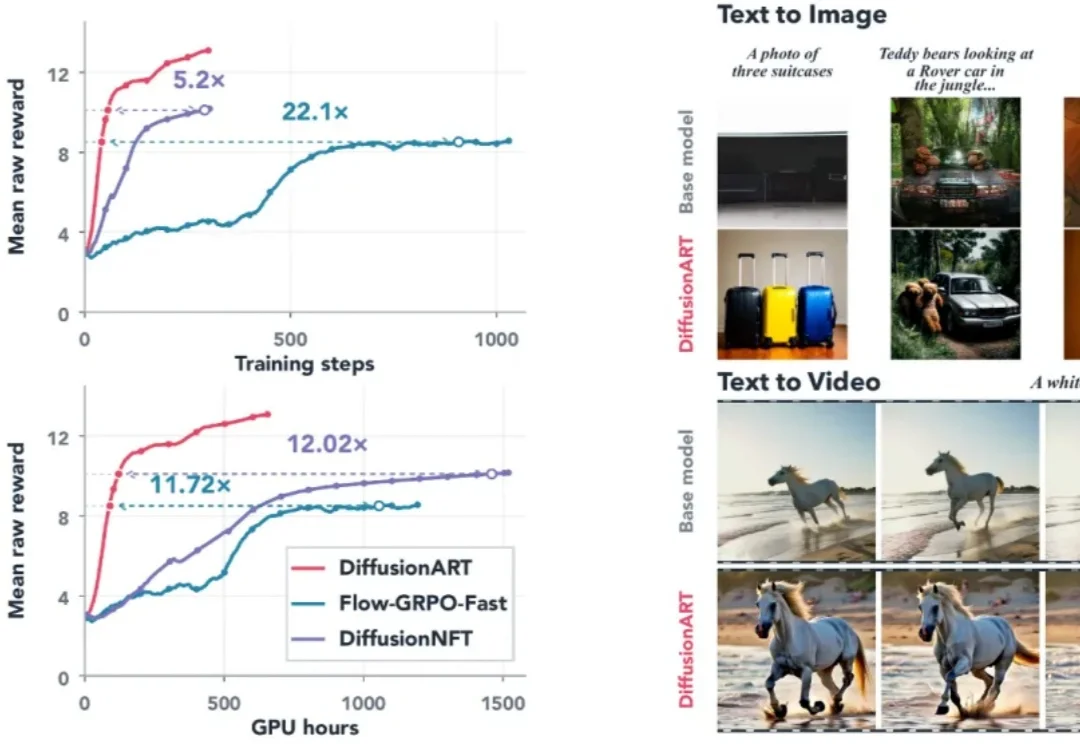
来自新加坡国立大学、可灵 AI 和香港科技大学的研究团队提出了 DiffusionART,一种面向图像和视频生成的在线 Diffusion RL 算法。该方法支持采用 ODE 采样,不要求奖励模型可微,也无需额外调参,可自然适配标量奖励、二值偏好奖励等多种奖励形式,具有极高的样本效率。
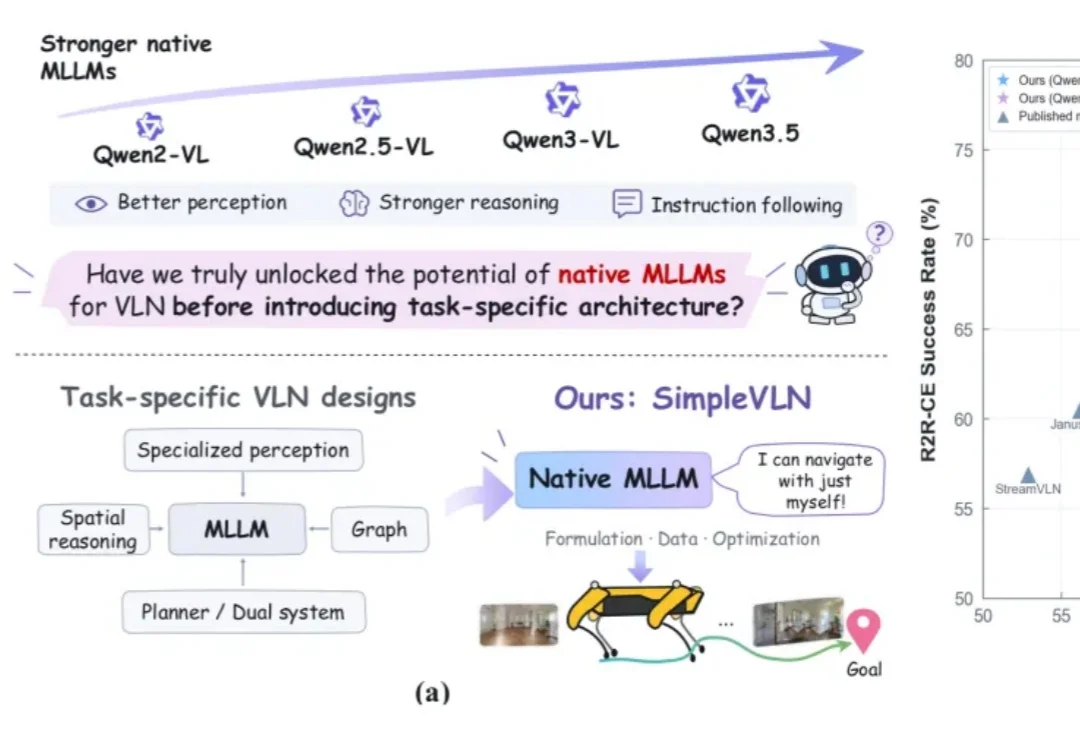
设想这样一个场景:给机器人下达一句自然语言指令,让它穿过走廊、接连转弯,最终走进指定房间。视觉语言导航(VLN),需要让机器人结合沿途看到的画面,把人类的语言指令转化为一连串连续行动。
一个充电器,一根缠成一团的线。
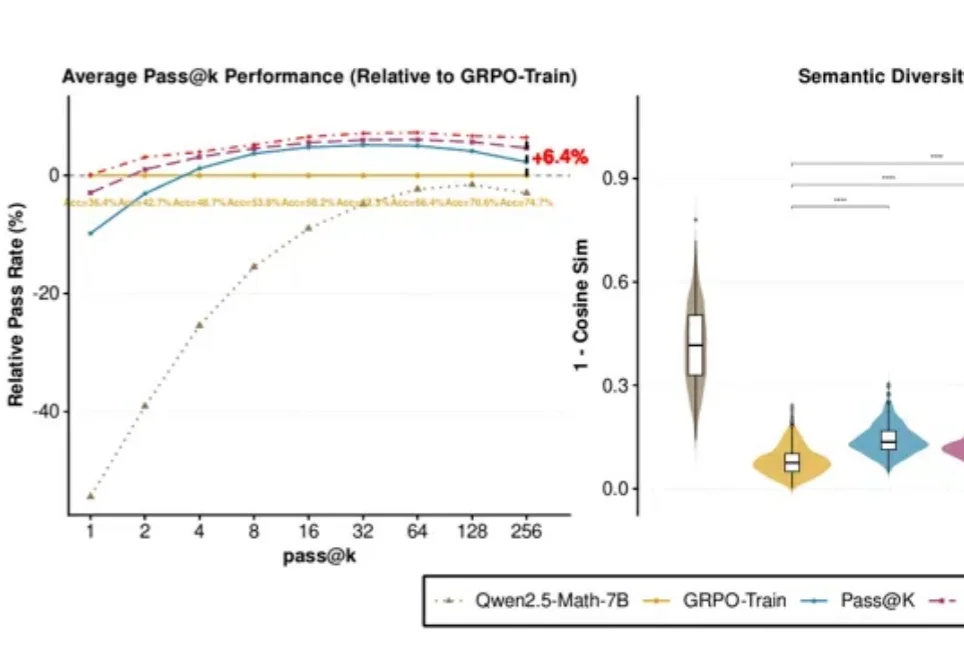
DeepSeek-R1等模型让人们看到了强化学习的潜力。但已有研究发现,模型答得更准,未必意味着能解出的题目更多。
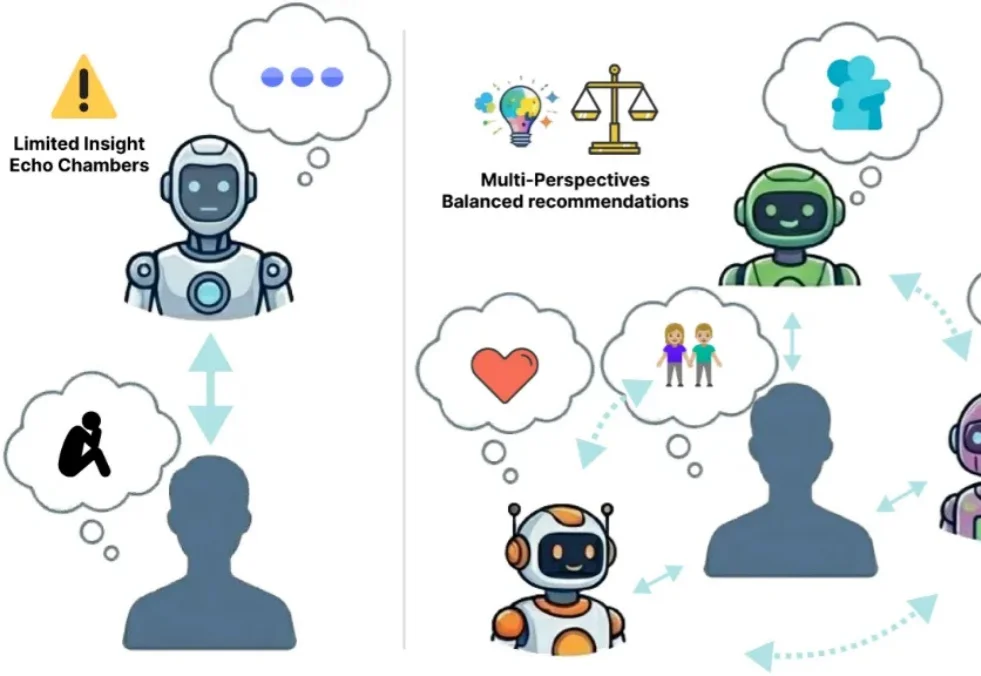
想象一下,你向几个 AI 倾诉最近的压力。
AI 的下一次突破将从何而来?业界大佬们一两年前就已给出判断。
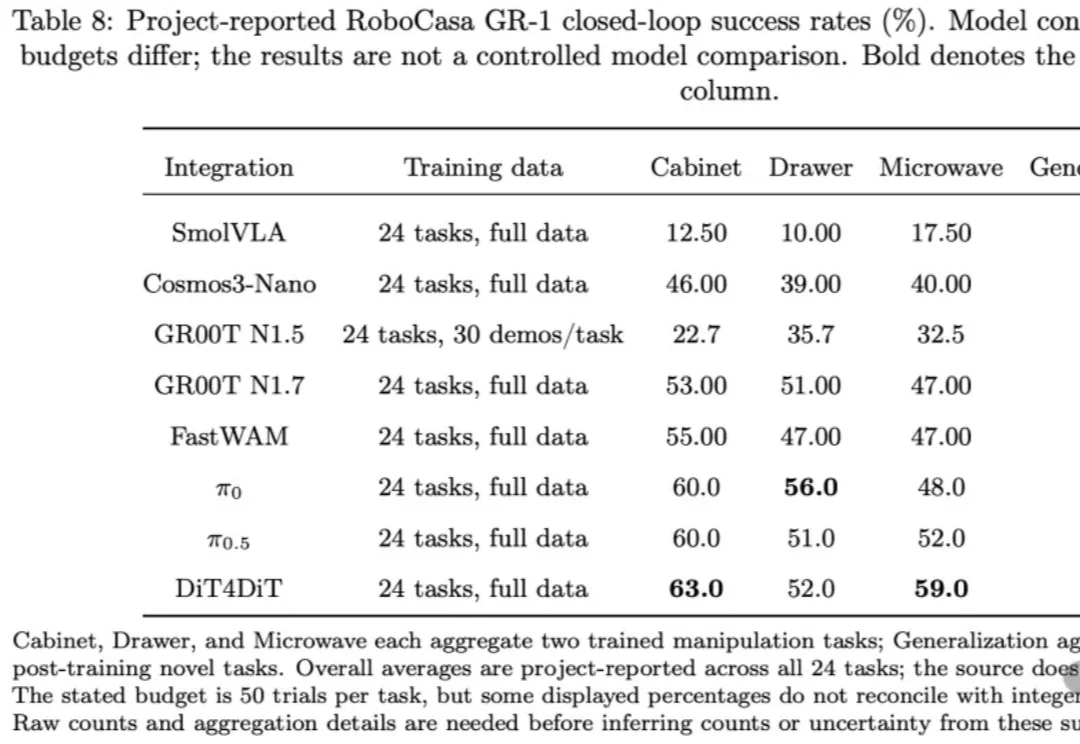
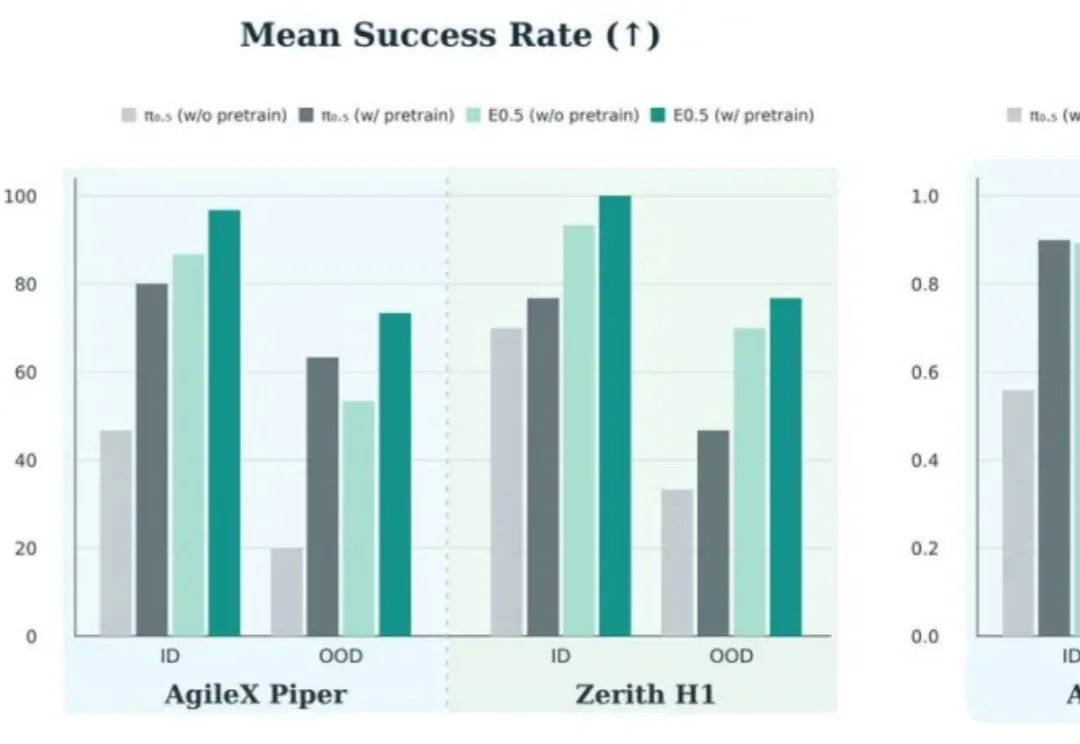
什么时候是具身智能的ChatGPT时刻?
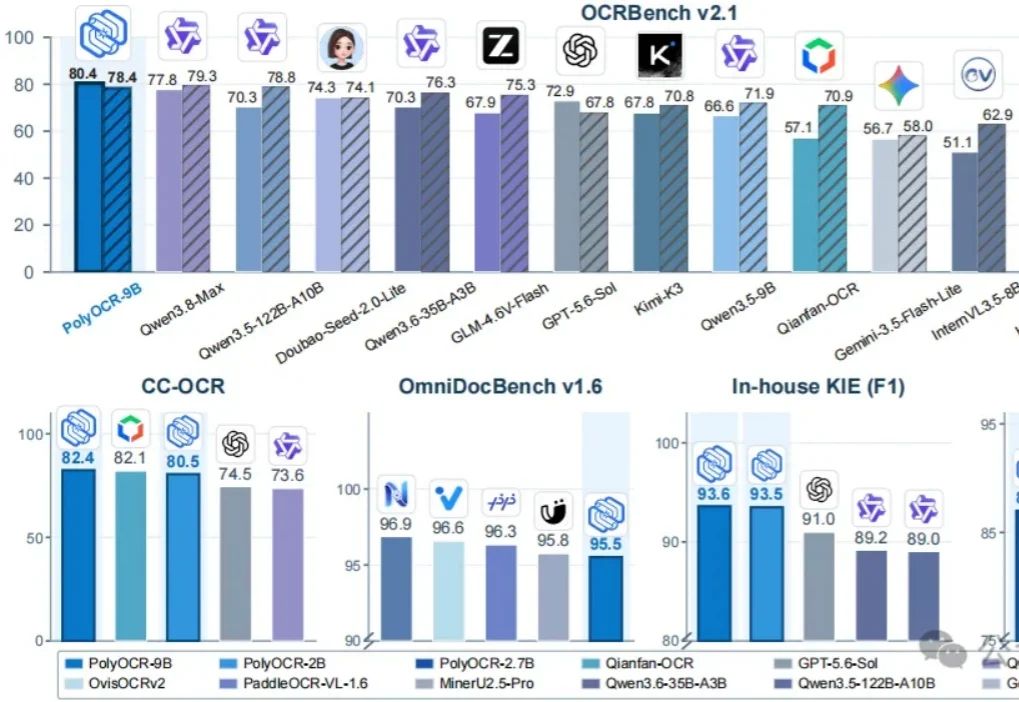
随着多模态大模型越来越强,OCR的短板反而逐渐明显。
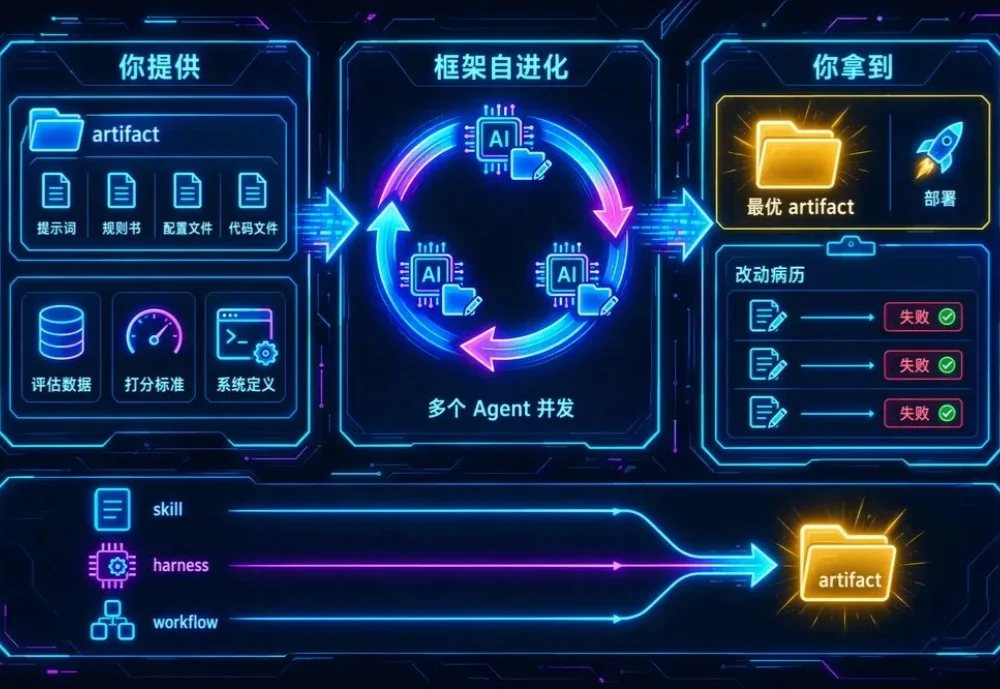
每个做 AI 系统的人都经历过这个阶段:效果上不去,又不知道往哪使劲——读轨迹、改 prompt、调配置,靠人一轮轮试,一试就是好几天。
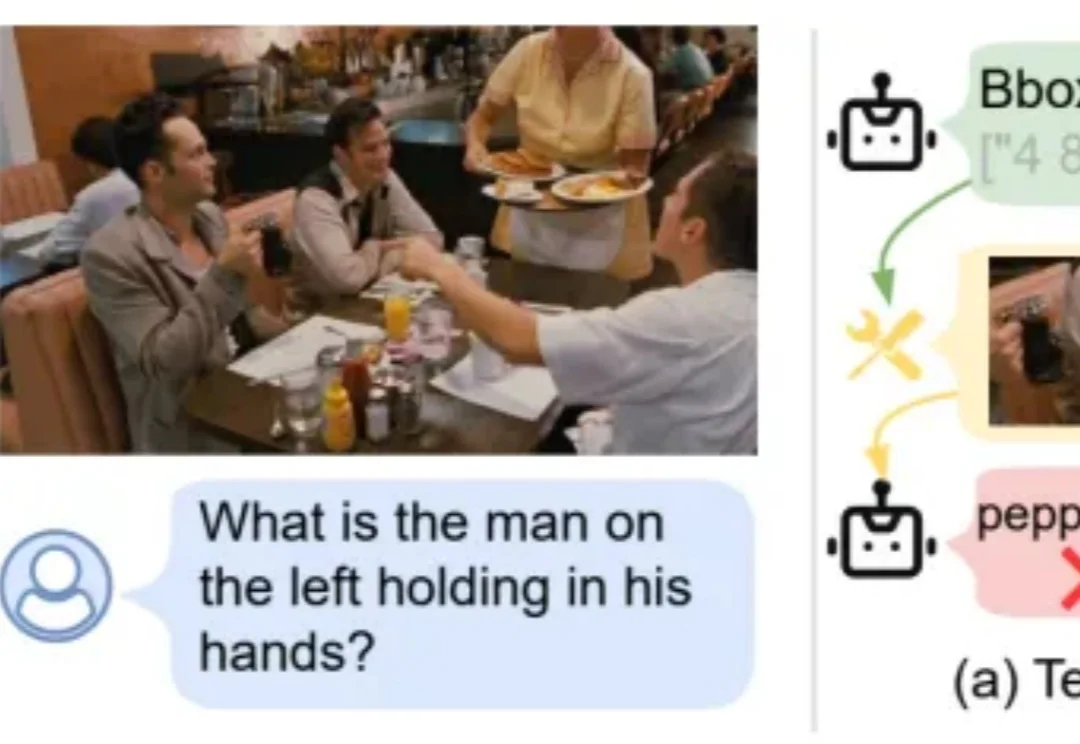
一张高清照片中,远处的手提包是什么颜色?一页票据里,某项费用到底是多少?面对这些问题,多模态大模型常常需要先找到相关区域,再放大查看。但如果第一步就框错了位置,后面的推理也可能跟着出错。视觉思维链让模型能够边看边想、调用工具寻找证据。不过,许多方法仍然像生成句子一样,把边界框坐标逐个写成文本 token。连续的空间位置,为什么要通过离散文字来表达?
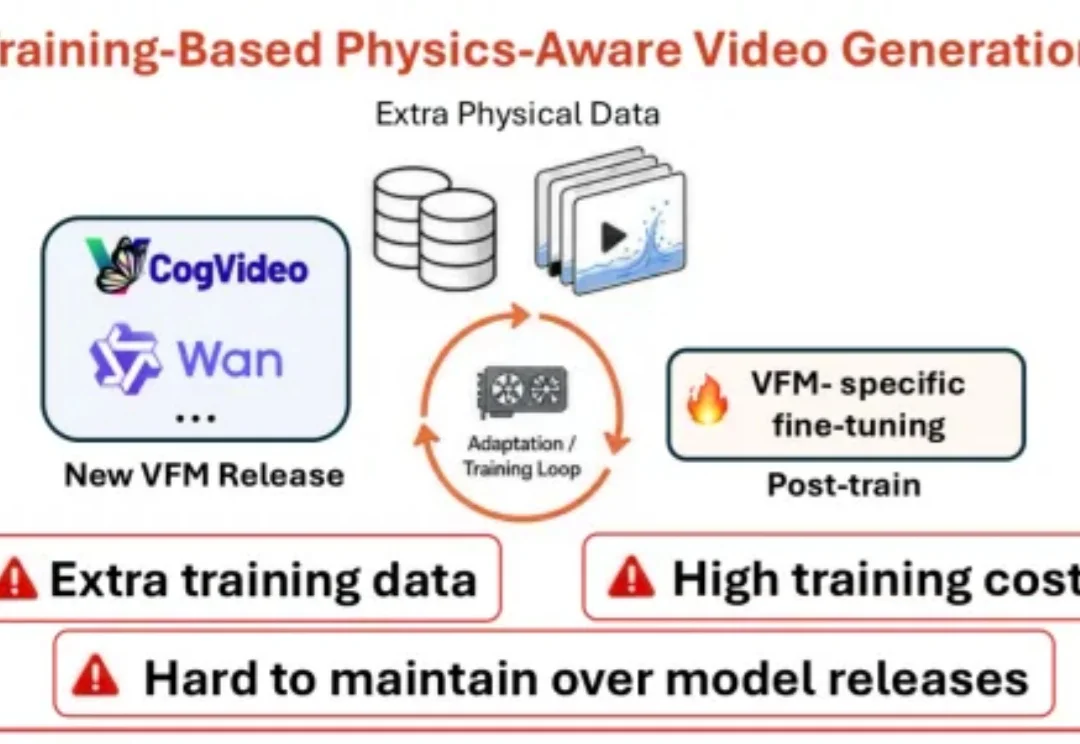
一颗梨在液体中快速旋转,周围的液体应该随之流动、飞溅;一个物体撞向水面,液体也应该产生与碰撞相对应的响应。
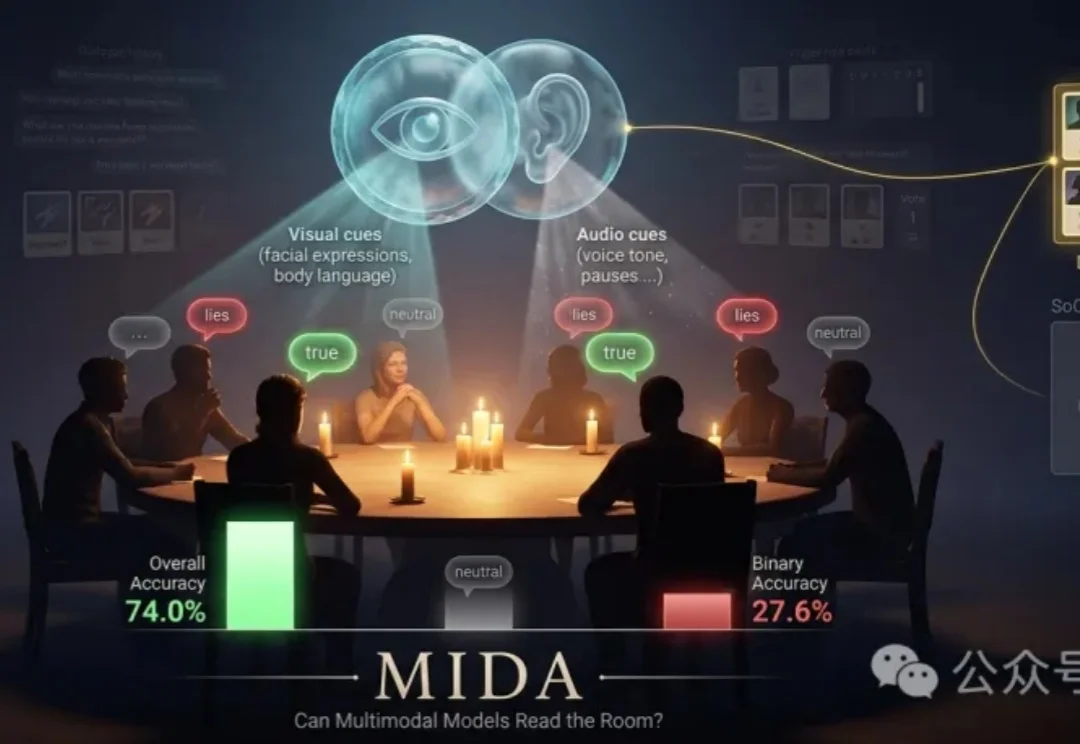
人类说一句「我不是狼」,多模态大模型既能看到表情,也能听见声音。但它真的知道这句话是真是假吗?
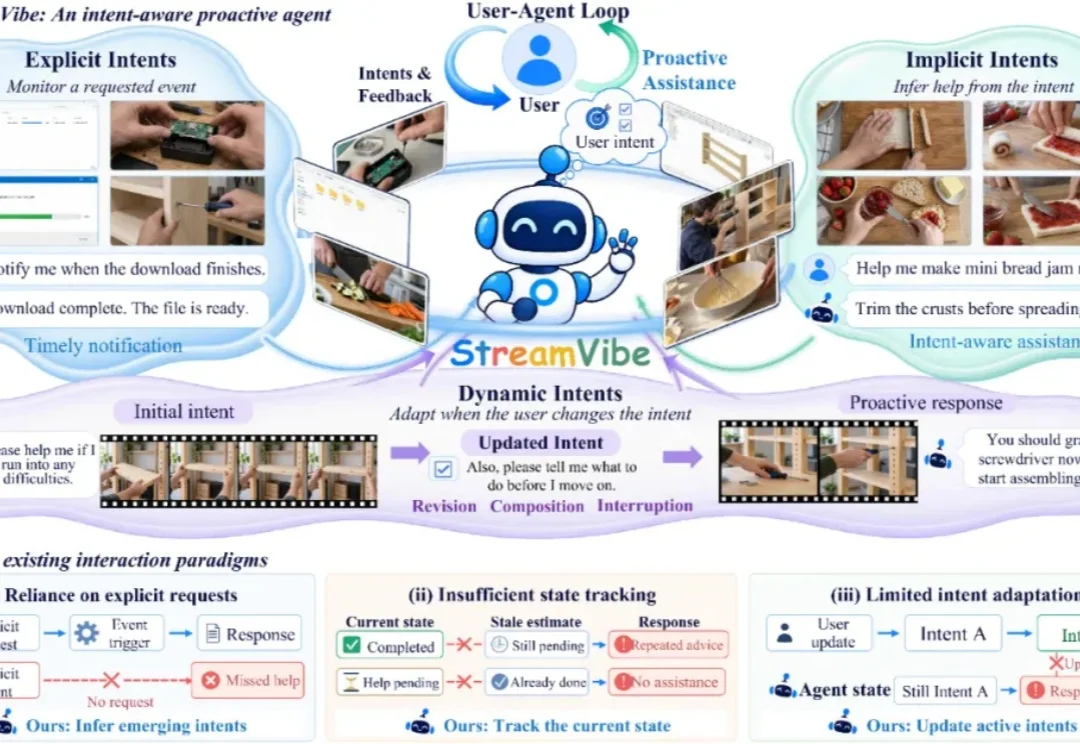
近期,Meta 的 Muse、OpenAI 的 Dot 等产品相继推出,让 Personal Agent(个人智能体)再次成为大模型领域的关注焦点。相比传统的对话助手,这类 Agent 不再局限于回答问题,而是能够结合用户的个人背景、历史记忆与应用上下文,主动执行任务并持续推进长期目标。一个更具主动性、能够长期陪伴用户的 AI 助手,正在逐渐成为现实。
「朋友马上来家里做客,帮我准备一下。」
计算复杂性理论要变天了。
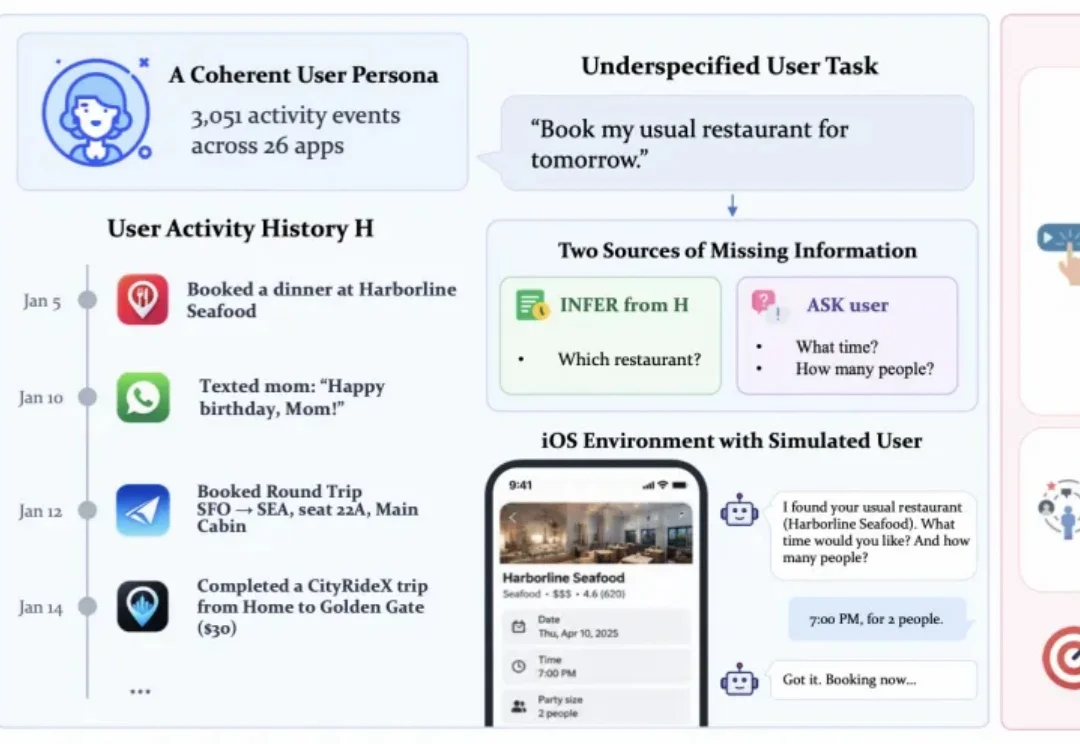
Personal Agent 目前已经能够独立完成许多复杂操作,但在决策时仍面临一个问题:什么时候应该直接推断,什么时候需要向用户追问。
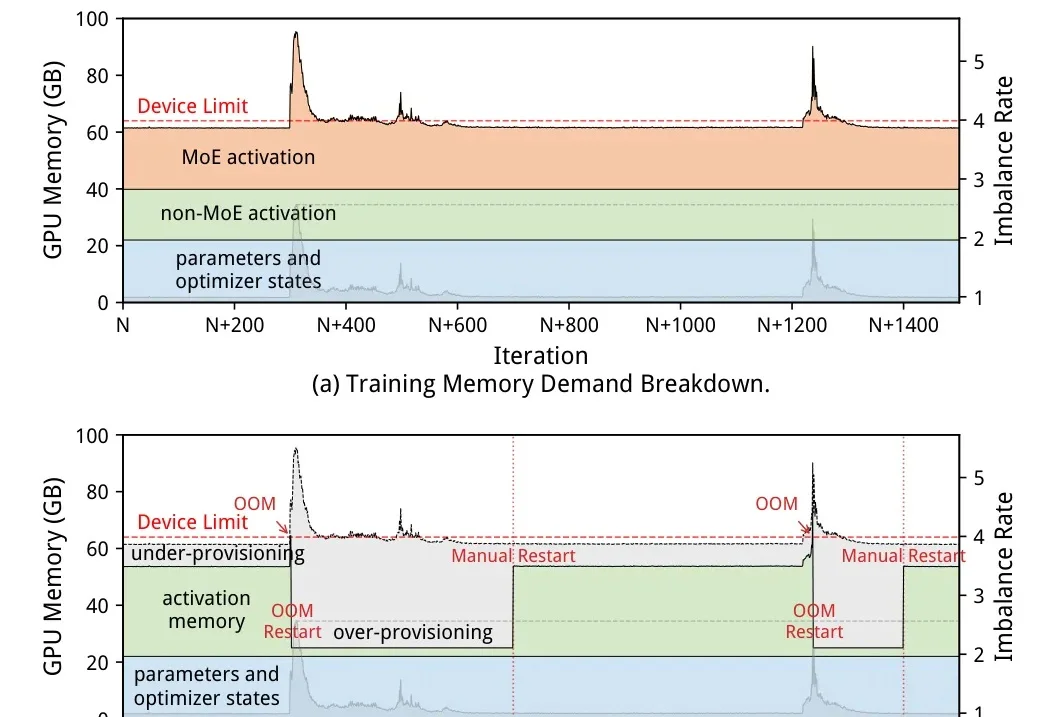
大模型训练已经跑到万卡集群规模,显存始终是那道隐形的门槛。
家庭不需要万能机器人。
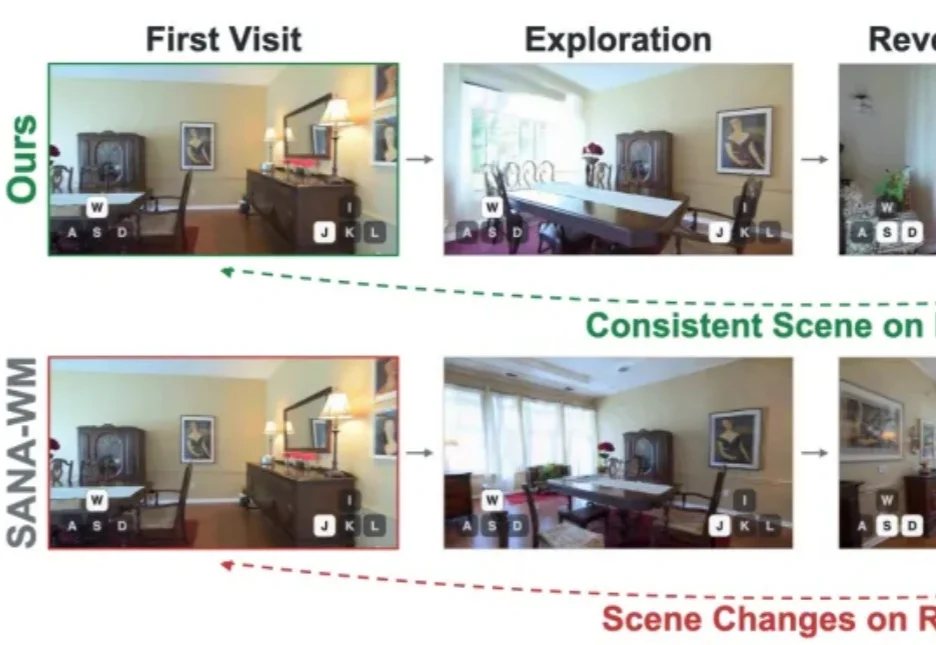
近两年,视频世界模型(video world model)成为生成式 AI 最受关注的方向之一。只需给定一张参考图和一段场景描述,模型就能根据用户输入的相机位姿或控制指令,逐帧生成出一个可以自由漫游的虚拟世界。
传统抗体发现通常依赖动物免疫,或从大规模抗体文库中“地毯式搜索”。
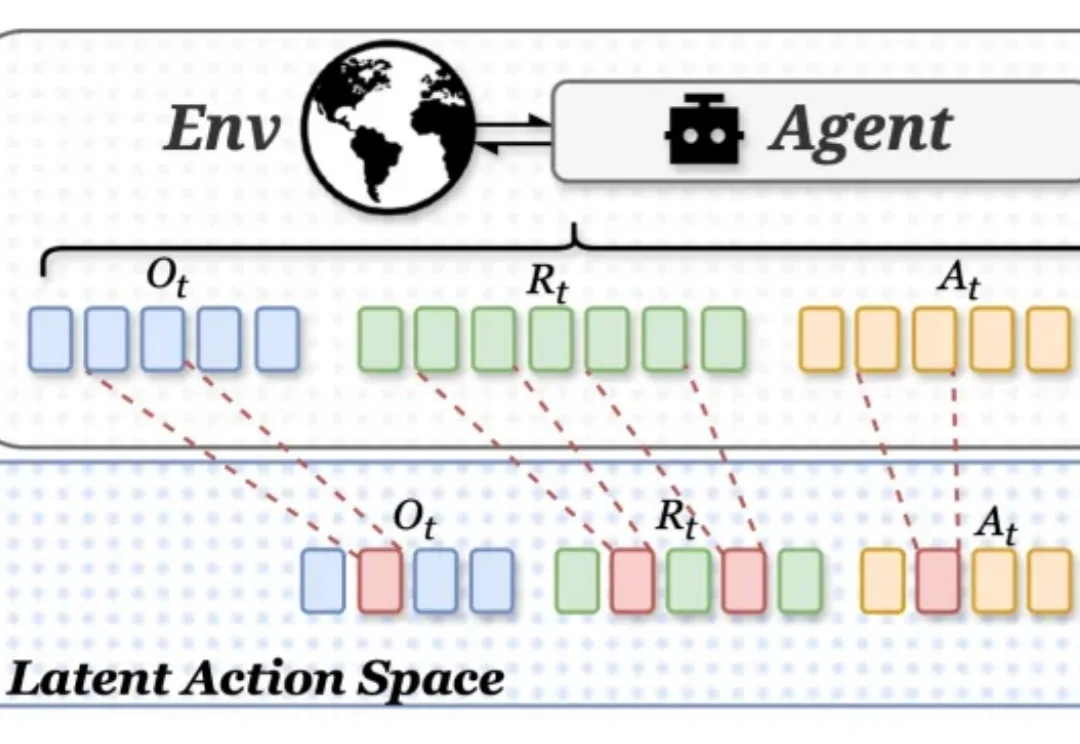
大模型Agent正在从简单问答,快速走向搜索、代码生成、网页操作和多轮工具调用。
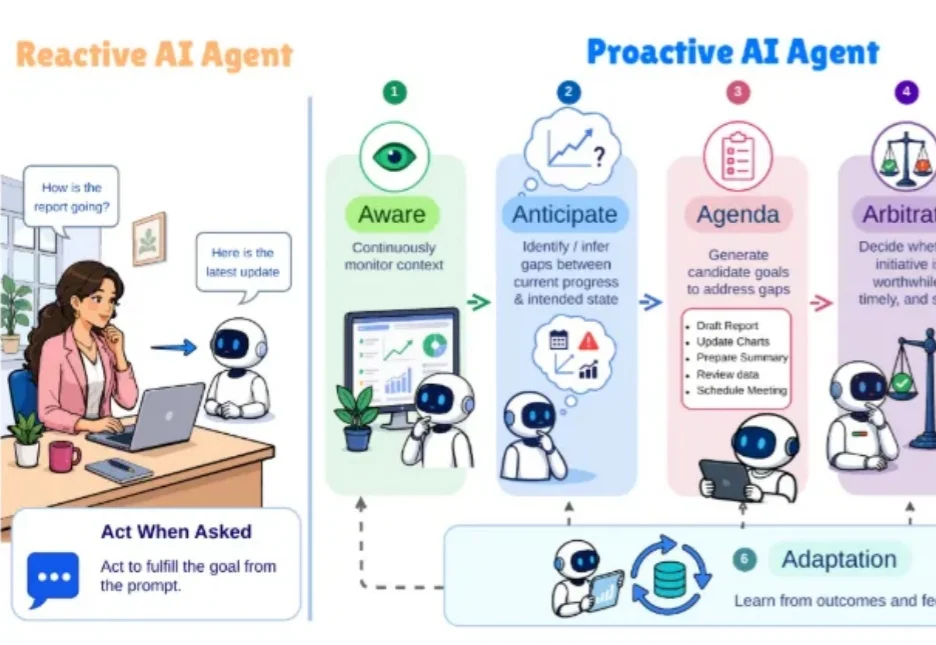
早在 1995 年,Michael Wooldridge 等学者便在智能体研究的代表性论文《Intelligent Agents: Theory and Practice》中,提出了智能体的四项核心特征:反应性(Reactivity)、社会能力(Social Ability)、自主性(Autonomy)和主动性(Proactiveness)。
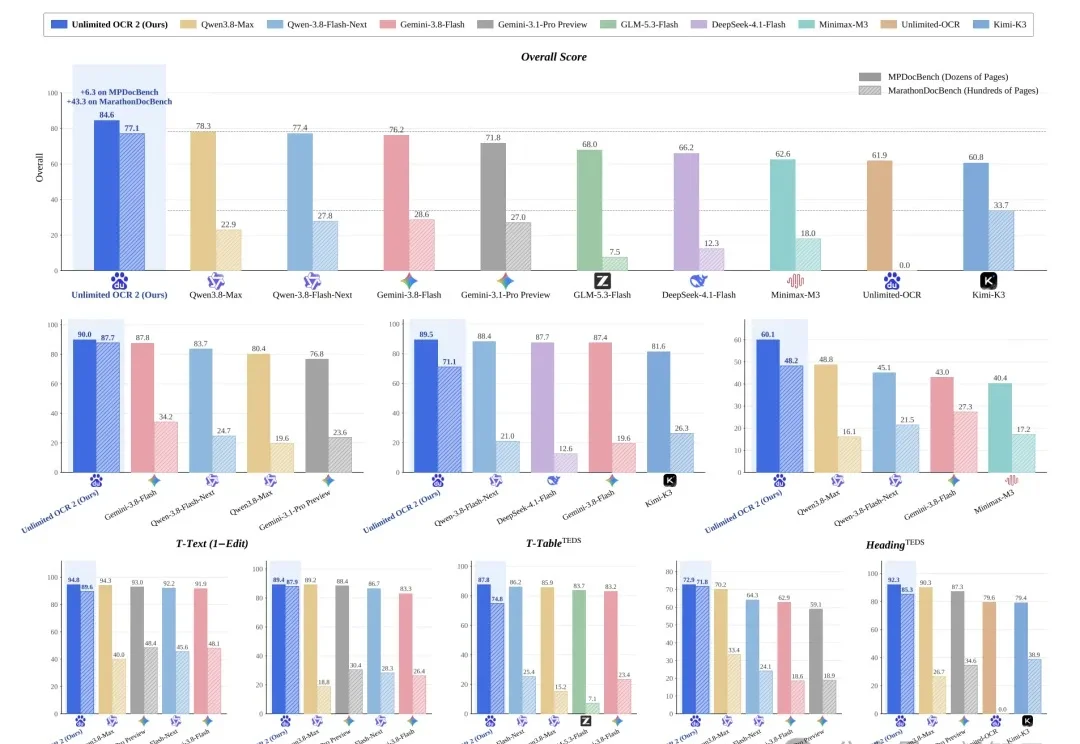
曾获LeCun转发推荐、狂揽1,000万下载的百度开源神作,又杀回来了!
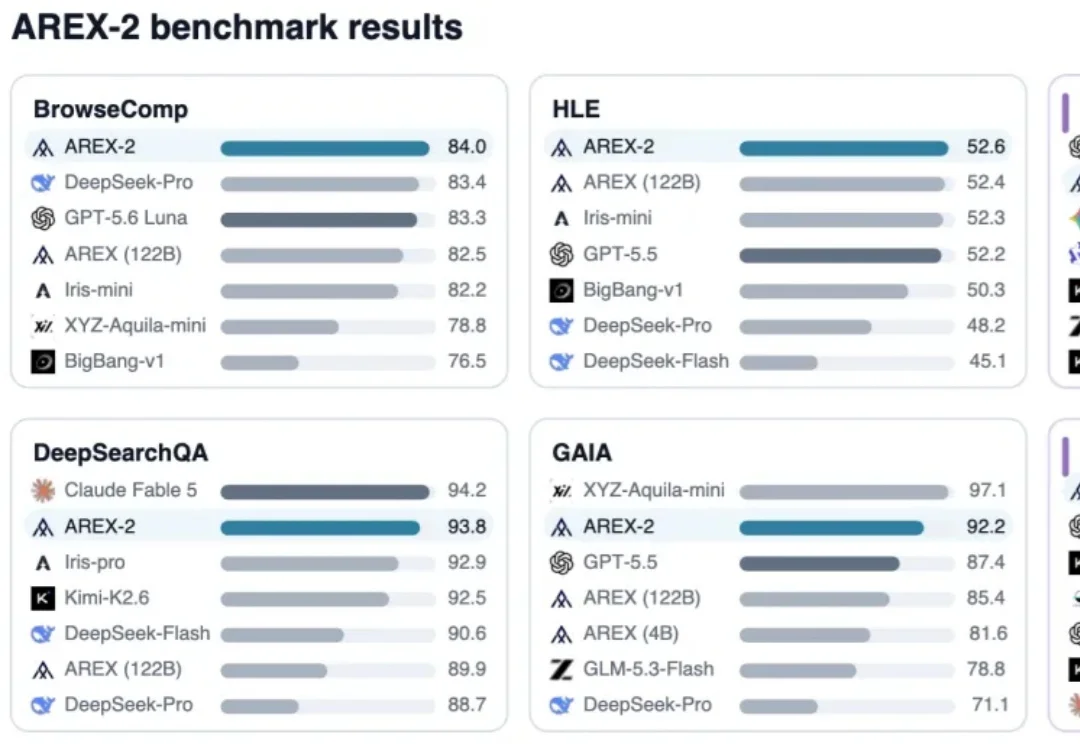
当模型学会持续迭代改进算法,便推开了通往智能自主进化的大门。近日,由来自智源研究院、中国科技大学、中国人民大学等多个机构的研究人员组成的 AREX 研究小组发布 AREX-2 模型。
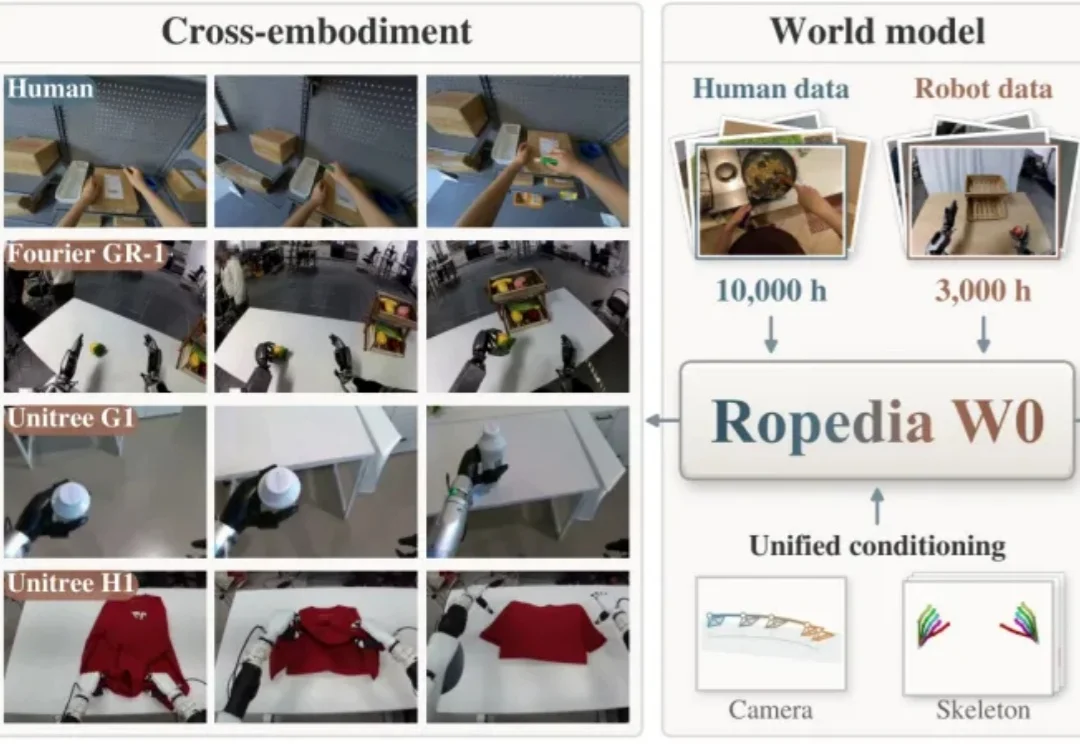
第一视角视频越来越多,研究人员怎样把这些记录变成能够改善机器人能力的训练信息?
把模型部署到昇腾 NPU 上,计算逻辑确定之后,还有一道难题:怎样让底层实现充分利用硬件?同一个注意力计算,分块、搬运、并行和同步方式不同,运行时间就可能明显不同。
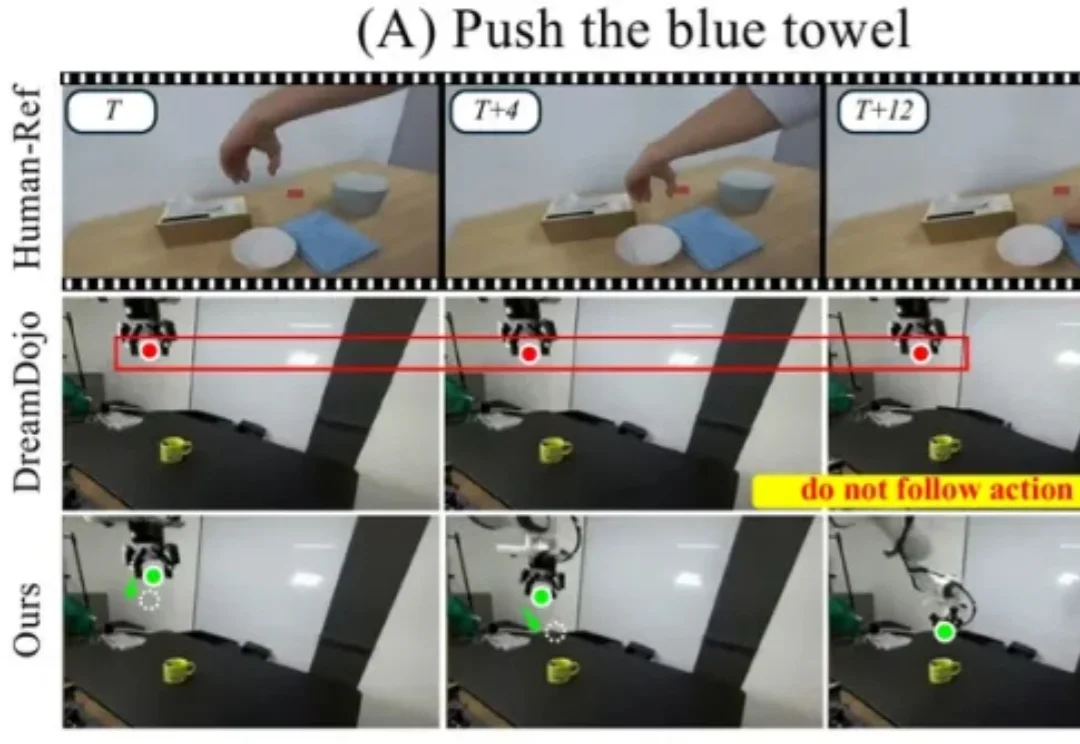
基于预训练的 Cosmos-Predict2.5-2B,SkeLAM 使用总计约 10 小时的机器人交互数据进行训练。在人手到机器人的迁移实验中,输入换成人类演示,生成视频中的机械臂仍然呈现出与演示对应的运动方向。迁移时模型参数全部冻结,没有针对这些演示额外微调。
清华大学、英伟达等机构联合推出全球首个流式交互视频生成评测榜单StreamEval,以300个用例评测38个模型,揭示当前模型在连续指令执行和状态一致性方面仍存明显短板。