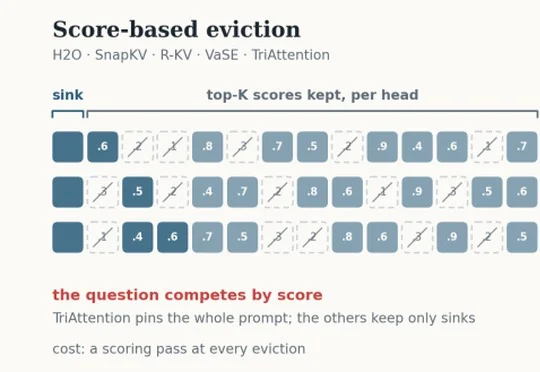
KV Cache不用「精挑细选」?随机删除媲美最强基线,推理吞吐最高再提43%
KV Cache不用「精挑细选」?随机删除媲美最强基线,推理吞吐最高再提43%大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每
来自主题: AI技术研报
9046 点击 2026-09-20 11:05

 搜索
大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每
路透社刚发了一条独家:Anthropic 正在考虑提前发布新模型。看来 GPT-6 Astra 真的把它打疼了。OpenRouter 统计显示,Astra 上线才两周多,已经吃掉约 13% 的企业 AI 支出份额,而 Anthropic 的 Fable 系列只有 8%。
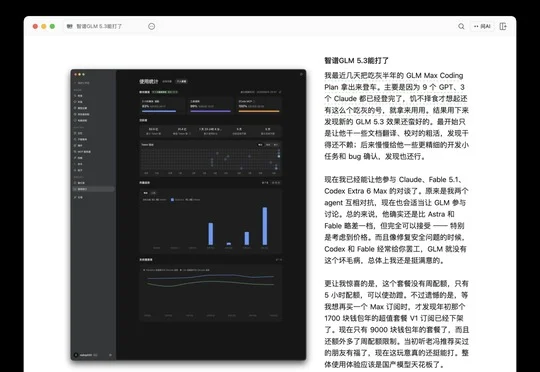
智谱 ZCode 3.12.3 客户端被发现静默将用户完整代码仓库(含全量 .git 历史)加密打包上传至阿里云 OSS,加密密钥仅由服务端持有,且不存在可关闭该行为的开关,其行为超出了隐私政策所述"通过对话提交"的范围。
OpenAI在停售8天后悄然恢复ChatGPT Pro 20X购买资格,但仅限过去30天内曾使用过该套餐的老用户以"一次性回归"方式重新激活,新用户仍被拒之门外。
Anthropic的Claude在不到四周内优化了30多个开源生物分子模型,AItonomy Foundation同期发布开源项目ScienceIDE,将科学代码库转化为可执行可验证的AI科学家训练环境。
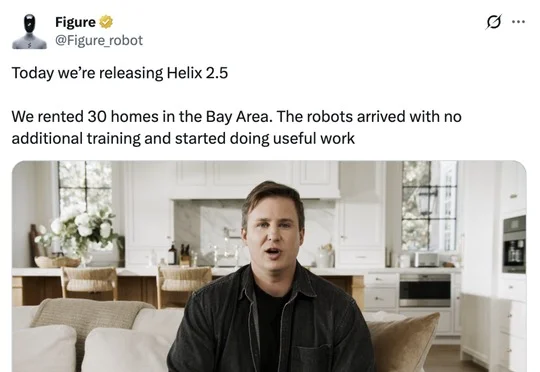
Figure AI发布新一代模型Helix 2.5,在30个从未采集过数据的湾区民宅中进行零样本测试,420次试验成功237次,零样本成功率达56%,较未经Index预训练的策略的9%提升超过522%。
NeoCognition发布ApprenticeBench评测,将Agent放入模拟建筑公司像新员工一样处理应付账单,结果Fable 5.1以72%通过率超过表现最好的人类测试者的51%,但每张账单成本约为人类的2.5倍,同期Opus 5仅获36%。
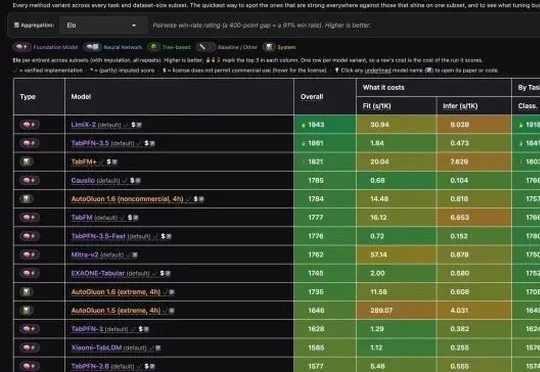
稳准智能团队发布的结构化数据基础模型LimiX-2凭借400M参数在TabArena、TALENT、BCCO等国际主流基准测试中拿下多项第一,断层领先谷歌TabFM、Amazon Mitra及SAP TabPFN-3.5等模型。
YC 2026 夏季批次的 236 家公司中,91% 与 AI 相关,创业重心从应用层向算力、芯片、训练环境和物理世界显著下沉,Agent 已淡出主叙事,取而代之的是算力建设、推理成本优化、AI 原生服务公司和实体硬件的爆发式增长。
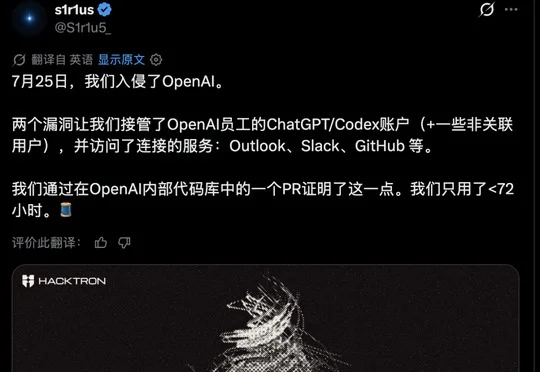
安全研究团队HacktronAI利用Anthropic的Claude Opus 4.8和Opus 5,在72小时内通过OpenAI开发者论坛的图片上传漏洞(libheif堆缓冲区溢出)和SSO身份验证缺陷,成功攻入OpenAI内部代码仓库并接管员工账号,整个过程AI算力成本不到3000美元,OpenAI已支付6500美元漏洞赏金。