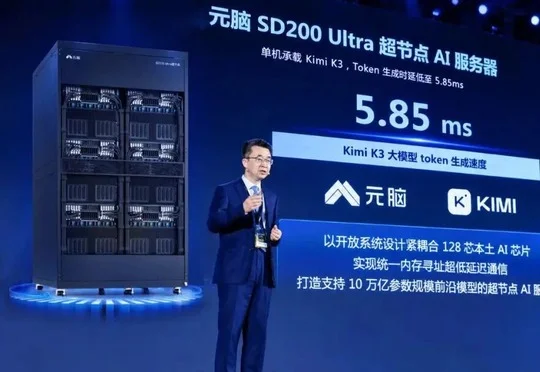
硅谷扔出“巨内核”,中国团队祭出“超级算子”,万亿参数模型效率战打响!
硅谷扔出“巨内核”,中国团队祭出“超级算子”,万亿参数模型效率战打响!浪潮信息在AICC 2026发布搭载128芯本土AI芯片的元脑SD200 Ultra超节点AI服务器,通过超级算子融合技术将2.8万亿参数Kimi K3的Token生成时延降至5.85毫秒,与海外Inferact以"巨内核"路线共同打响万亿参数模型推理效率战。
来自主题: AI资讯
9725 点击 2026-10-01 13:15

 搜索
浪潮信息在AICC 2026发布搭载128芯本土AI芯片的元脑SD200 Ultra超节点AI服务器,通过超级算子融合技术将2.8万亿参数Kimi K3的Token生成时延降至5.85毫秒,与海外Inferact以"巨内核"路线共同打响万亿参数模型推理效率战。
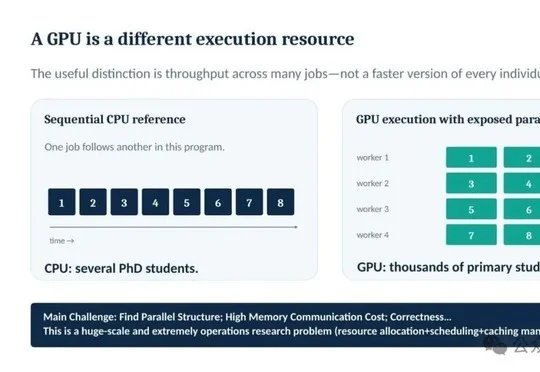
港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。
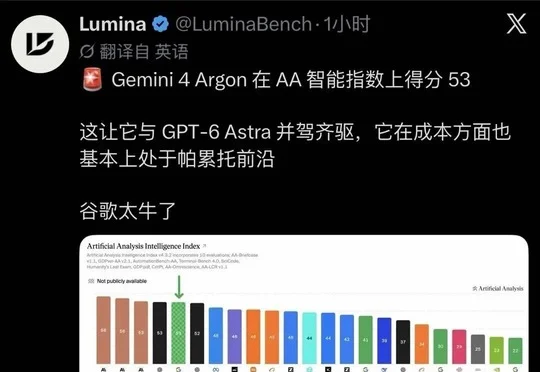
谷歌正式发布前沿AI模型Gemini 4 Argon,其在Text Arena排名第一、Vals RSI指数超越GPT-6 Astra达30%,单任务成本仅1.99美元,单次输出上限升至100万Token,并在谷歌内部以Rust安全语言重写了80万行系统内核代码。
MiniMax于9月27日上线Flash级别模型M3.1-Flash-Preview,本文通过试衣间项目改造、机器人视频拆解、北京夜光可视化和A股市场观测台四个实测任务,将其与DeepSeek V4.1 Flash和GLM-5.3-Flash对比,结果显示M3.1速度仅次于DeepSeek但成本最低,成为Flash赛道上DeepSeek的新对手。
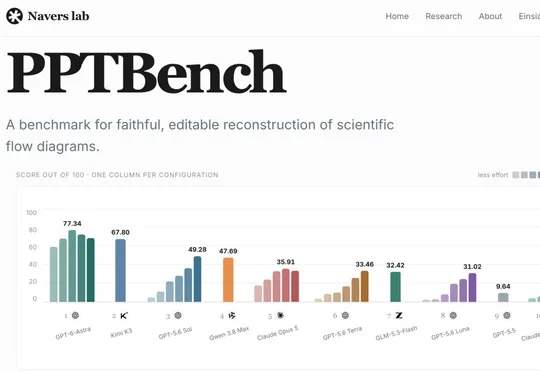
Einsia AI旗下Navers Lab发布视觉编程基准PPTBench,包含500个科学流程图任务并测试10个模型36种配置,GPT-6 Astra High以77.34分居首,但64.03%的结果因流程语义错误被拒,表明视觉理解仍是当前主要瓶颈。
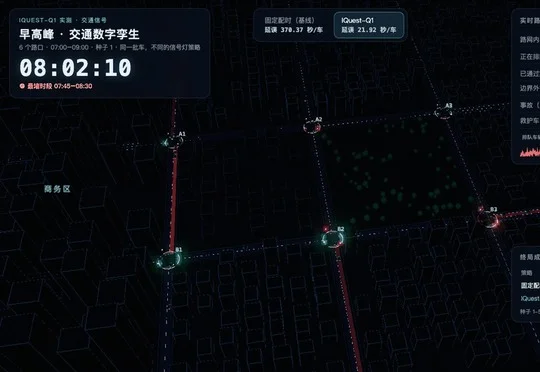
至知创新研究院开源320B大模型IQuest-Q1,该模型在代码生成、安全漏洞挖掘等评测中表现优异,并能自主排查训练Bug,在交通调度、仓库管理、电梯调度等真实场景中展现出强大的任务解决能力。
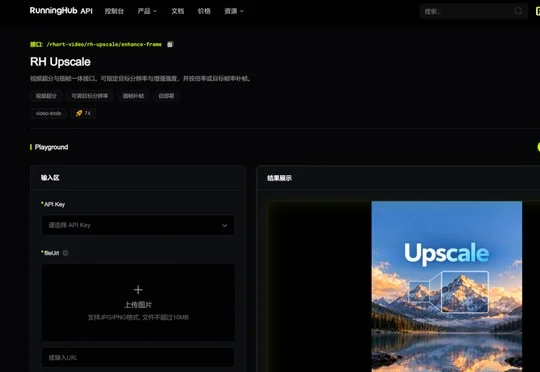
海马云旗下RunningHub发布自研生成式视频超分模型RH Upscale,在13组横向评测中以综合得分0.539位列第一,通过内容保真约束下的时空联合重建与五档模式设计,解决视频超分中"放大而不改内容"的难题。
Meta发布的个人AI助手应用Muse凭借云端虚拟机执行任务的能力,上线10天登顶美国App Store免费总榜,推动Meta股价单日大涨11.43%,同时引爆Personal Agent赛道,引来OpenAI、Manus及字节跳动等公司纷纷跟进布局。
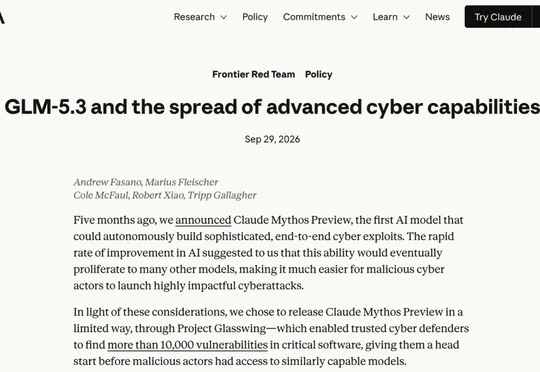
Anthropic发布网络安全评估报告指出,智谱AI的GLM-5.3已具备自主开发端到端网络漏洞利用程序的高级网络攻击能力,但其内置安全护栏极易被简单方法绕过或移除,导致恶意攻击者可轻易获取该能力。
Google面向符合条件的大学生推出免费领取一整年Google AI Pro或Google AI Plus的学生活动,美国学生可获原价约240美元的Pro方案,140多个国家和地区学生可获原价约60美元的Plus方案,活动通过gemini.google/students官方页面领取,有效期至2026年12月31日。