NeurIPS'26 | 港科大:从CPU到GPU,AI能否真正加速全流程?
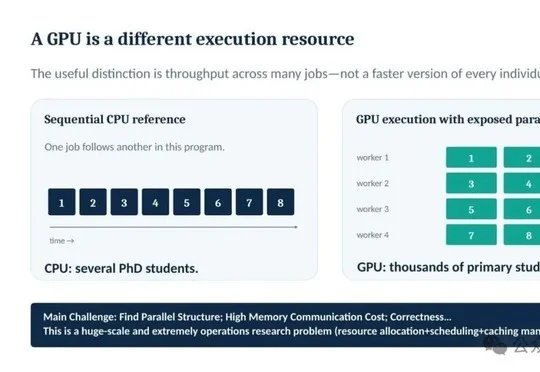
NeurIPS'26 | 港科大:从CPU到GPU,AI能否真正加速全流程?港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。
搜索
港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。
MiniMax于9月27日上线Flash级别模型M3.1-Flash-Preview,本文通过试衣间项目改造、机器人视频拆解、北京夜光可视化和A股市场观测台四个实测任务,将其与DeepSeek V4.1 Flash和GLM-5.3-Flash对比,结果显示M3.1速度仅次于DeepSeek但成本最低,成为Flash赛道上DeepSeek的新对手。
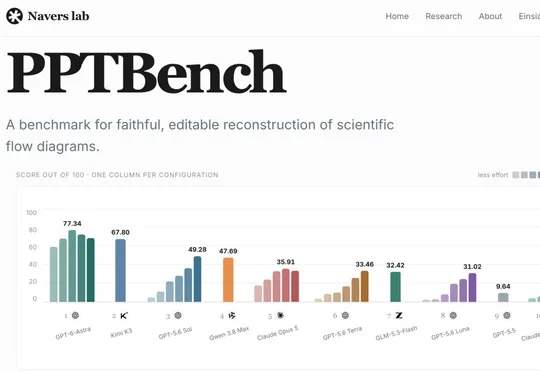
Einsia AI旗下Navers Lab发布视觉编程基准PPTBench,包含500个科学流程图任务并测试10个模型36种配置,GPT-6 Astra High以77.34分居首,但64.03%的结果因流程语义错误被拒,表明视觉理解仍是当前主要瓶颈。
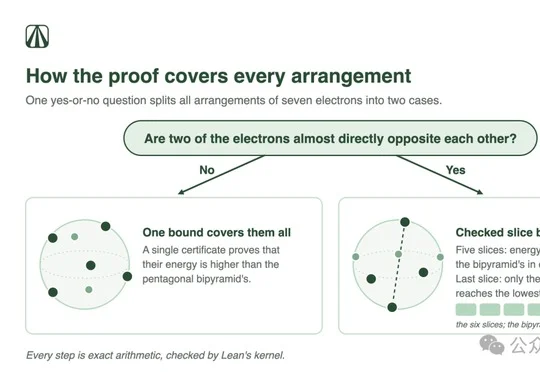
10个Claude Sonnet 5.5智能体通宵15小时、互发1270条消息并写出17895行Lean代码,在无人类介入的情况下完成悬置122年的汤姆逊问题N=7形式化证明,且通过Lean内核与nanoda双重验证。
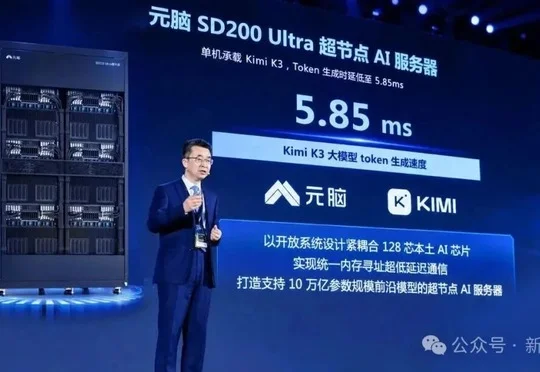
Inferact开源TPU巨型算子与浪潮信息发布元脑SD200 Ultra超节点服务器,两家公司分别用谷歌TPU v7和128颗本土AI芯片,通过算子融合让Kimi K3推理性能提升3倍以上,且浪潮信息让K3自主编写超级算子。
IDC与浪潮信息联合发布的《2026年中国人工智能计算力发展评估报告》显示,全球活跃企业Agent数量预计将从2026年的7940万个增长至2030年的22.16亿个,带动Token消耗和算力需求爆发式增长,AI基础设施正围绕Agent长链路运行进行系统性重构。
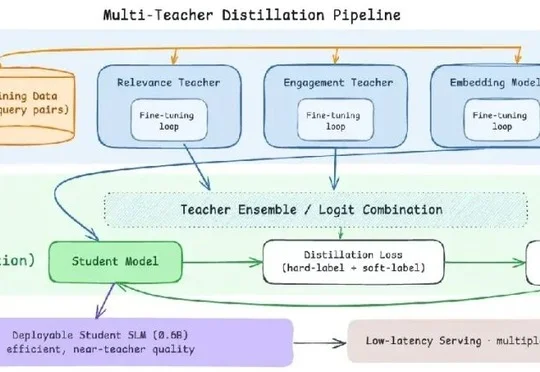
LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
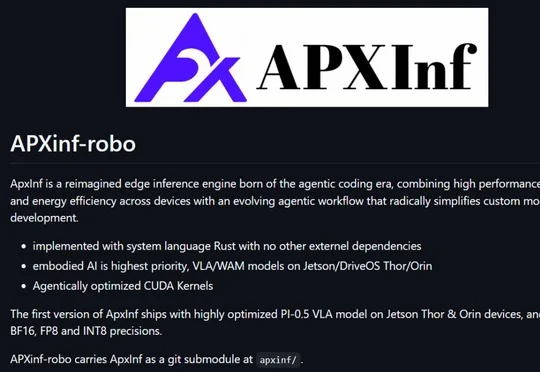
清华大学联合无问芯穹与上海交通大学开源了面向具身模型的端侧推理引擎APXInf,通过全栈优化在Thor芯片上将π0.5推理速度提高约10.7倍,并引入可由Agent执行的工程化流程以适配模型的持续迭代。
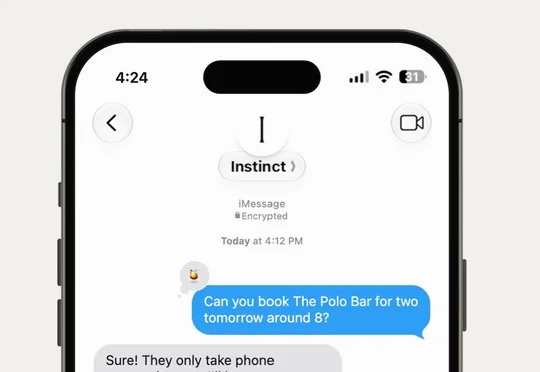
美国个人AI Agent创企Instinct完成10亿美元新一轮融资,投后估值达100亿美元(约合人民币671亿元),较一个月前估值提升4倍,资本市场押注其能够代替用户操作手机和电脑完成日常事务的个人AI助手业务。
开源版Jev训练保姆级教程发布,基于Qwen3-0.6B底座在本地单卡环境完成数据下载、案例级切分、全参数微调、温度校准及本地接口部署全流程,600步训练后在2000道决策题测试集上达到78.05%准确率。