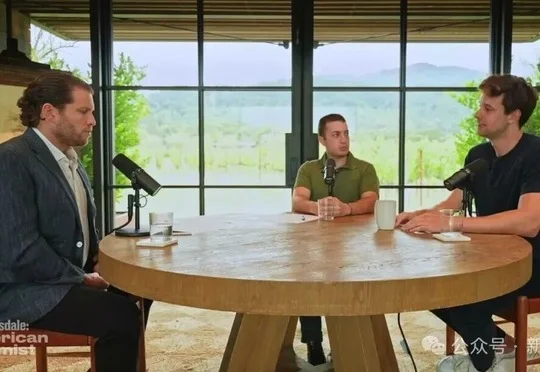
AI几年内或超越所有人类!Claude核心研究员预测
AI几年内或超越所有人类!Claude核心研究员预测Anthropic强化学习技术负责人Sholto Douglas预测,能力等于甚至超过所有人类的AGI可能在未来几年内出现,2028年AI年度资本开支或达4万亿美元,而研究员Nick Marwell对AI无需人类搭档后的后果表示紧张。
来自主题: AI资讯
10228 点击 2026-10-07 15:17

 搜索
Anthropic强化学习技术负责人Sholto Douglas预测,能力等于甚至超过所有人类的AGI可能在未来几年内出现,2028年AI年度资本开支或达4万亿美元,而研究员Nick Marwell对AI无需人类搭档后的后果表示紧张。
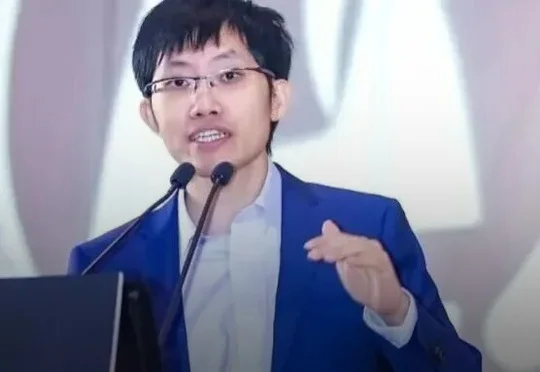
据彭博社报道,DeepSeek即将敲定至少800亿元人民币的新一轮融资,腾讯和宁德时代承诺出资金额居前,该轮融资拟为2027年初IPO铺路,但最终条款仍未确定。
OpenAI开启Codex“疯狂28天”计划,首日宣称将GPT-6 Astra和GPT-6.1 Sol默认推理速度提升约50%至50TPS,但用户实测低于预期,叠加ChatGPT测试广告、欧盟文本隐形水印及订阅调整引发质疑。
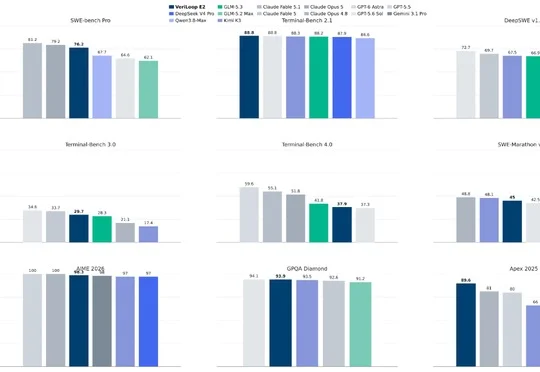
清华团队开源以Qwen 3.8-27B为基础模型的VeriLoop E2,通过VGR外部证据门控实现可验证状态提交,并取得黎曼猜想临界线零点比例下界67.350003708785593%的严格有限维证书,但上游形式化桥接尚未完成。
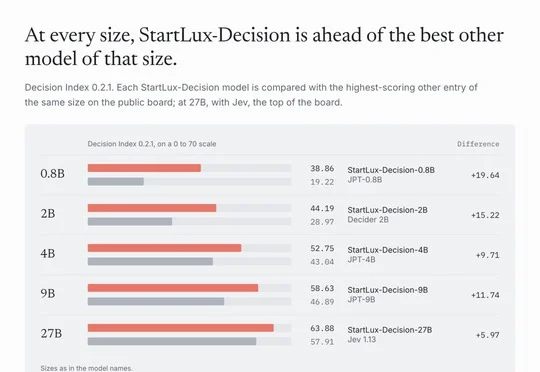
StartLux发布完全开源的StartLux-Decision,其27B版本在Decision Index 0.2.1的38项基准中有31项超过Jev 1.13,并以63.88分升至公开榜首。
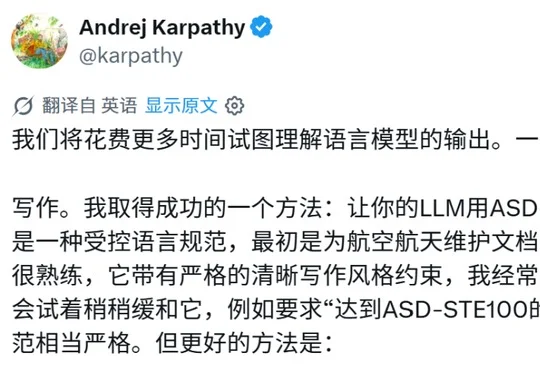
Karpathy建议让LLM采用约80%的ASD-STE100规范,并生成图示、HTML交互页面或定制讲解视频,将输出转化为更清晰易懂的软件产物。
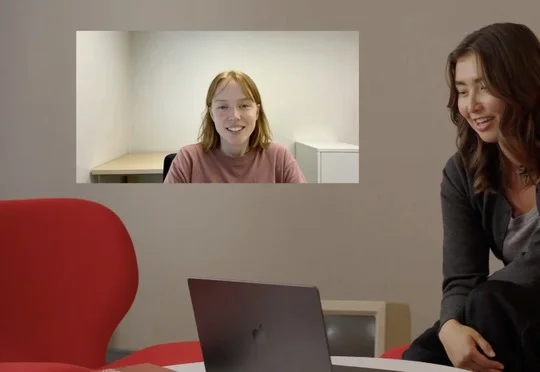
Tavus发布全双工视频到视频交互模型Griffin,可实时生成720p数字人并理解停顿、表情与动作,在一分钟测试中让54名参与者近48%误以为在与人交谈,但该结果未独立验证且模型尚未公开。
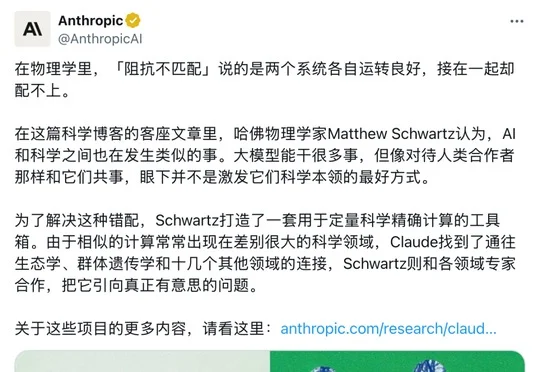
哈佛物理学家Matthew Schwartz用Claude和开源工具BootLoops处理可验证的科研任务,90天产出横跨18个学科的36篇论文初稿,并主张由人挑题、追问和验收,让AI发挥辅助而非替代科学家的作用。
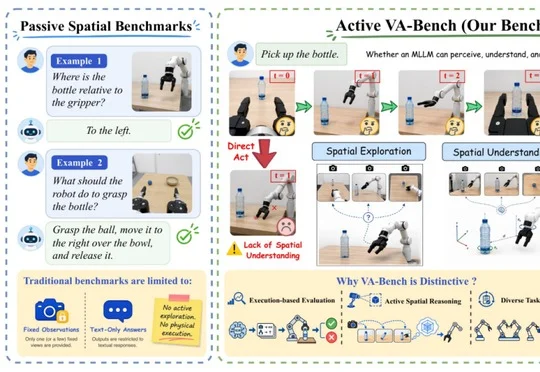
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
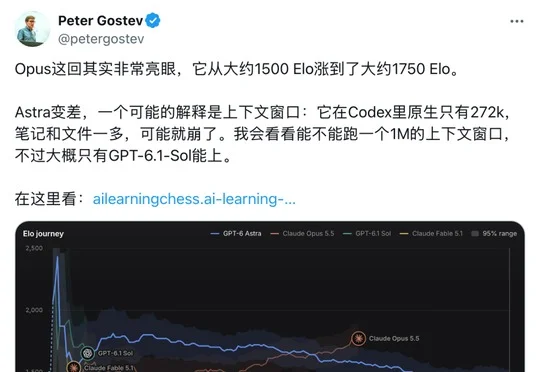
大模型竞技场Arena让Claude Opus 5.5与GPT-6 Astra各自练棋200局,前者估算评分从约1500升至1760,后者从第29盘的1810降至1400,显示AI仅靠记录与复盘提升能力的表现并不一致。