EMNLP 2026|「AI把数字说歪」,官方AI审稿现场演示了一遍
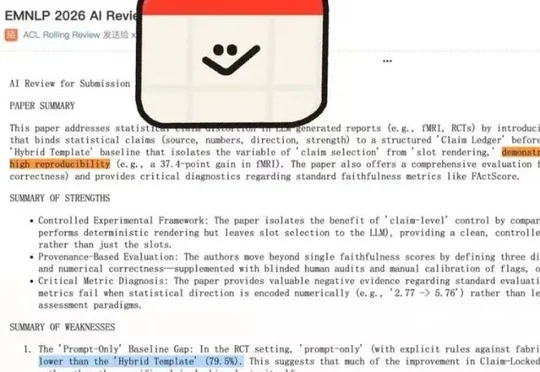
EMNLP 2026|「AI把数字说歪」,官方AI审稿现场演示了一遍EMNLP 2026录用论文提出Claim-Locked Reporting方法,针对AI审稿等场景中数字正确但方向或结论强度被改写的统计主张失真问题,通过先锁定证据支撑的主张、再由代码固定数字与方向而模型仅负责衔接,在fMRI与临床试验报告上将跨次生成数值复现率分别提升至98.5%和100%,并消除了方向反转错误。
搜索
EMNLP 2026录用论文提出Claim-Locked Reporting方法,针对AI审稿等场景中数字正确但方向或结论强度被改写的统计主张失真问题,通过先锁定证据支撑的主张、再由代码固定数字与方向而模型仅负责衔接,在fMRI与临床试验报告上将跨次生成数值复现率分别提升至98.5%和100%,并消除了方向反转错误。
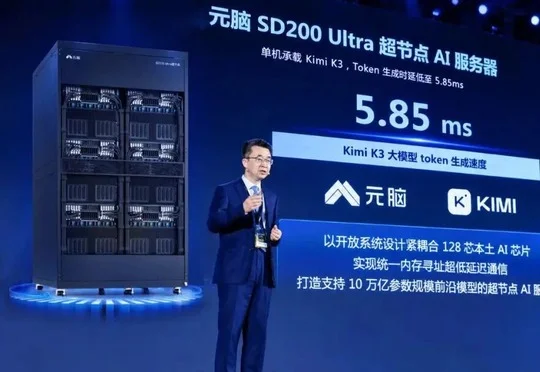
浪潮信息在AICC 2026发布搭载128芯本土AI芯片的元脑SD200 Ultra超节点AI服务器,通过超级算子融合技术将2.8万亿参数Kimi K3的Token生成时延降至5.85毫秒,与海外Inferact以"巨内核"路线共同打响万亿参数模型推理效率战。
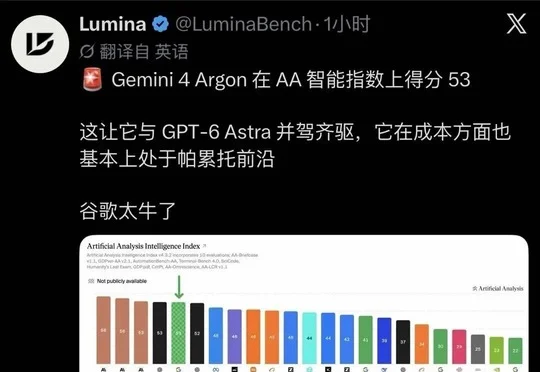
谷歌正式发布前沿AI模型Gemini 4 Argon,其在Text Arena排名第一、Vals RSI指数超越GPT-6 Astra达30%,单任务成本仅1.99美元,单次输出上限升至100万Token,并在谷歌内部以Rust安全语言重写了80万行系统内核代码。
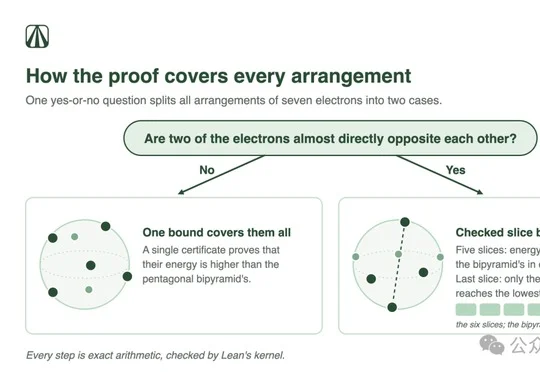
10个Claude Sonnet 5.5智能体通宵15小时、互发1270条消息并写出17895行Lean代码,在无人类介入的情况下完成悬置122年的汤姆逊问题N=7形式化证明,且通过Lean内核与nanoda双重验证。
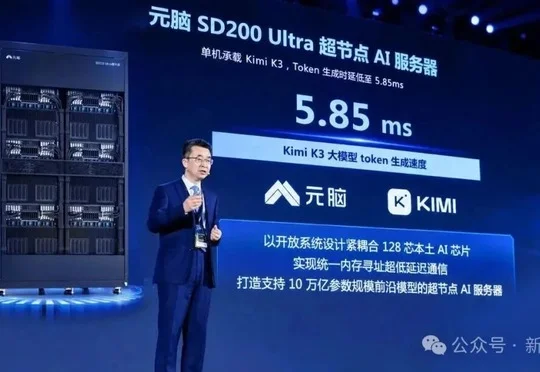
Inferact开源TPU巨型算子与浪潮信息发布元脑SD200 Ultra超节点服务器,两家公司分别用谷歌TPU v7和128颗本土AI芯片,通过算子融合让Kimi K3推理性能提升3倍以上,且浪潮信息让K3自主编写超级算子。
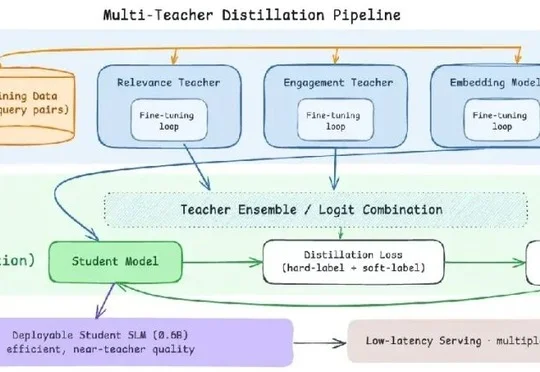
LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
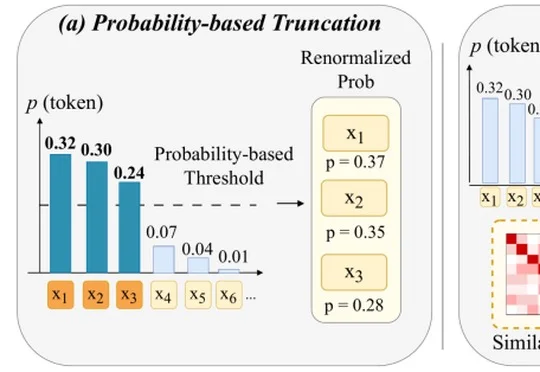
中国人民大学代文林、孟澄研究员团队提出的ME-Decoding方法被EMNLP 2026接收,该方法在解码时同时利用token概率与embedding相似度,从集合层面筛选低冗余候选token,在GSM8K和GPQA上取得所比较方法中最高的平均准确率,端到端GPU延迟仅增加约3%。
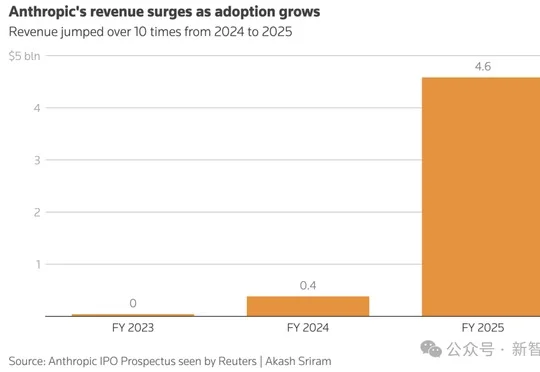
Anthropic招股书披露,其背负未来5180亿美元算力与基建长期支出承诺,2025年营收近46亿美元却净亏约420亿美元,公司正冲击或超2万亿美元的IPO估值,但客户集中度高且订单缺乏长期合同保障,能否撑住天价估值取决于收入增长能否持续跑赢算力成本。
AMD 宣布以约 82 亿美元(折合人民币约 550 亿元)全股票方式收购李飞飞创立的 World Labs,交易完成后李飞飞将出任 AMD 执行副总裁兼首席科学家,双方将围绕空间智能模型研究与算力生态展开深度合作。
开源版Jev训练保姆级教程发布,基于Qwen3-0.6B底座在本地单卡环境完成数据下载、案例级切分、全参数微调、温度校准及本地接口部署全流程,600步训练后在2000道决策题测试集上达到78.05%准确率。