最近两个月 Product Hunt 最火的 AI 产品,都在做什么
最近两个月 Product Hunt 最火的 AI 产品,都在做什么近期Product Hunt热门AI产品Acti、Wispr Flow、Hey Noah、Pazi、Glaze、AnySearch、Context.dev和OpenSEO不再执着于打造更聪明的ChatGPT,而是分别争夺意图入口、任务执行权、软件生产成本降低以及面向Agent的基础设施,将AI嵌入键盘、语音、邮件等日常工作流程。
搜索
近期Product Hunt热门AI产品Acti、Wispr Flow、Hey Noah、Pazi、Glaze、AnySearch、Context.dev和OpenSEO不再执着于打造更聪明的ChatGPT,而是分别争夺意图入口、任务执行权、软件生产成本降低以及面向Agent的基础设施,将AI嵌入键盘、语音、邮件等日常工作流程。
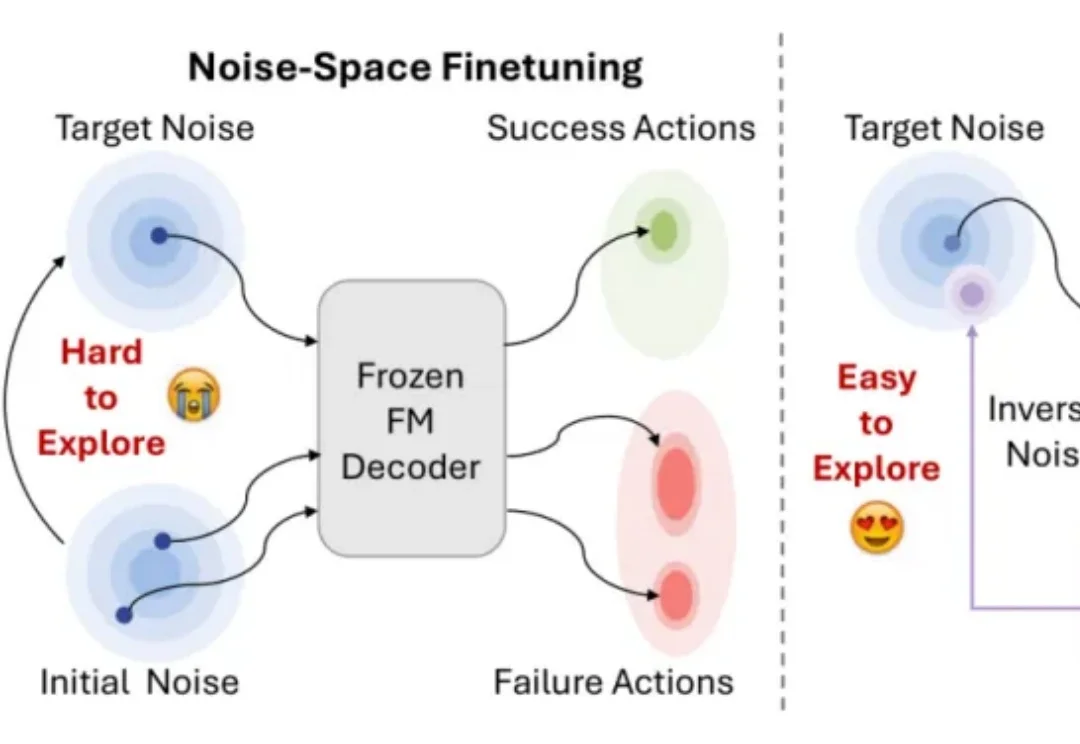
视觉 - 语言 - 动作模型(Vision-Language-Action Model,VLA)正在成为机器人操作的重要基础模型。经过少量示范微调后,VLA 已经能够完成抓取、放置、堆叠等多种任务。然而,一旦任务涉及精密接触、狭小容差或分布外位置,模型的成功率仍会明显下降。
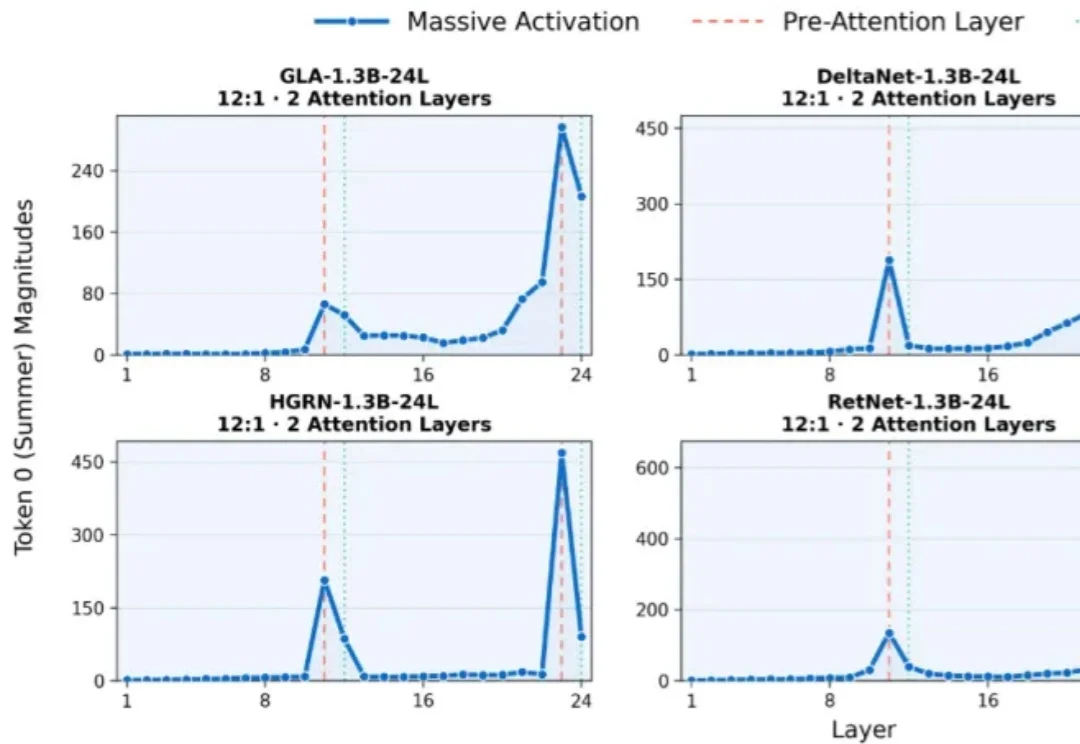
Full Attention 层尚未开始计算,它前一层的激活值已提前「冲上峰值」—— 这就像演唱会主角尚未登台,观众席已提前沸腾。来自 StartLux、清华大学等机构的研究者以 Massive Activations 为探针,首次系统刻画了少数 Full Attention 层在混合线性注意力大模型中留下的「跨层痕迹」,并识别出「注意力前尖峰」(PAS)与「尖峰间平台」(ISP)两种核心形态。
在 action chunking 已成为 VLA 标配的今天,「一次执行多少步」几乎被所有工作当作一个固定的超参数。
8 月 10 日,戴盟机器人正式发布全球首个触觉锚定世界模型 Daimon-TWM(Tactile-grounded World Model),以原生触觉贯穿物理认知、推演决策和瞬时反应全阶段。这个 “物理交互脑” 不仅能理解正在发生的物理接触,还能预测下一步交互会发生什么,并根据瞬息万变的反馈及时修正动作。
本文主要介绍来自该团队的最新论文 Teaching Vision-Language-Action Models What to See and Where to Look,目前该论文已经被 ECCV 2026 正式接收,相关代码和模型已全部开源。
查资料、翻译、约会议...长按键盘就够了。
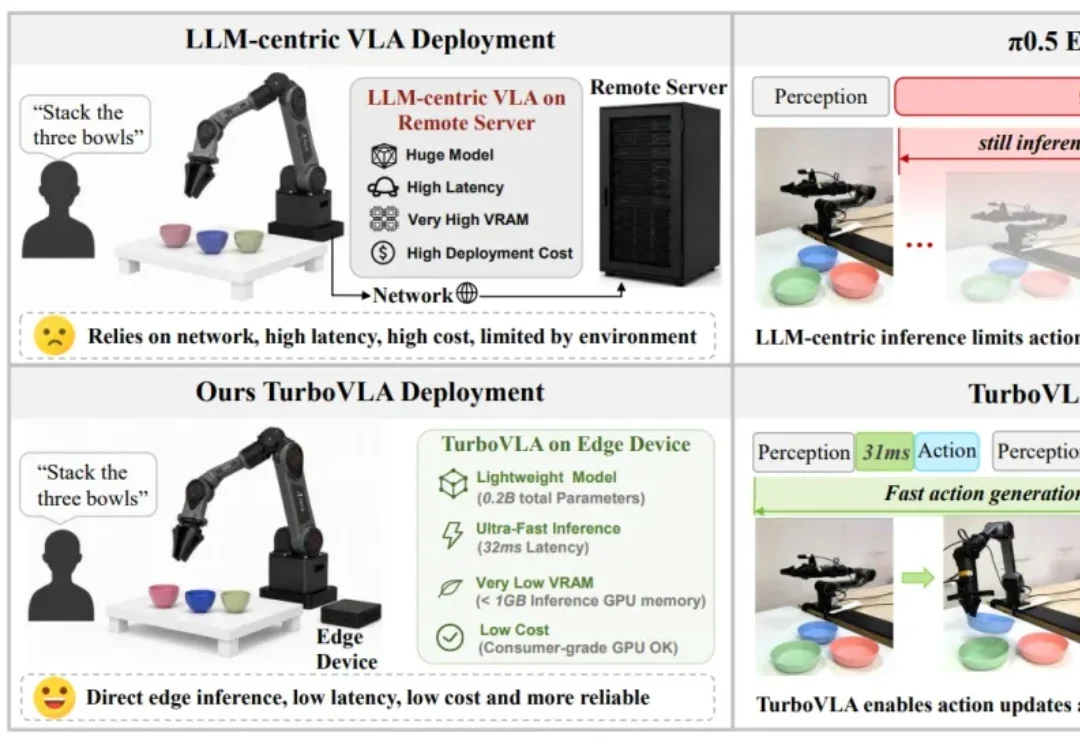
近年来,视觉 — 语言 — 动作模型(Vision-Language-Action Model,VLA)正逐渐成为通用机器人控制的重要技术路线,但当这些模型真正进入高频闭环执行时,一个矛盾越来越突出:模型越来越大、语义能力越来越强,动作更新却未必足够快。
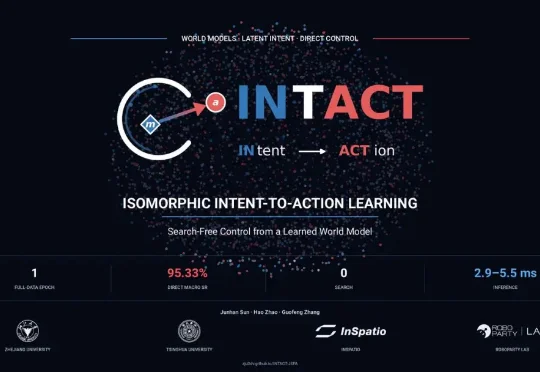
浙江大学、清华大学智能产业研究院、影溯 InSpatio、RoboParty Lab 等团队提出的 INTACT(INtent-To-ACTion),一种基于端到端 JEPA 的无搜索世界模型控制方法,试图改变这一范式:直接利用离线轨迹中已有的状态、动作与未来结果,将运动意图转化为动作模型可以读取的语义接口,使模型无需搜索候选动作序列,就能直接生成动作计划
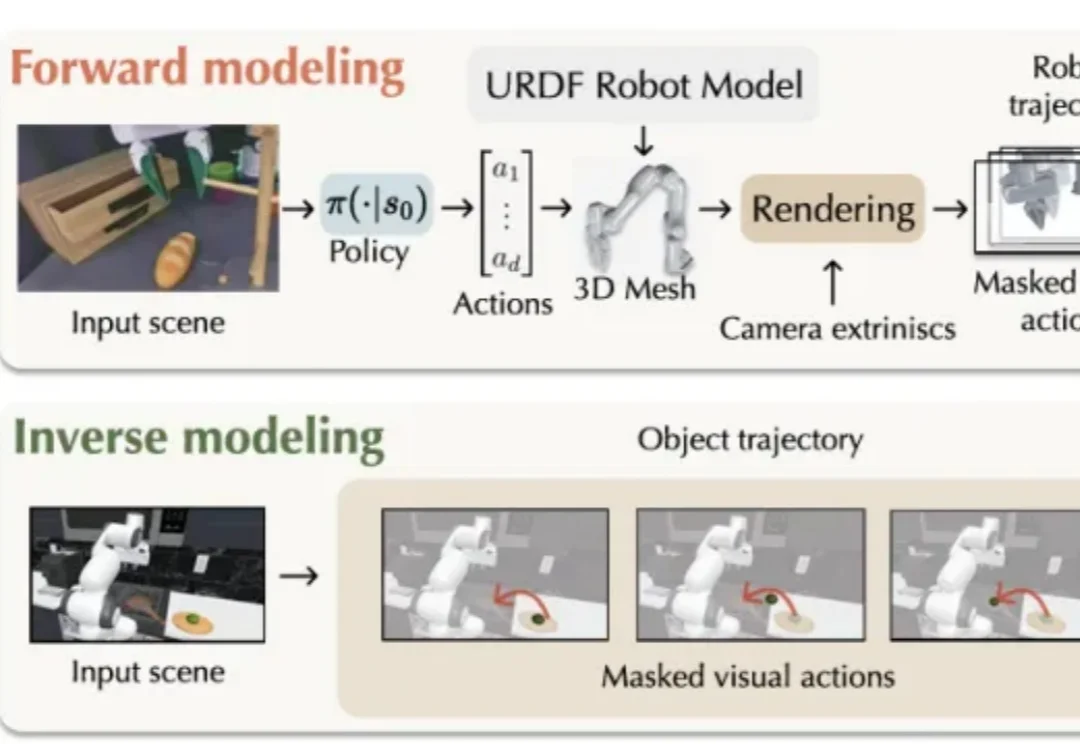
如果要让机械臂把咖啡机旁的杯子移到桌上,需要经历哪几个步骤?