最火VLA,看这一篇综述就够了
最火VLA,看这一篇综述就够了ICLR 2026爆火领域VLA(Vision-Language-Action,视觉-语言-动作)全面综述来了! 如果你还不了解VLA是什么,以及这个让机器人学者集体兴奋的领域进展如何,看这一篇就够了。
来自主题: AI技术研报
10820 点击 2025-10-31 14:59

 搜索
ICLR 2026爆火领域VLA(Vision-Language-Action,视觉-语言-动作)全面综述来了! 如果你还不了解VLA是什么,以及这个让机器人学者集体兴奋的领域进展如何,看这一篇就够了。
美团LongCat团队发布了当前高度贴近真实生活场景、面向复杂问题的大模型智能体评测基准——VitaBench(Versatile Interactive Tasks Benchmark)。VitaBench以外卖点餐、餐厅就餐、旅游出行三大高频生活场景为典型载体,构建了一个包含66个工具的交互式评测环境,并设计了跨场景综合任务。
全球首个真实世界具身多模态数据集,它来了! 刚刚,它石智航发布全球首个大规模真实世界具身VLTA(Vision-Language-Tactile-Action)多模态数据集World In Your Hands(WIYH)。

你有没有过这样的体验:每天在十几个不同的应用之间来回切换,查看邮件、确认日程、处理发票,忙得焦头烂额却感觉效率低下?你可能会想,既然AI已经这么先进了,为什么我的数字生活还是如此支离破碎?一家名为 I
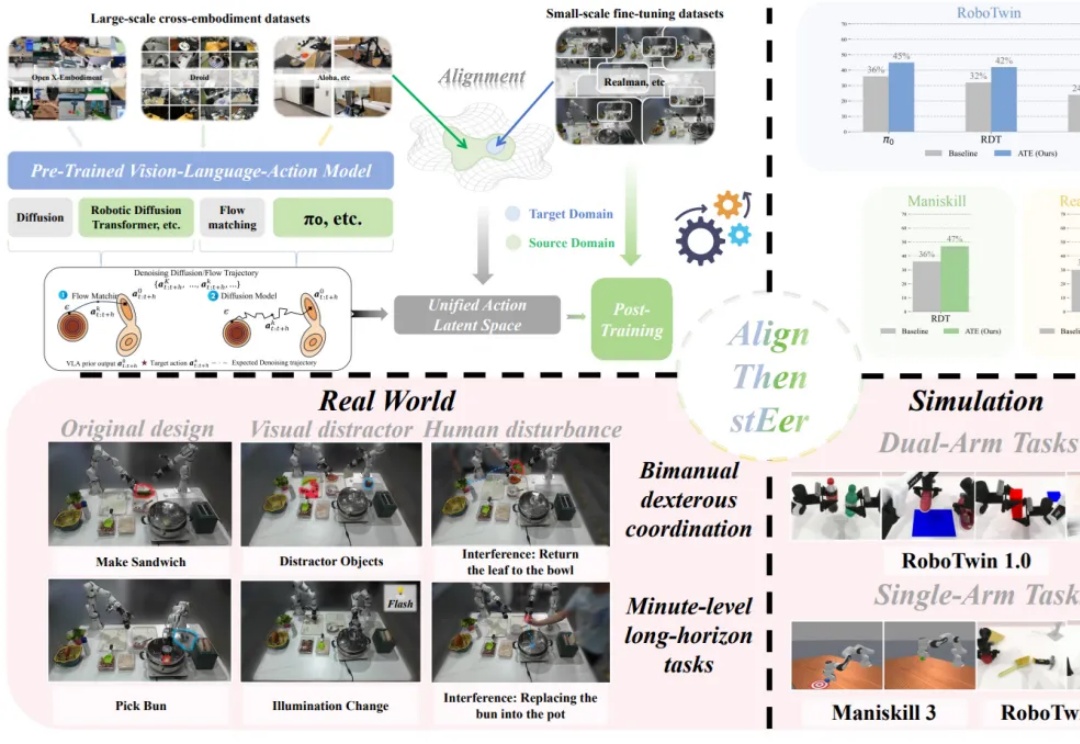
在多模态大模型的基座上,视觉 - 语言 - 动作(Visual-Language-Action, VLA)模型使用大量机器人操作数据进行预训练,有望实现通用的具身操作能力。
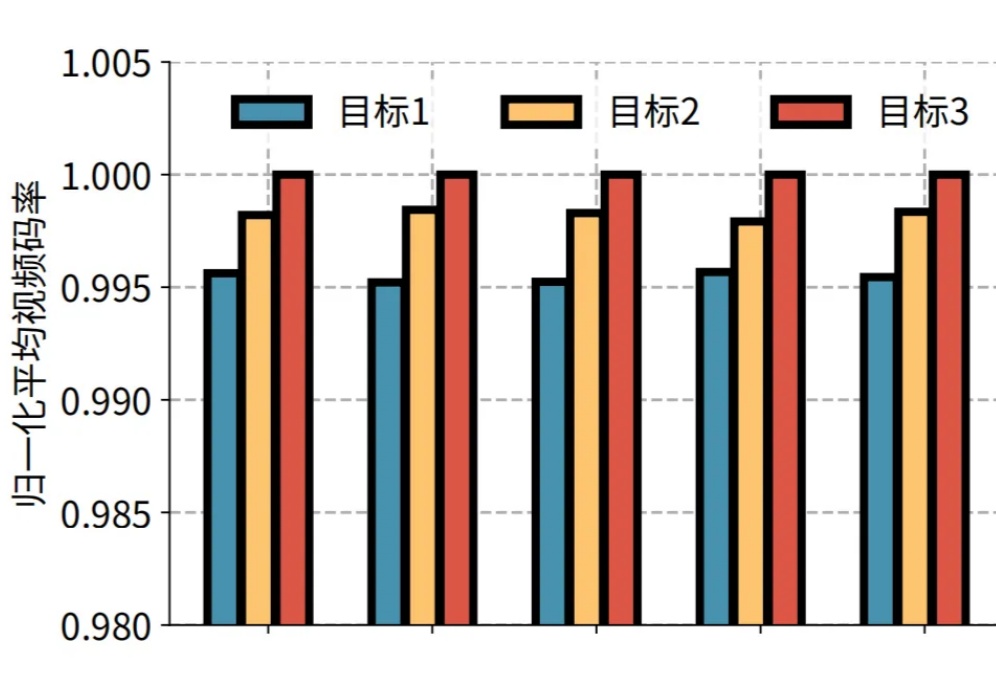
近日,快手与清华大学孙立峰团队联合发表论文《Towards User-level QoE: Large-scale Practice in Personalized Optimization of Adaptive Video Streaming》,被计算机网络领域的国际顶尖学术会议 ACM SIGCOMM 2025 录用。
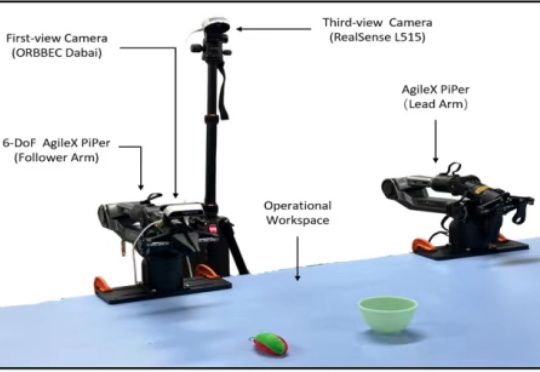
近年来,视觉 - 语言 - 动作(Vision-Language-Action, VLA)模型因其出色的多模态理解与泛化能力,已成为机器人领域的重要研究方向。尽管相关技术取得了显著进展,但在实际部署中,尤其是在高频率和精细操作等任务中,VLA 模型仍受到推理速度瓶颈的严重制约。
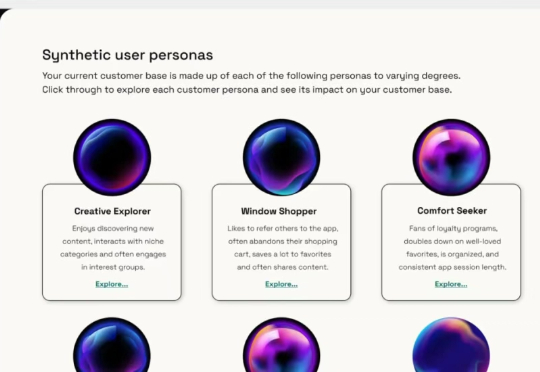
当产品团队还在为等待 4-6 周的 A/B 测试结果而焦虑时,一家名为 Blok 的初创公司正在用 AI 虚拟用户彻底颠覆这一传统模式。他们让产品测试从"weeks"压缩到"hours",从"reactive"转向"predictive",这不仅仅是效率的提升,更是产品开发哲学的根本性变革。
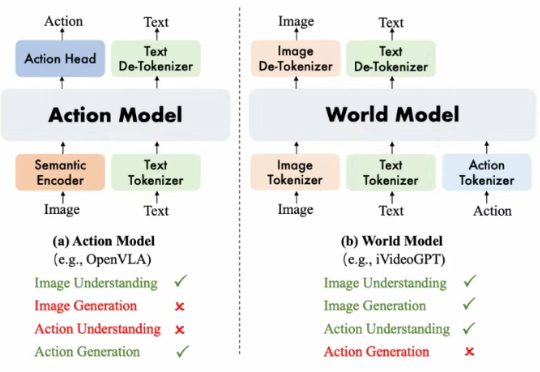
阿里巴巴达摩院提出了 WorldVLA, 首次将世界模型 (World Model) 和动作模型 (Action Model/VLA Model) 融合到了一个模型中。WorldVLA 是一个统一了文本、图片、动作理解和生成的全自回归模型。
西班牙初创公司 Multiverse Computing 于 6 月 12 日宣布 ,凭借其名为"CompactifAI"的技术优势,已完成 1.89 亿欧元(约合 2.15 亿美元)的巨额 B 轮融资。本轮B 轮融资由 Bullhound Capital 领投,该机构曾投资过 Spotify、Revolut、Delivery Hero、Avito 和 Discord 等企业