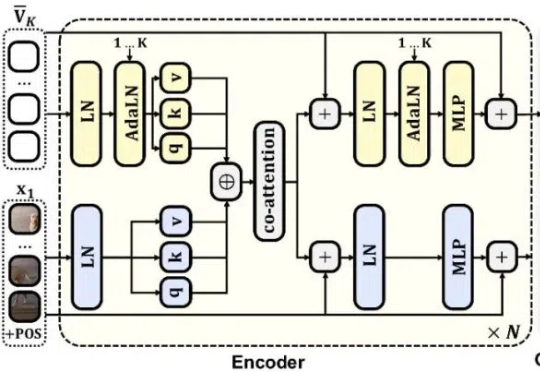
图像分词器造反了!华为 Selftok:自回归内核完美统一扩散模型,触发像素自主推理
图像分词器造反了!华为 Selftok:自回归内核完美统一扩散模型,触发像素自主推理自回归(AR)范式凭借将语言转化为离散 token 的核心技术,在大语言模型领域大获成功 —— 从 GPT-3 到 GPT-4o,「next-token prediction」以简单粗暴的因果建模横扫语言领域。
来自主题: AI技术研报
10144 点击 2025-05-18 14:28

 搜索
自回归(AR)范式凭借将语言转化为离散 token 的核心技术,在大语言模型领域大获成功 —— 从 GPT-3 到 GPT-4o,「next-token prediction」以简单粗暴的因果建模横扫语言领域。
不用引入外部数据,通过自我博弈(Self-play)就能让预训练大模型学会推理?
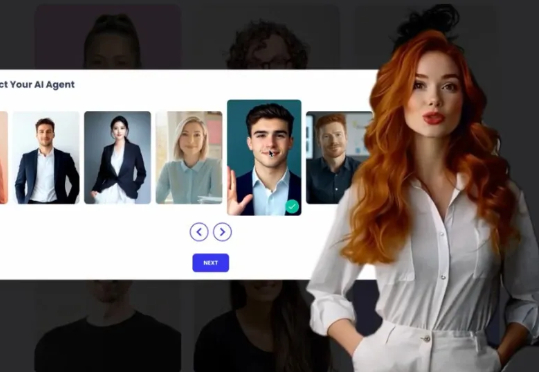
近日,以色列宣布与以色列AI“数字化身”制作平台eSelf、以色列最大的K12教科书出版商CET(Center for Educational Technology)合作,在全国范围内铺开AI辅导。

近日,来自香港科技大学、南洋理工大学等机构的研究团队最新成果让这一设想成为现实。他们提出的 SelfDefend 框架,让大语言模型首次拥有了真正意义上的 ' 自卫能力 ',能够有效识别和抵御各类越狱攻击,同时保持极低的响应延迟。
一位“出海老兵”的自救。
代码模型可以自己进化,利用自身生成的数据来进行指令调优,效果超越GPT-4o直接蒸馏!
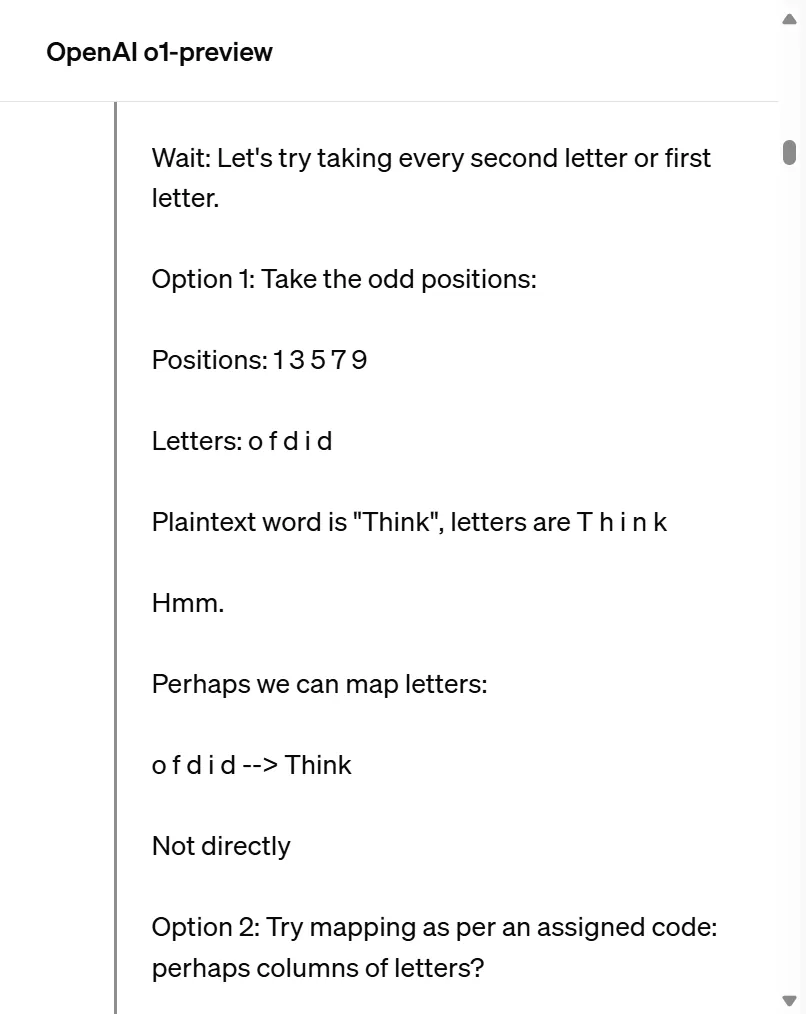
自我纠错(Self Correction)能力,传统上被视为人类特有的特征,正越来越多地在人工智能领域,尤其是大型语言模型(LLMs)中得到广泛应用,最近爆火的OpenAI o1模型[1]和Reflection 70B模型[2]都采取了自我纠正的方法。
o1 模型何以成为企业游戏规则的改变者?
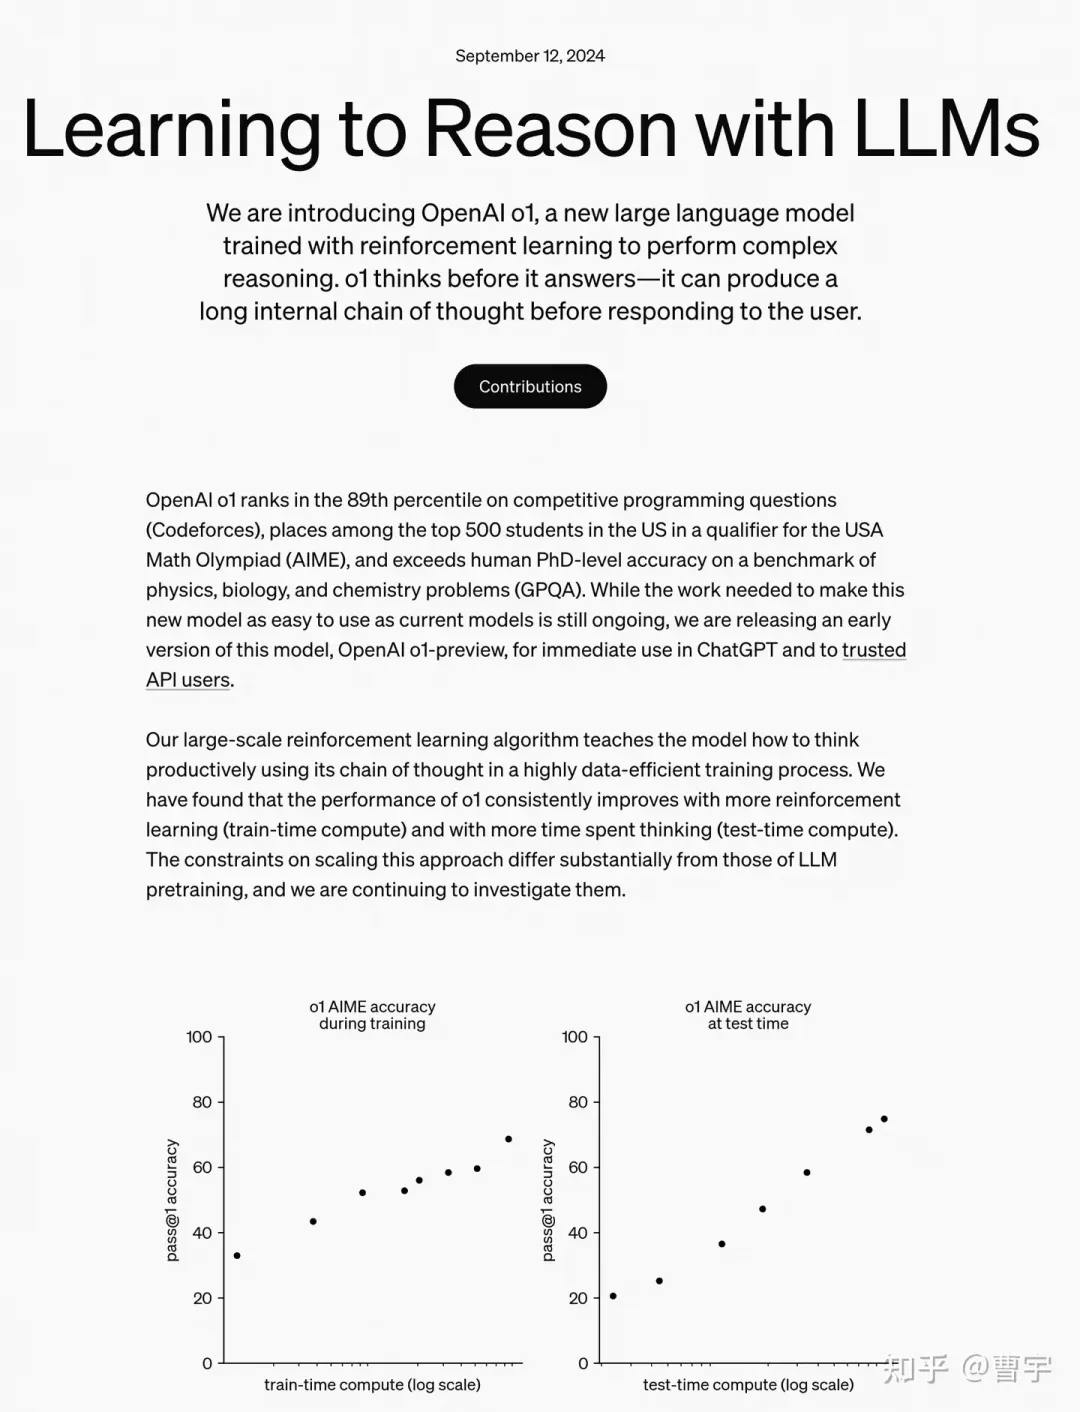
OpenAI的self-play RL新模型o1最近交卷,直接引爆了关于对于self-play的讨论。
Self-play RL 开启 AGI 下半场