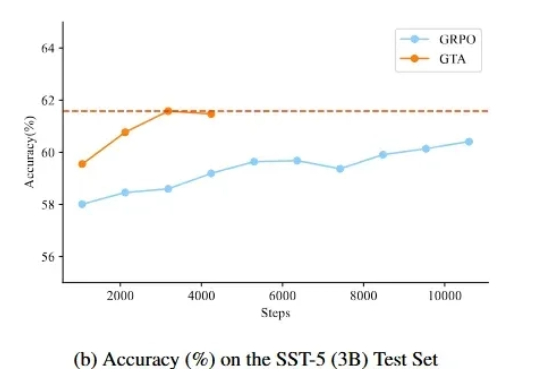
EMNLP2025 | SFT与RL的结合,vivo AI Lab提出新的后训练方法
EMNLP2025 | SFT与RL的结合,vivo AI Lab提出新的后训练方法监督微调(SFT)和强化学习(RL)微调是大模型后训练常见的两种手段。通过强化学习微调大模型在众多 NLP 场景都取得了较好的进展,但是在文本分类场景,强化学习未取得较大的进展,其表现往往不如监督学习。
来自主题: AI技术研报
9223 点击 2025-09-23 14:59

 搜索
监督微调(SFT)和强化学习(RL)微调是大模型后训练常见的两种手段。通过强化学习微调大模型在众多 NLP 场景都取得了较好的进展,但是在文本分类场景,强化学习未取得较大的进展,其表现往往不如监督学习。
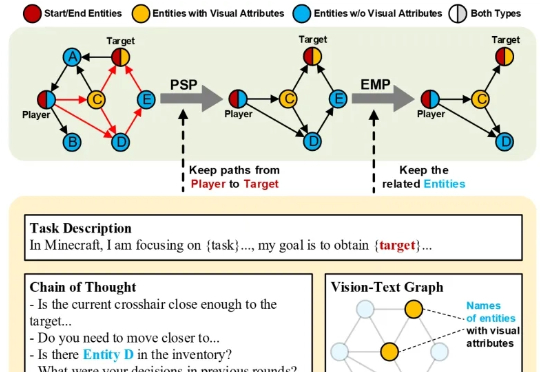
在大多数人眼中,《我的世界》(Minecraft)只是一款自由度极高的沙盒游戏。 而在香港科技大学(广州)与腾讯联合团队的眼中,它却是一座可以演练通用人工智能的“数字练兵场”。
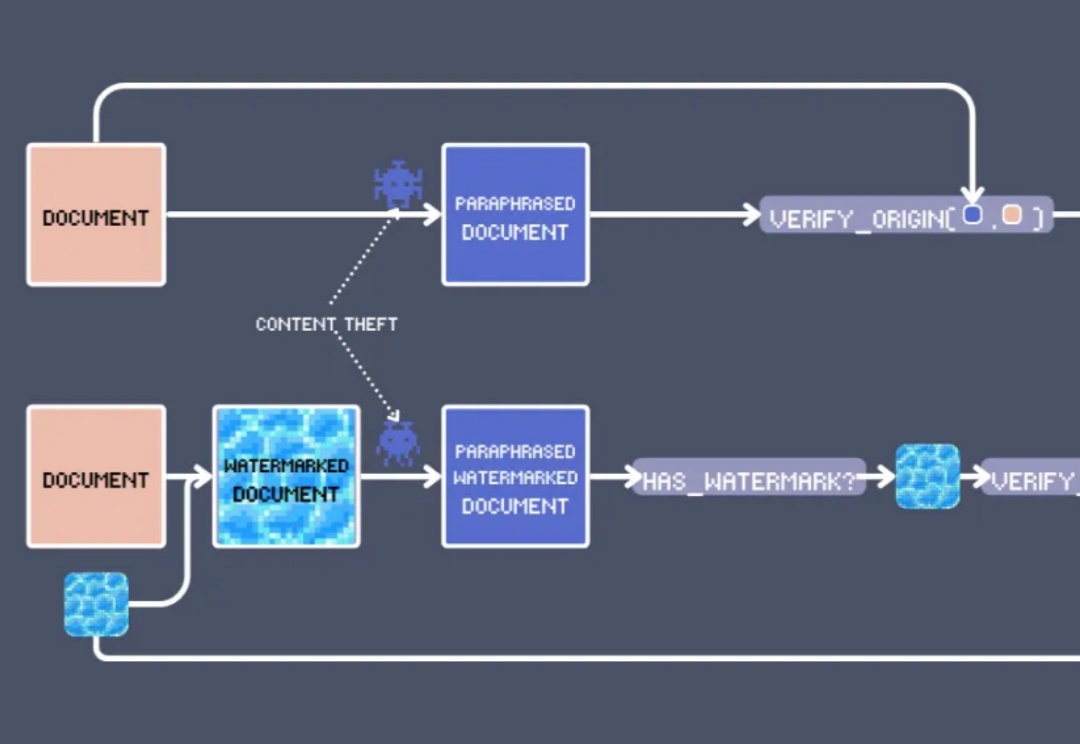
在 EMNLP 2024 上,我们看到了向量模型的各种创新用法,其中最出人意料的莫过于:文本水印。
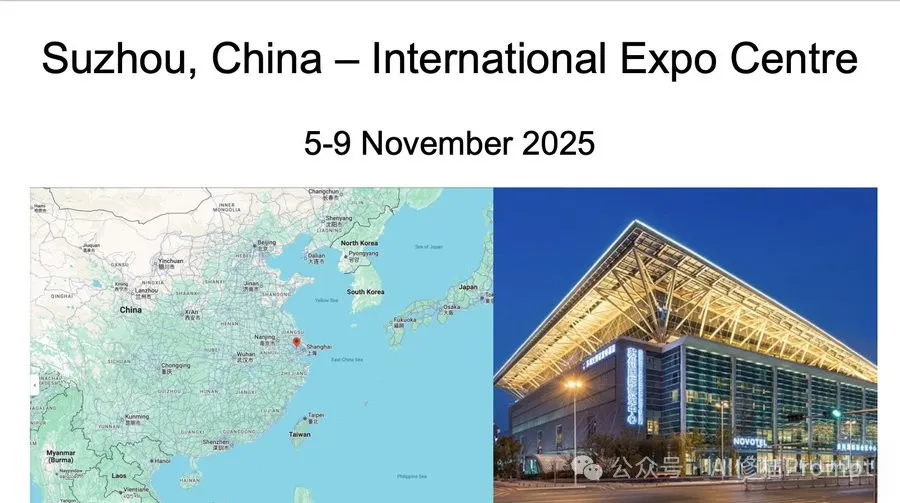
作为自然语言处理(NLP)领域的顶级盛会,EMNLP 每年都成为全球研究者的关注焦点。

让大模型能快速、准确、高效地吸收新知识!
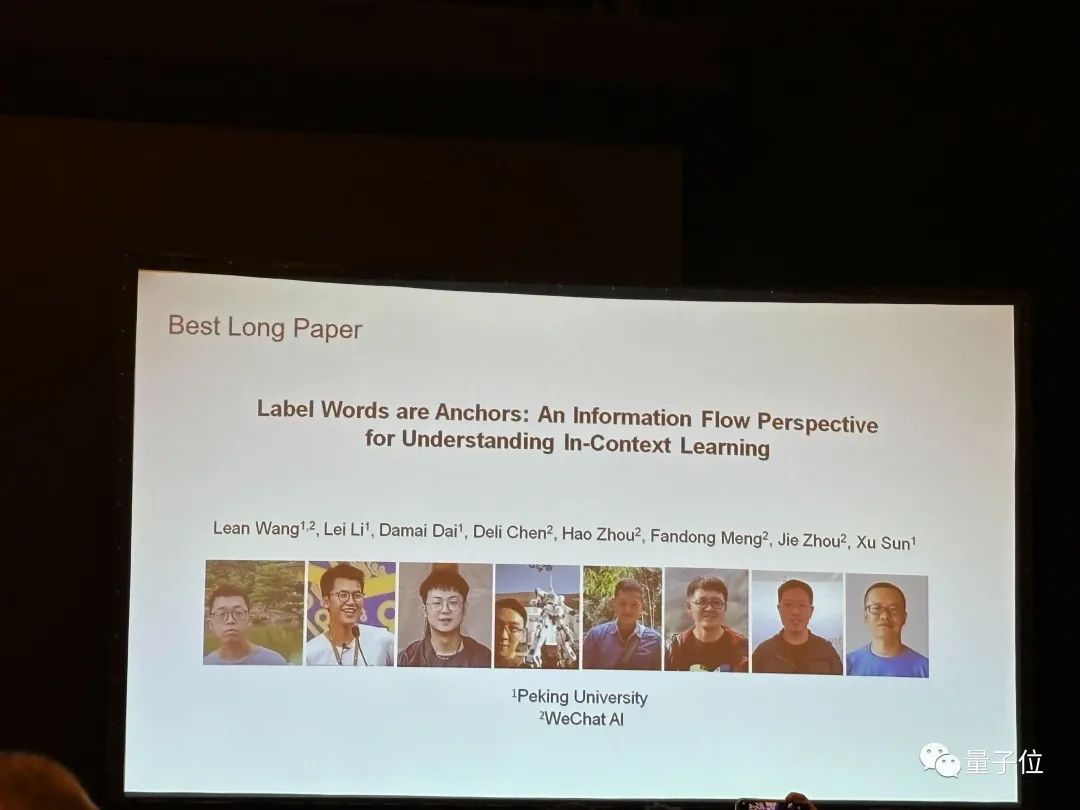
EMNLP顶会落下帷幕,各种奖项悉数颁出。最佳长论文奖被北大微信AI团队收入囊中,由北大孙栩老师和微信周杰、孟凡东合作指导。