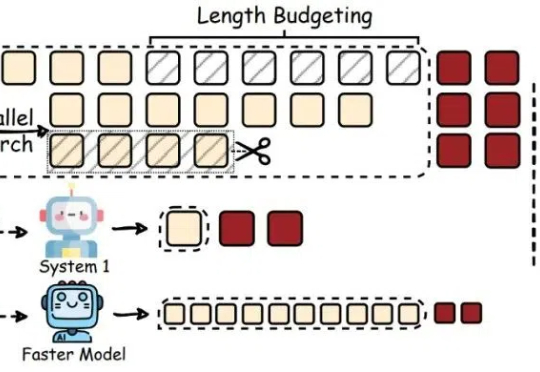
250多篇论文,上海AI Lab综述推理大模型高效思考
250多篇论文,上海AI Lab综述推理大模型高效思考最近,像 OpenAI o1/o3、DeepSeek-R1 这样的大型推理模型(Large Reasoning Models,LRMs)通过加长「思考链」(Chain-of-Thought,CoT)在推理任务上表现惊艳。
来自主题: AI技术研报
10205 点击 2025-04-05 14:45

 搜索
最近,像 OpenAI o1/o3、DeepSeek-R1 这样的大型推理模型(Large Reasoning Models,LRMs)通过加长「思考链」(Chain-of-Thought,CoT)在推理任务上表现惊艳。
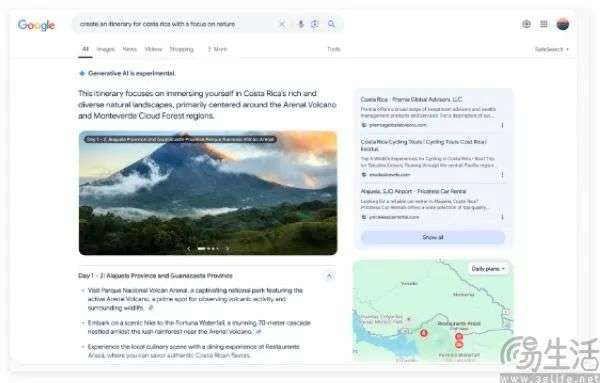
随着DeepSeek R1、OpenAI GTP-4o、Antropic Claude3.7、xAI Grok3纷至沓来,AI大模型已然变成巨头的游戏,“百模大战”也成为了过去式。到了2025年,让用户先把AI用起来,也已经成为了一众厂商的共识。
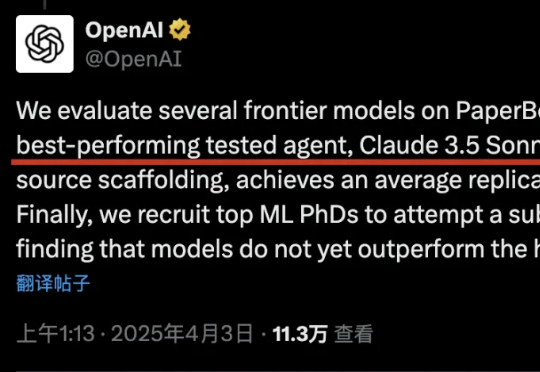
刚刚开源的新基准测试PaperBench,6款前沿大模型驱动智能体PK复现AI顶会论文,新版Claude-3.5-Sonnet显著超越o1/r1排名第一。与去年10月OpenAI考验Agent机器学习代码工程能力MLE-Bnch相比,PaperBench更考验综合能力,不再是只执行单一任务。
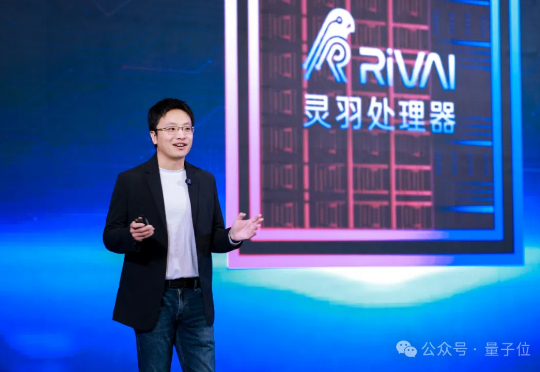
国产全自研高性能RISC-V服务器芯片“灵羽”,刚刚在深圳亮相。
众所周知,DeepSeek R1 这种模型在推理任务上很能打,尤其是在数学和编程这些逻辑性强的领域。那么我们能直接把这种强大的推理能力搬到 DeepSearch 这种需要动态规划、多轮交互的深度搜索场景里吗?
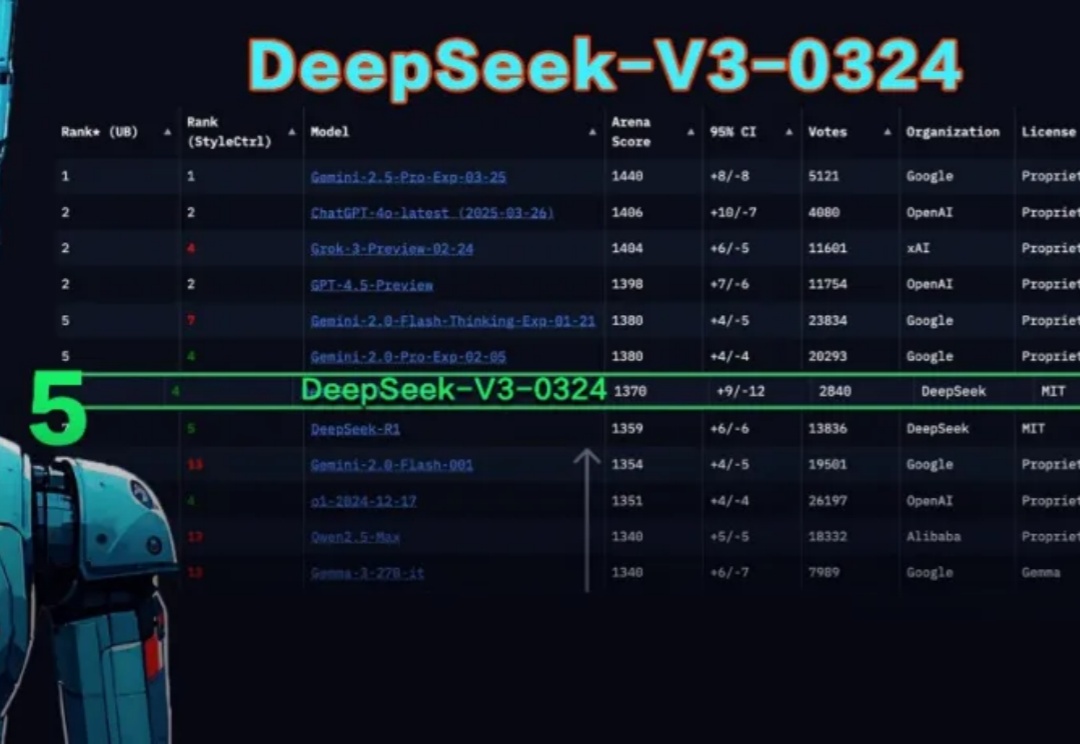
DeepSeek又卷起来了!上周刚出的DeepSeek-V3-0324在大模型竞技场排名中,打败了自己的DeepSeek-R1,成为开源AI至尊。
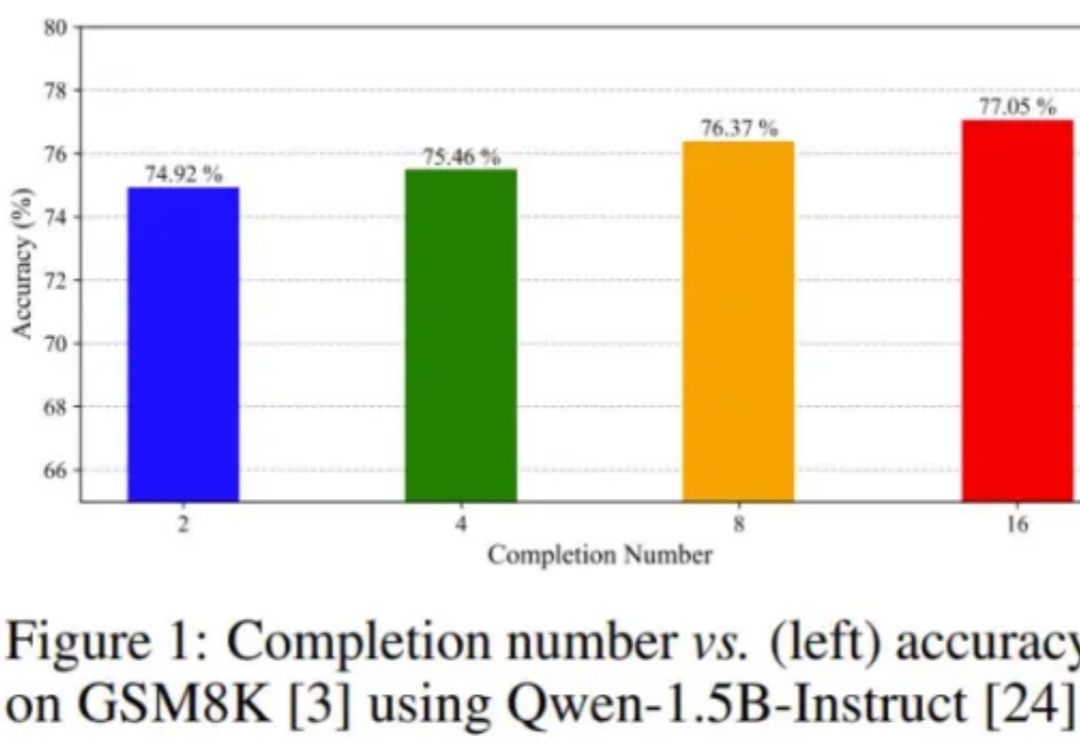
DeepSeek-R1 的成功离不开一种强化学习算法:GRPO(组相对策略优化)。
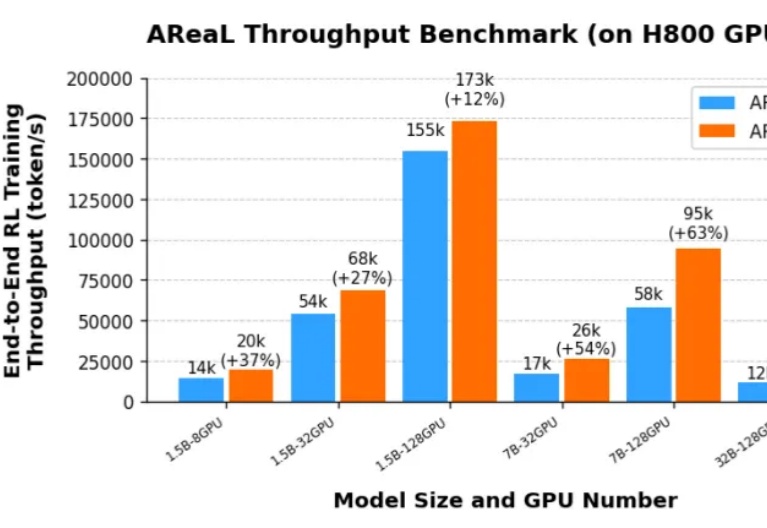
由于 DeepSeek R1 和 OpenAI o1 等推理模型(LRM,Large Reasoning Model)带来了新的 post-training scaling law,强化学习(RL,Reinforcement Learning)成为了大语言模型能力提升的新引擎。然而,针对大语言模型的大规模强化学习训练门槛一直很高:
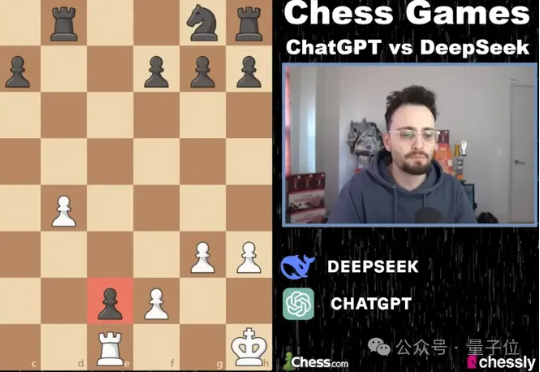
AI社区掀起用大模型玩游戏之风!例如国外知名博主让DeepSeek和Chatgpt下国际象棋的视频在Youtube上就获得百万播放,ARC Prize组织最近也发布了一个贪吃蛇LLM评测基准SnakeBench。
晚点:过去将近 6 个月,AI 领域最重要的两件事,一是 OpenAI 去年 9 月 o1 发布,另一个是近期 DeepSeek 在发布 R1 后掀起全民狂潮。我们可以从这两个事儿开始聊。你怎么看 o1 和 R1 分别的意义?