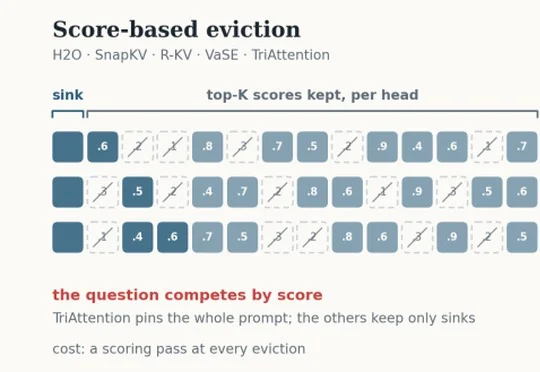
KV Cache不用「精挑细选」?随机删除媲美最强基线,推理吞吐最高再提43%
KV Cache不用「精挑细选」?随机删除媲美最强基线,推理吞吐最高再提43%大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每
来自主题: AI技术研报
9041 点击 2026-09-20 11:05

 搜索
大模型越来越会 “想”,也越来越能把 GPU 显存 “想满”。 在数学、科学问答和代码生成等任务中,reasoning model 往往会生成数千乃至数万 token 的长推理链。随着生成持续进行,每
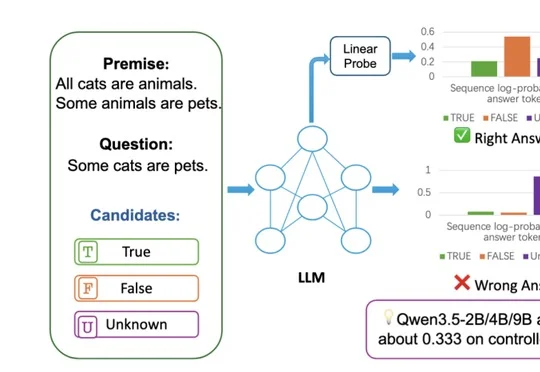
北京大学与易鑫AI Lab合作论文被EMNLP 2026主会接收,提出大模型"读出瓶颈"(Readout Bottleneck)概念,指出模型隐藏状态已编码正确答案却被输出层偏置掩盖,仅用2个无标签参数修正即可在多项推理任务上将准确率从33.3%盲猜水平大幅恢复。
先理解,后生成,更懂物理规律的视频模型。
谷歌,可能已经破解了RSI!
AI要学会自己改进自己,谷歌打算先让它做个“梦”。
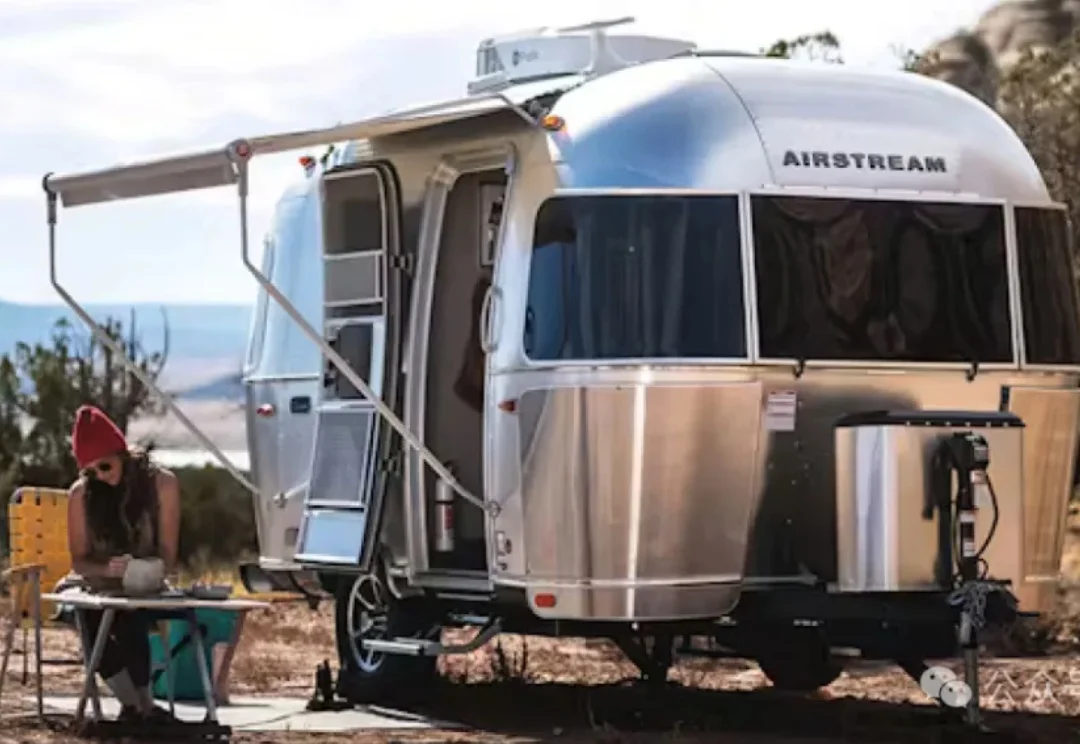
马斯克最新「宫殿」曝光—— 一辆位于美国孟菲斯的Airstream拖挂房车。
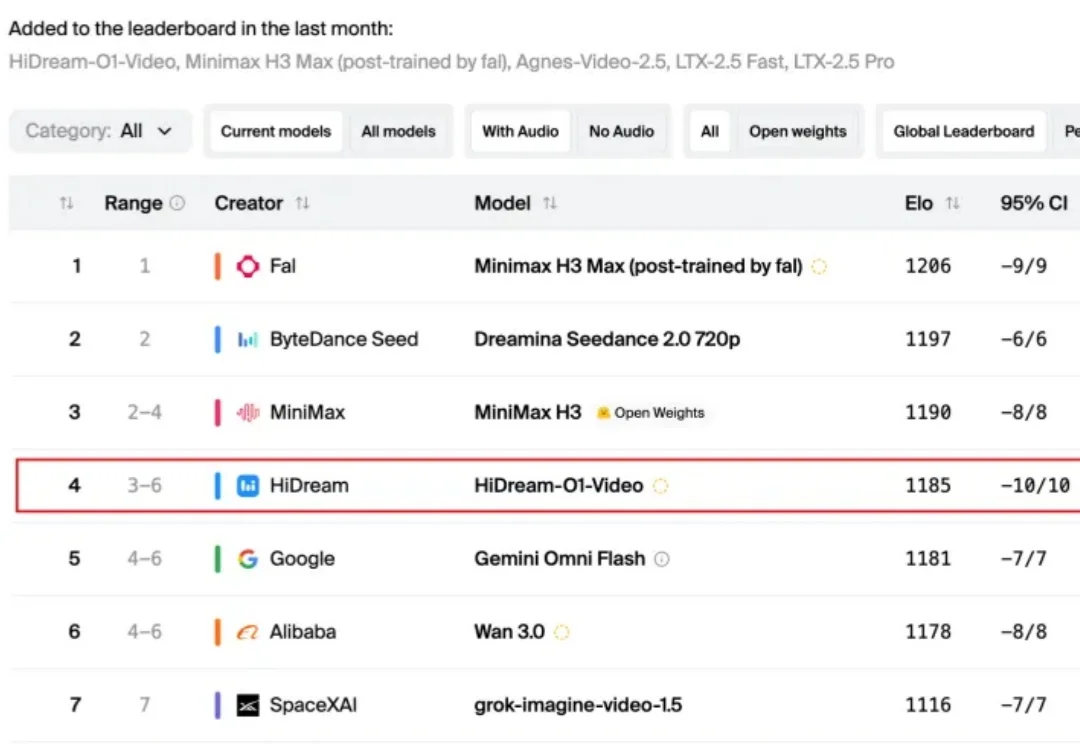
最近几个月,AI 视频赛道开始热起来了: Seedance2.0 发布后,AI 视频进入可用阶段,MiniMax H3 发布后,以 1/4 的价格,把 Seedance 2.0 的成本打了下去,AI 视频成本进入平价时代。
地铁急刹,金属尖叫,广播响起「请乘客注意扶稳」,人群骚动、孩子哭声、对讲机杂音一层层涌上来···
Agent爆发时代,我们需要什么样的AI计算底座?
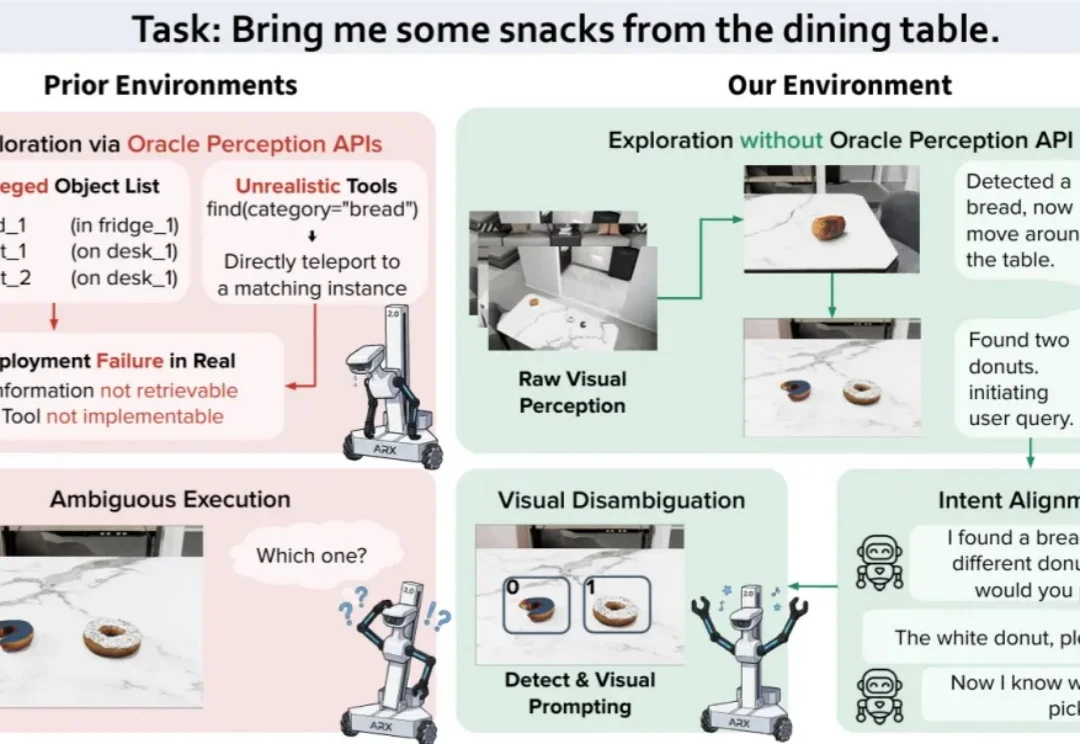
真实家庭任务往往从「不完整的信息」开始:机器人不知道目标在哪里,用户也未必能一次说清自己想要什么。面对「帮我从餐桌上拿点零食」这样的模糊指令,机器人不仅要主动寻找候选物体,还要在发现面包和多个甜甜圈后进一步询问用户,确认究竟该拿哪一个。