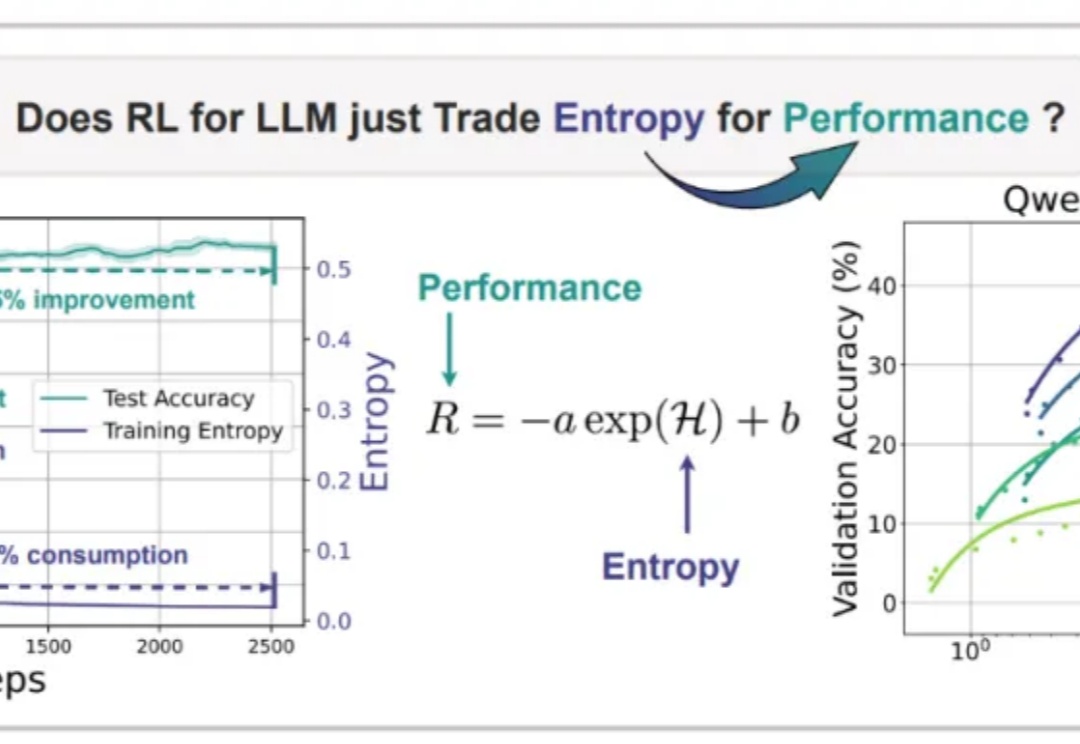
10行代码,AIME24/25提高15%!揭秘大模型强化学习熵机制
10行代码,AIME24/25提高15%!揭秘大模型强化学习熵机制Nature never undertakes any change unless her interests are served by an increase in entropy. 自然界的任何变化,唯有在熵增符合其利益时方会发生——Max Planck
来自主题: AI技术研报
7385 点击 2025-06-06 12:08

 搜索
Nature never undertakes any change unless her interests are served by an increase in entropy. 自然界的任何变化,唯有在熵增符合其利益时方会发生——Max Planck
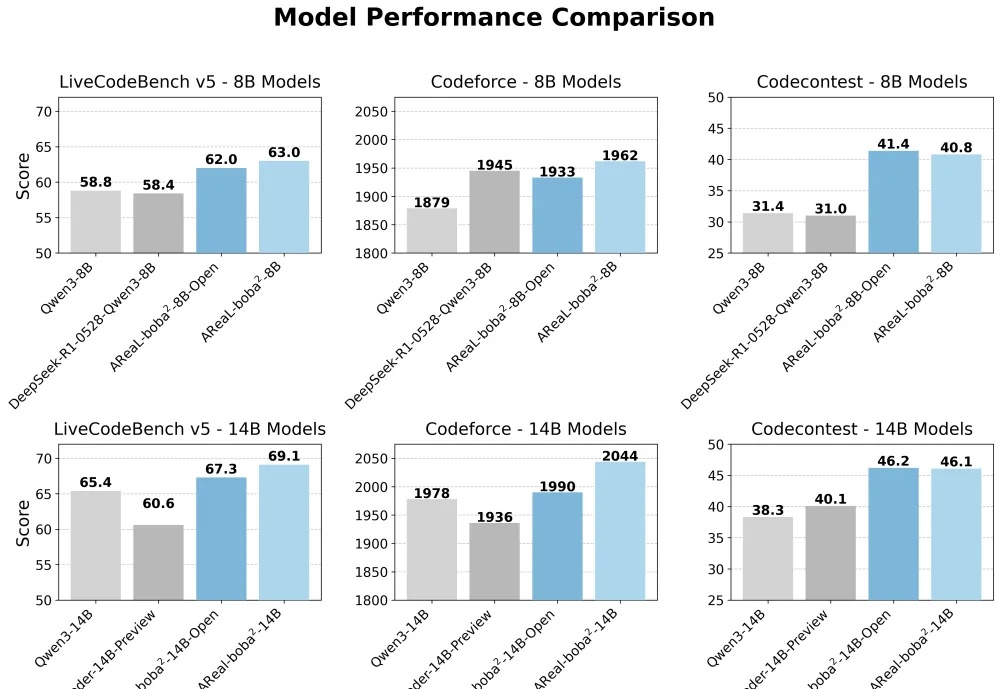
清华与蚂蚁联合开源AReaL-boba²,实现全异步强化学习训练系统,有效解耦模型生成与训练流程,GPU利用率大幅提升。14B模型在多个代码基准测试中达到SOTA,性能接近235B模型。异步RL训练上大分!
AI 并非突然突破,而是一项长期投资,旨在改变企业运营模式,最终让复杂流程更智能。
想训练属于自己的高性能推理模型,却被同步强化学习(RL)框架的低效率和高门槛劝退?AReaL 全面升级,更快,更强,更好用!
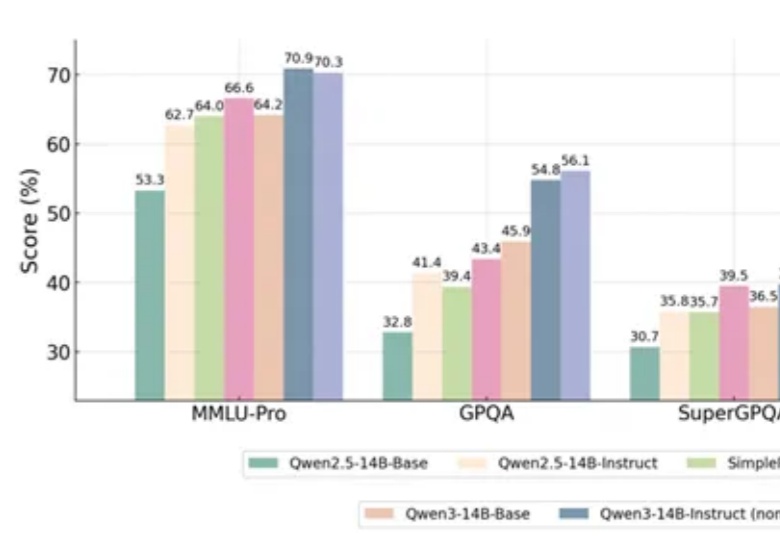
一项新的强化学习方法,直接让Qwen性能大增,GPT-4o被赶超!
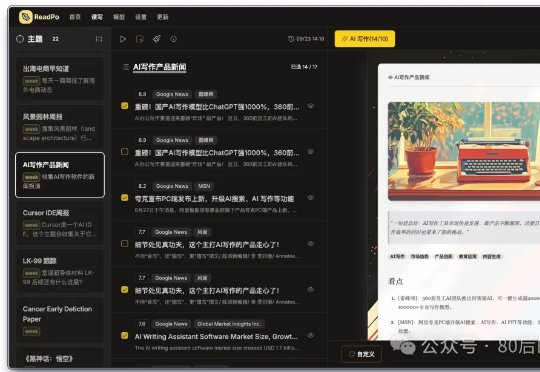
最近在WaytoAGI社区,留意到有朋友在用一款海报,发送最新的咨询信息,并且信息整理详尽,你可以从无序的新闻热点里,跳出来了。 那么今天介绍的,ReadPo 是 AI 驱动的读写助手。以闪电般的速度帮你完成信息的收集和筛选,并创建引人入胜的新内容。
腾讯的CodeBuddy、字节的Trea、现在阿里的通义灵码,中国互联网的三大巨头在AI编程领域集结完毕,明显就是要从老美的Cursor手中抢回中国客户。
今天,我们正式发布 DeepSeek-R1,并同步开源模型权重。DeepSeek-R1 遵循 MIT License,允许用户通过蒸馏技术借助 R1 训练其他模型。DeepSeek-R1 上线API,对用户开放思维链输出,通过设置 `model='deepseek-reasoner'` 即可调用。
本文详细解读了 Kimi k1.5、OpenReasonerZero、DAPO 和 Dr. GRPO 四篇论文中的创新点,读完会对 GRPO 及其改进算法有更深的理解,进而启发构建推理模型的新思路。
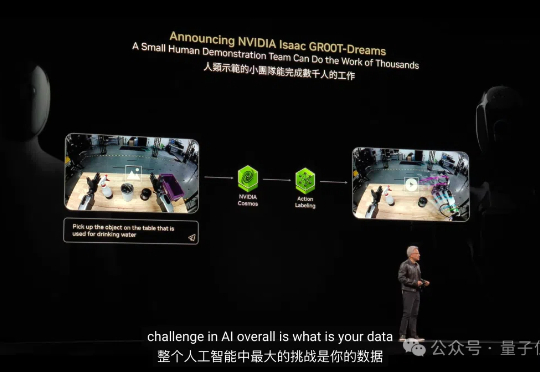
「仿生人会梦见电子羊吗?」这是科幻界一个闻名遐迩的问题。现在英伟达给出答案:Yes!而且还可以从中学习新技能。如下面各种丝滑操作,都没有真实世界数据作为训练支撑。仅凭文本指令,机器人就完成相应任务。