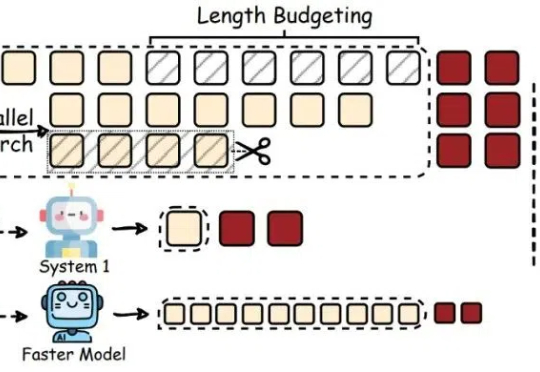
250多篇论文,上海AI Lab综述推理大模型高效思考
250多篇论文,上海AI Lab综述推理大模型高效思考最近,像 OpenAI o1/o3、DeepSeek-R1 这样的大型推理模型(Large Reasoning Models,LRMs)通过加长「思考链」(Chain-of-Thought,CoT)在推理任务上表现惊艳。
来自主题: AI技术研报
10224 点击 2025-04-05 14:45

 搜索
最近,像 OpenAI o1/o3、DeepSeek-R1 这样的大型推理模型(Large Reasoning Models,LRMs)通过加长「思考链」(Chain-of-Thought,CoT)在推理任务上表现惊艳。

近来风头正盛的GPT-4.5,不仅在日常问答中展现出惊人的上下文连贯性,在设计、咨询等需要高度创造力的任务中也大放异彩。
谷歌DeepMind研发的DreamerV3实现重大突破:无需任何人类数据,通过强化学习与「世界模型」,自主完成《我的世界》中极具挑战的钻石收集任务。该成果被视为通往AGI的一大步,并已登上Nature。
从Google Glasses到HoloLens,再到近几年雷鸟创新、Even Realities、影目、星纪魅族、Rokid等陆续发布量产产品,AR眼镜在不断刷新其轻薄程度。
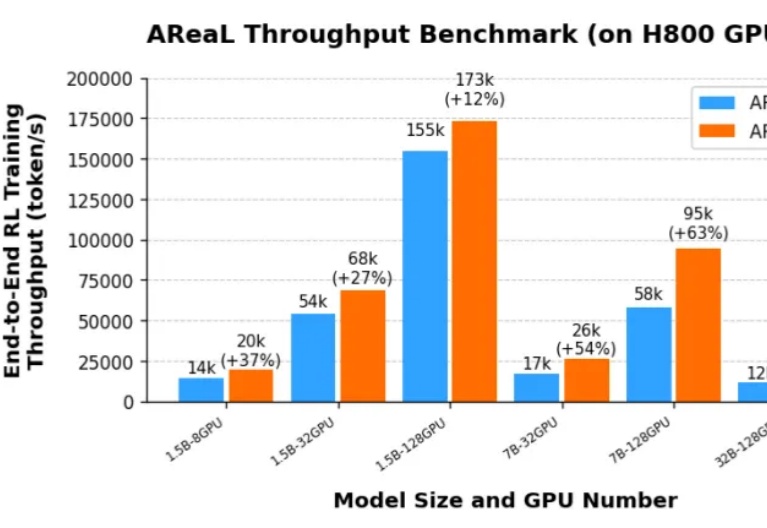
由于 DeepSeek R1 和 OpenAI o1 等推理模型(LRM,Large Reasoning Model)带来了新的 post-training scaling law,强化学习(RL,Reinforcement Learning)成为了大语言模型能力提升的新引擎。然而,针对大语言模型的大规模强化学习训练门槛一直很高:

随着 AI Agent 元年的到来,一个新的趋势正在兴起:初创公司提供工具,帮助雇主打造一支机器人队伍。

还记得之前推荐过一键生成网页代码的 readdy.ai(好用到哭!AI神器Readdy,一键生成网页代码,前端工程师要失业了?),如今这样的神器市场上已冒出一大堆。我们做个详细点的对比,然后根据不同的用户场景,做出一些推荐。
在基于物理世界的真实场景进行视觉问答时,有可能出现参考选项中没有最佳答案的情况,比如以下例子:
如果你让当今的 LLM 给你生成一个创意时钟设计,使用提示词「a creative time display」,它可能会给出这样的结果:
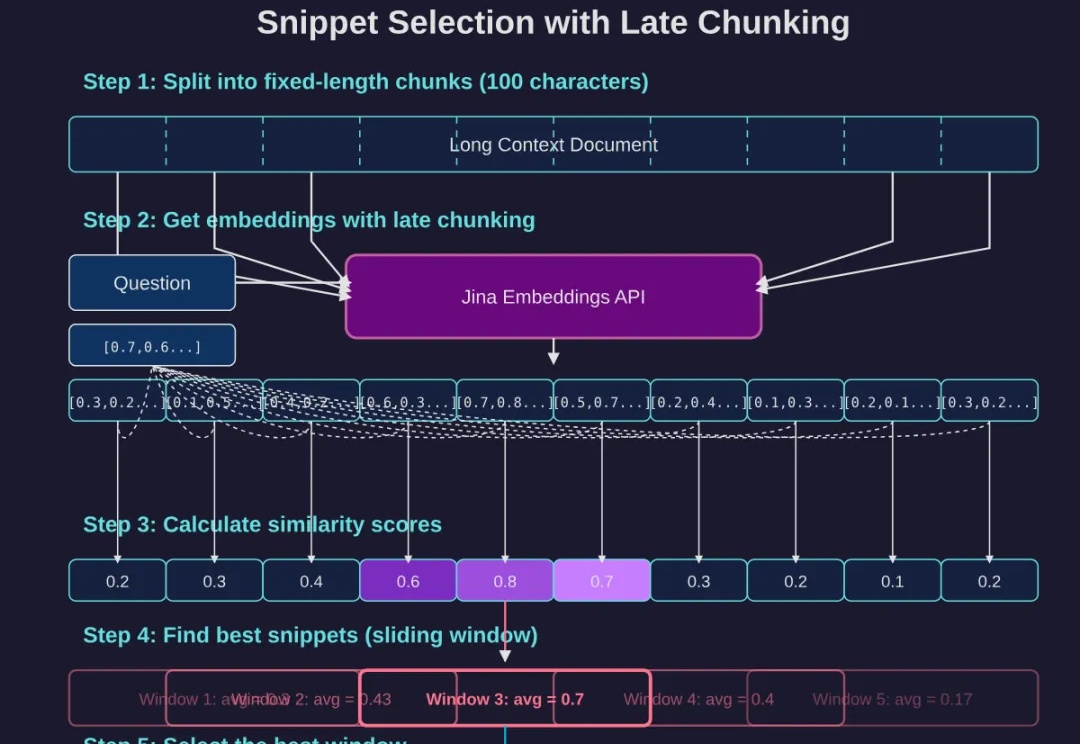
如果你已经读过我们上一篇经典长文《DeepSearch/DeepResearch 的设计与实现》,那么不妨再深挖一些能大幅提升回答质量的细节。这次,我们将重点关注两个细节: