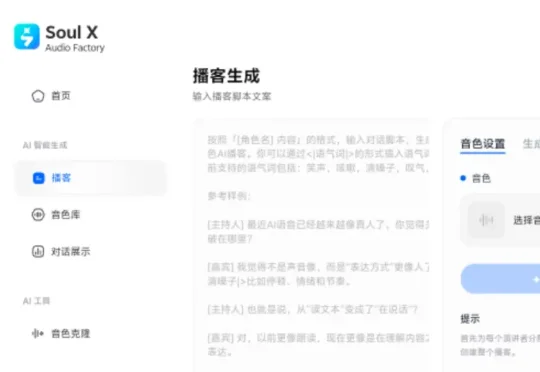
独家!Soul推出AI语音创作平台“Audio Factory”
独家!Soul推出AI语音创作平台“Audio Factory”《读佳》获知,Soul推出AI语音创作平台“AudioFactory”,基于生成式人工智能模型技术为用户提供丰富、多样的AI功能服务,包括但不限于播客AI生成、语音生成合成、AI生成文案等,具体以播客生成、音色克隆等AI语音功能为主,或为其冲击港股IPO再添技术筹码。
来自主题: AI资讯
8819 点击 2026-04-27 10:30

 搜索
《读佳》获知,Soul推出AI语音创作平台“AudioFactory”,基于生成式人工智能模型技术为用户提供丰富、多样的AI功能服务,包括但不限于播客AI生成、语音生成合成、AI生成文案等,具体以播客生成、音色克隆等AI语音功能为主,或为其冲击港股IPO再添技术筹码。
阶跃星辰今日发布新一代自动语音识别模型StepAudio 2.5 ASR。该模型面向语音转写与长音频处理场景,在架构上引入Multi-Token Prediction(多Token预测)以提升推理效率,并通过扩展上下文窗口强化长内容识别能力。
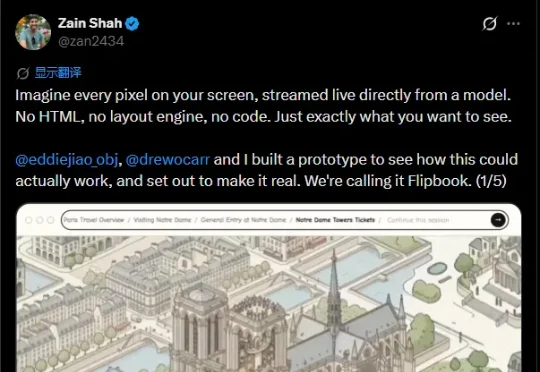
想象一下:你打开浏览器,没有代码、没有 HTML、没有 CSS 布局引擎。屏幕上每一帧画面,都是 AI 模型实时生成的像素视频流。满满的科幻降临既视感!这就是 Zain Shah(前 OpenAI、YC 校友)和团队刚刚发布的 Flipbook 原型。
去年营收1.1亿的原生影视工作室Utopai火起来,又一次彻底刷屏!奥斯卡编剧下场背书,这家公司直接复刻了皮克斯的神话。从剧本到4K大片一键直出,AI视频刚刚完成了一次史诗级升级。
模思智能成立于2024年,位于上海徐汇区,由上海创智学院与复旦大学联合孵化,是国内少数完成“全模态基座模型能力闭环”的初创公司之一,致力于构建统一Token表达框架下的“情境智能”能力,推动Agent系统在真实世界中的自主交互与任务执行。
语音合成大家都不陌生,这两年市面上各种AI配音也层出不穷。
2026 年,阿联酋哈利法大学的邹航博士和他所在的团队,做出了全世界第一个射频大模型,名字叫 RF GPT。这个模型能直接看懂无线信号,就像 GPT 4o 能看懂图片、Qwen2 Audio 能听懂声音一样。你把无线信号扔给它,它不仅能告诉你这里面有几种信号、分别是什么技术,还能分析出有没有信号在打架、哪个是 5G 哪个是蓝牙、甚至能数出来 WiFi 网络里有多少个用户同时在用。
最近,GitHub又炸出了一个明星项目:让「一个人开游戏公司」变成现实的Claude-Code-Game-Studios。与此同时,另一个「让普通人把想象变成游戏」的产品Aippy,也在欧美年轻人中风靡。与前者的专业工具属性不同,Aippy要做的是新一代数字原住民的「游戏社区」。
相似度超越Seed-TTS、MiniMax-Speech等知名模型。昨晚,美团LongCat团队发布了文本转语音模型LongCat-AudioDiT,并开源1B、3.5B参数量的版本。这一模型的最大特点,是彻底抛弃了梅尔谱等中间表示,直接在波形潜空间进行基于扩散模型的文本转语音。通俗地说,这一模型直接根据声音本身的规律进行生成,“雕刻”出最原始的声音波形,从根源阻断数据转换的级联误差。
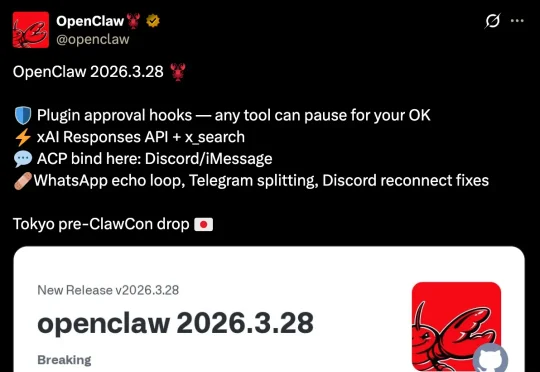
今天,OpenClaw 直接推送了最新的 3.28 版本。这次更新的内容也是格外丰富,简直是底层能力的全面大解放。简单挑几个跟日常体验关系最大的。Qwen 模型正式迁移到了 Model Studio,直接走新的认证选项,干净利落。