重新定义跨模态生成的流匹配范式,VAFlow让视频「自己发声」
重新定义跨模态生成的流匹配范式,VAFlow让视频「自己发声」在多模态生成领域,由视频生成音频(Video-to-Audio,V2A)的任务要求模型理解视频语义,还要在时间维度上精准对齐声音与动态。早期的 V2A 方法采用自回归(Auto-Regressive)的方式将视频特征作为前缀来逐个生成音频 token,或者以掩码预测(Mask-Prediction)的方式并行地预测音频 token,逐步生成完整音频。
搜索
在多模态生成领域,由视频生成音频(Video-to-Audio,V2A)的任务要求模型理解视频语义,还要在时间维度上精准对齐声音与动态。早期的 V2A 方法采用自回归(Auto-Regressive)的方式将视频特征作为前缀来逐个生成音频 token,或者以掩码预测(Mask-Prediction)的方式并行地预测音频 token,逐步生成完整音频。
给歌曲做MV,现在已经是一个AI就能搞定的时代了。 来,请欣赏用AI给神曲《八方来财》做的东方赛博朋克MV:
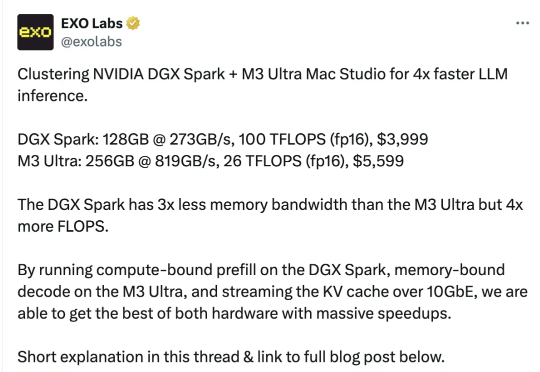
英伟达桌面超算,邪修玩法来了!两台DGX Spark串联一台苹果Mac Studio,就能让大模型推理速度提升至2.77倍。
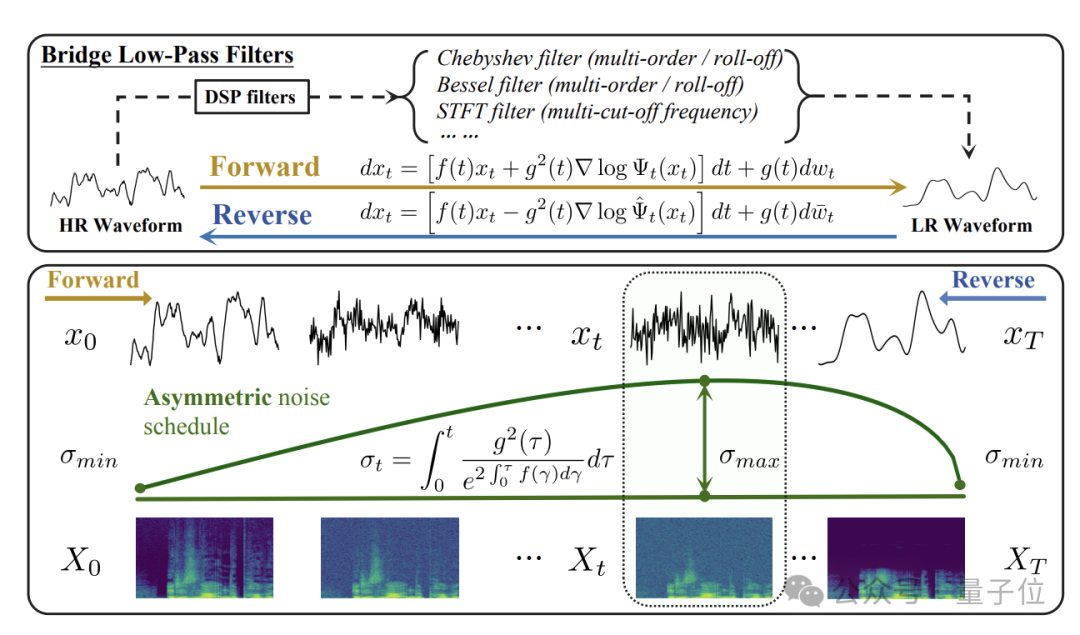
在这一背景下,清华大学与生数科技(Shengshu AI)团队围绕桥类生成模型与音频超分任务展开系统研究,先后在语音领域顶级会议ICASSP 2025和机器学习顶级会议NeurIPS 2025发表了两项连续成果:
终于,Nano Banana正式开放API了! 现在大家不仅可以直接在Google AI Studio里基于Nano Banana,手动搓出属于自己的App,还可以通过Gemini API接入任意发挥了。
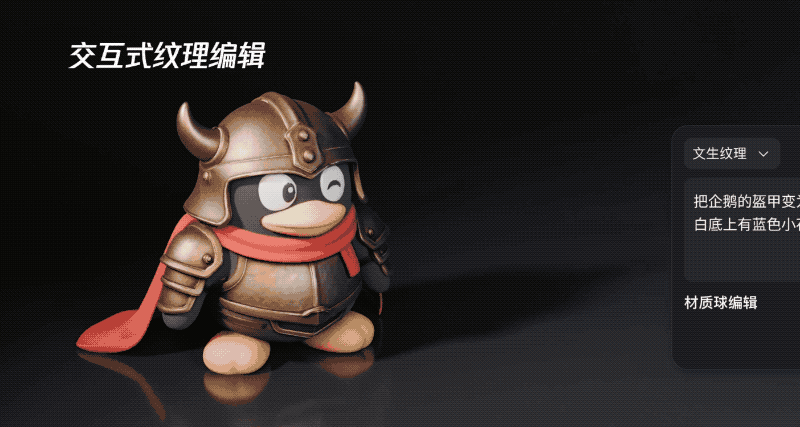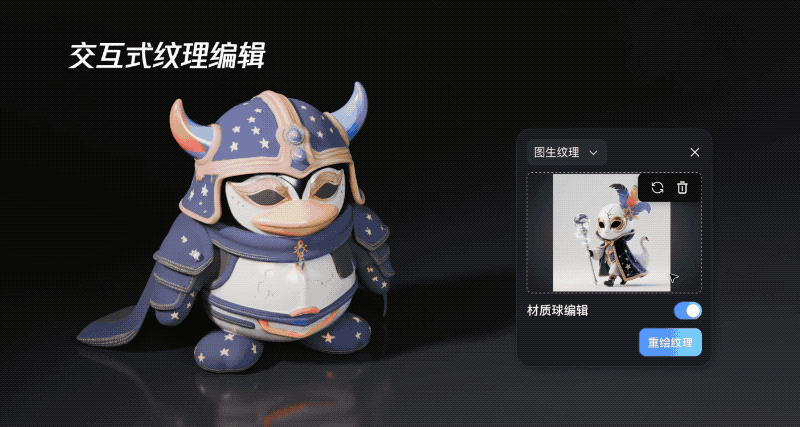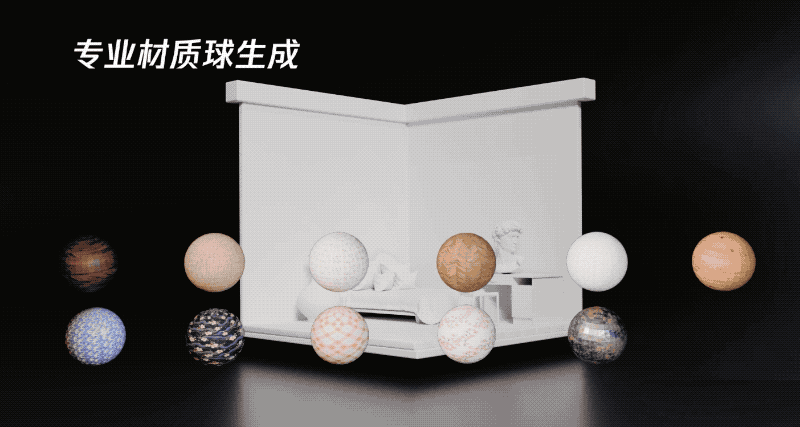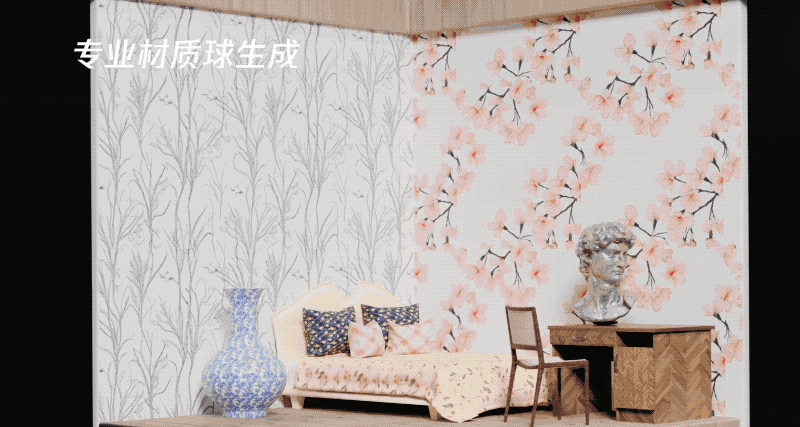
不用在建模、UV、贴图软件之间反复横跳,一个工作台就能得到:这是腾讯专为3D设计师、游戏开发者、建模师等打造的专业级AI工作台混元3D Studio。
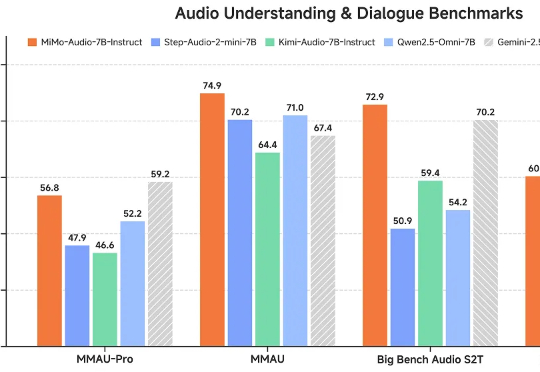
这一瓶颈如今被打破。小米正式开源首个原生端到端语音模型——Xiaomi-MiMo-Audio,它基于创新预训练架构和上亿小时训练数据,首次在语音领域实现基于 ICL 的少样本泛化,并在预训练观察到明显的“涌现”行为。
作为AI驱动的3D建模平台,Tripo(https://www.tripo3d.ai)已在全球覆盖超300万专业开发者,AI 3D原生模型数量超过4000万,中小用户超4万,并推出了一站式AI 3D工作台Tripo Studio
智东西9月15日报道,今天,阿里巴巴通义实验室推出了FunAudio-ASR端到端语音识别大模型。这款模型通过创新的Context模块,针对性优化了“幻觉”、“串语种”等关键问题,在高噪声的场景下,幻觉率从78.5%下降至10.7%,下降幅度接近70%。
全球首家AI原生影视工作室横空出世,项目收入竟已高达1.1亿美元! 名叫Utopai Studios。 当前AI热度如日中天,以AI切入电影行业的力量主要分为两派:一派是以Runway、Pika为代表的“工具派”,聚焦AI的工具属性,核心发力点在于提升影视制作环节的效率。