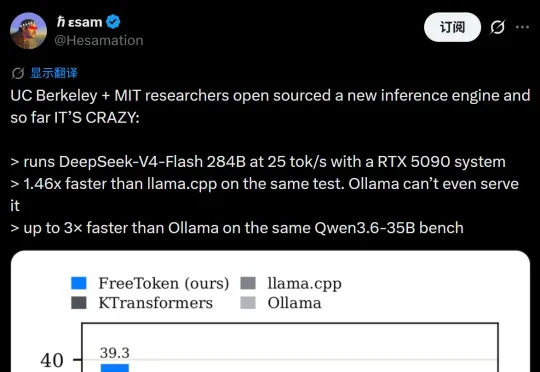
单卡5090跑满血DeepSeek V4Flash,已开源,Token自由了!
单卡5090跑满血DeepSeek V4Flash,已开源,Token自由了!本周五,AI 社区热烈讨论的是一个端侧大模型部署技术,它能让笔记本 RTX 4060 跑 Qwen 3.6-35B,桌面 RTX 5090 跑得起 DeepSeek-V4-Flash 284B。而且都是单卡,模型都是满血的。Codex 生产 trace 的中位 decode 速度是 33 token/s
搜索
本周五,AI 社区热烈讨论的是一个端侧大模型部署技术,它能让笔记本 RTX 4060 跑 Qwen 3.6-35B,桌面 RTX 5090 跑得起 DeepSeek-V4-Flash 284B。而且都是单卡,模型都是满血的。Codex 生产 trace 的中位 decode 速度是 33 token/s
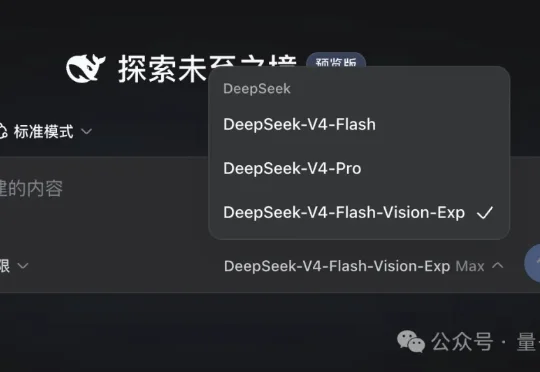
等了四个月,DeepSeek的多模态模型:deepseek-v4-flash-vision-exp,终于发布。我也是第一时间赶到现场,连夜开始实测。相比V4 Flash最大的不同,就是支持原生支持图片输入了,但图片生成当然还是没有的。
学不过来,刚刚学会怎么用好 Codex,现在又来了个 DeepSeek Harness。 过去几天,我们已经介绍过它的插件、各种新玩法和新上线的多模态,但还有一个最基础的问题没有解决:DeepSeek
DeepSeek 终于「开眼」了。就在刚刚,DeepSeek 推出了一款面向 Agent 时代的多模态模型:deepseek-v4-flash-vision-exp。目前,该模型已经上线 DeepSeek API 平台上,用户可以通过设置 model='deepseek-v4-flash-vision-exp' 访问该模型。
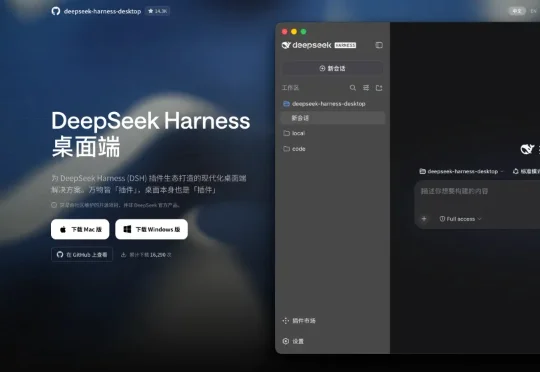
DeepSeek Harness 是 DeepSeek 官方最新开源的 AI Agent 运行环境,简称 DSH。你可以把它理解成一个高度可定制的 AI 编程工具,对标 Claude Code 和 Codex,核心理念是「一切皆插件」。本期我就来带大家鉴赏一大波 DeepSeek Harness 热门插件,有实用的、也有好看的。
外挂补不了模型智商,《苦涩的教训》再次上演。
韩国济州岛,KDD 2026现场。
上两天肝的视频上了热搜 + 热门,使用插件,针对 ds 模型可以提升不小的性能。
「万物皆插件。」
昨夜,DeepSeek Harness迎来公测后的首次重要更新。DeepSeek Harness v0.1.0-rc.8版本上线,多模态能力成为这次更新的重头戏。此次更新共带来14项调整,覆盖多模态输入、子代理协作、终端体验、工具调用和开发者支持等多个方向,既补齐了Agent处理图片等多模态任务的能力,也进一步完善了子代理协作