Correlations:氛围测试你的向量模型
Correlations:氛围测试你的向量模型在今年 ICLR 会议上,我们被问到最多且最有意思的问题是:像 Jina AI 这样的向量搜索模型提供商,除了在 MTEB 上做基准测试,会不会做些氛围测试 (Vibe-testing)?
来自主题: AI技术研报
11631 点击 2025-05-31 15:20

 搜索
在今年 ICLR 会议上,我们被问到最多且最有意思的问题是:像 Jina AI 这样的向量搜索模型提供商,除了在 MTEB 上做基准测试,会不会做些氛围测试 (Vibe-testing)?

好家伙,AI意外生成的内核(kernel),性能比人类专家专门优化过的还要好!
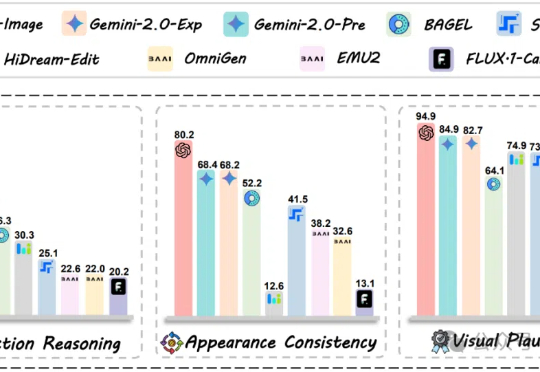
GPT-4o-Image也只能完成28.9%的任务,图像编辑评测新基准来了!360个全部由人类专家仔细思考并校对的高质量测试案例,暴露多模态模型在结合推理能力进行图像编辑时的短板。
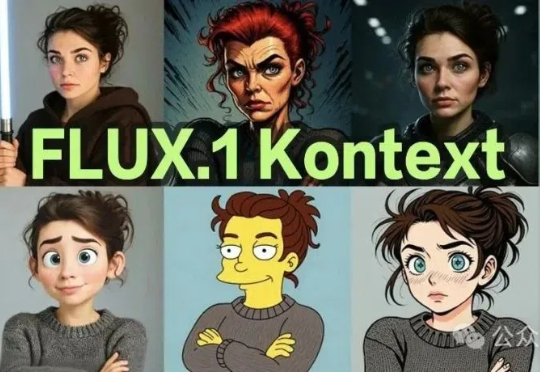
FLUX.1 Kontext是一款融合即时文本图像编辑与文本到图像生成的新一代模型,支持文本与图像提示,角色一致性强,速度快达GPT-Image-1的8倍。
现在,请大家一起数一下“1”、“2”。OK,短短2秒钟时间,一个准万亿MoE大模型就已经吃透如何解一道高等数学大题了!而且啊,这个大模型还是不用GPU来训练,全流程都是大写的“国产”的那种。
字节跳动开源了一个口碑还不错的模型——BAGEL (ByteDance Agnostic Generation and Empathetic Language model), 一个统一多模态基础模型。啥叫“统一”?一个模型就能同时理解和生成文本、图像、视频!

最近,Yoodli宣布完成了1370万美元的A轮融资,由Neotribe Ventures领投,Madrona和Cercano等现有投资者跟投。这使得他们的累计融资超过2000万美元。但让我感兴趣的不仅仅是融资数字,而是这家公司正在创建的全新品类:AI角色扮演。
在建筑行业中,管理人员很容易与现场实际情况脱节。他们需要同时处理多项任务,包括掌握成本动态、与所有利益相关方沟通,以及评估与承包商账单和绩效等方面相关的风险。
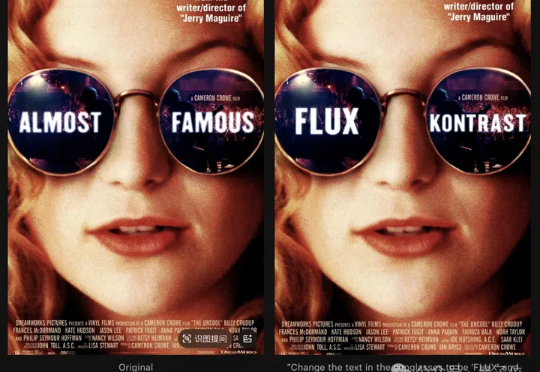
AI生图新突破!一个模型同时接受文本和图像输入。

“要是这些历史能在地图上‘动’起来就好了!” 这个念头一直在我脑子里盘旋。我渴望能有一张直观的地图,让我轻松洞悉历史发展的脉络。目前人工智能浪潮奔涌而至,其在文本、图像乃至动画领域的创造力令人瞩目。我便想着,能否借助AI之力,将《枪炮、病菌与钢铁》所描绘的世界,真实地投射到一张交互式的地图之上?