
智能体做报告哪家强?Fellou与扣子空间初体验对比
智能体做报告哪家强?Fellou与扣子空间初体验对比本周国内 AI 智能体市场依旧精彩纷呈,短短几天内多款智能体产品新推出市场,其中尤以Fellou和扣子空间最受关注。有意思的是,虽然这两个智能体产品的架构和定位截然不同,产品团队更有天壤之别,但由于操作界面类似,因此作为像我这样的普通用户而言,在体验前是很难说出两者的区别在什么地方。
来自主题: AI产品测评
15036 点击 2025-05-01 23:13

 搜索
本周国内 AI 智能体市场依旧精彩纷呈,短短几天内多款智能体产品新推出市场,其中尤以Fellou和扣子空间最受关注。有意思的是,虽然这两个智能体产品的架构和定位截然不同,产品团队更有天壤之别,但由于操作界面类似,因此作为像我这样的普通用户而言,在体验前是很难说出两者的区别在什么地方。
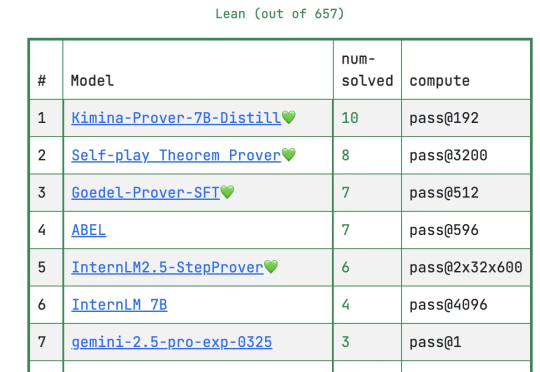
DeepSeek放大招!新模型专注数学定理证明,大幅刷新多项高难基准测试。在普特南测试上,新模型DeepSeek-Prover-V2直接把记录刷新到49道。目前的第一名在657道题中只做出10道题,为Kimi与AIME2024冠军团队Numina合作成果Kimina-Prover。

原本的我:我把话撂这儿了,就是DeepSeek R2来了,我都不更!有事假期结束再说。 看完豆包Case的我:哎嘿真香~不是我卷朋友们,实在是它这波真的很强,非常强,4o在我这里暂时都没那么香了。废话咱就不多说了,还是先简介然后上案例!
刚刚,LMArena陷入了巨大争议,斯坦福MIT和Ai2等的研究者联手发论文痛斥,这个排行榜已经被Meta等公司利用暗中操作排名!Karpathy也下场帮忙锤了一把。而LMArena官方立马回应:论文存在多处错误,指控不实。
来自英伟达和UIUC的华人团队提出一种高效训练方法,将LLM上下文长度从128K扩展至惊人的400万token SOTA纪录!基于Llama3.1-Instruct打造的UltraLong-8B模型,不仅在长上下文基准测试中表现卓越,还在标准任务中保持顶尖竞争力。
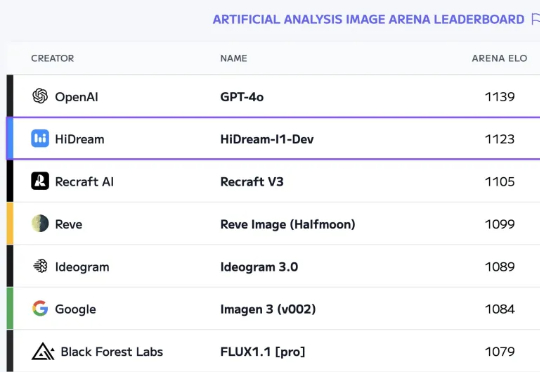
我又发现好东西了!前几天在 Artificial Analysis 上发现了一个新模型:17B 参数的国产模型 HiDream-I1排到第二名,和 GPT-4o 得分非常接近!
就在刚刚,DeepSeek-Prover-V2技术报告也来了!34页论文揭秘了模型的训练核心——递归+强化学习,让数学推理大提升。有人盛赞:DeepSeek已找到通往AGI的正确路径!
近日,以色列宣布与以色列AI“数字化身”制作平台eSelf、以色列最大的K12教科书出版商CET(Center for Educational Technology)合作,在全国范围内铺开AI辅导。
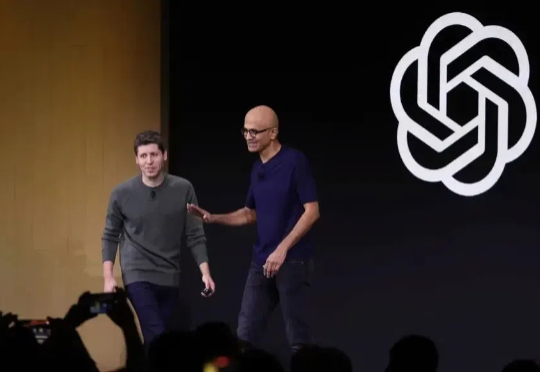
北京时间4月29日,据《华尔街日报》报道,OpenAI CEO萨姆·奥特曼(Sam Altman)曾表示,OpenAI与微软拥有堪称“科技界最好的合作关系”。然而,这段硅谷“联姻”已经岌岌可危。

连证件照都能在家用AI搞定,介么不是魔法嘛!这就是Aragon AI,一款利用AI生成专业证件照的软件,让人不出家门就能得到逼真的证件照。