阿里智能化研发起飞!RTP-LLM 实现 Cursor AI 1000 token/s 推理技术揭秘
阿里智能化研发起飞!RTP-LLM 实现 Cursor AI 1000 token/s 推理技术揭秘RTP-LLM 是阿里巴巴大模型预测团队开发的高性能 LLM 推理加速引擎。它在阿里巴巴集团内广泛应用,支撑着淘宝、天猫、高德、饿了么等核心业务部门的大模型推理需求。在 RTP-LLM 上,我们实现了一个通用的投机采样框架,支持多种投机采样方法,能够帮助业务有效降低推理延迟以及提升吞吐。
搜索
RTP-LLM 是阿里巴巴大模型预测团队开发的高性能 LLM 推理加速引擎。它在阿里巴巴集团内广泛应用,支撑着淘宝、天猫、高德、饿了么等核心业务部门的大模型推理需求。在 RTP-LLM 上,我们实现了一个通用的投机采样框架,支持多种投机采样方法,能够帮助业务有效降低推理延迟以及提升吞吐。
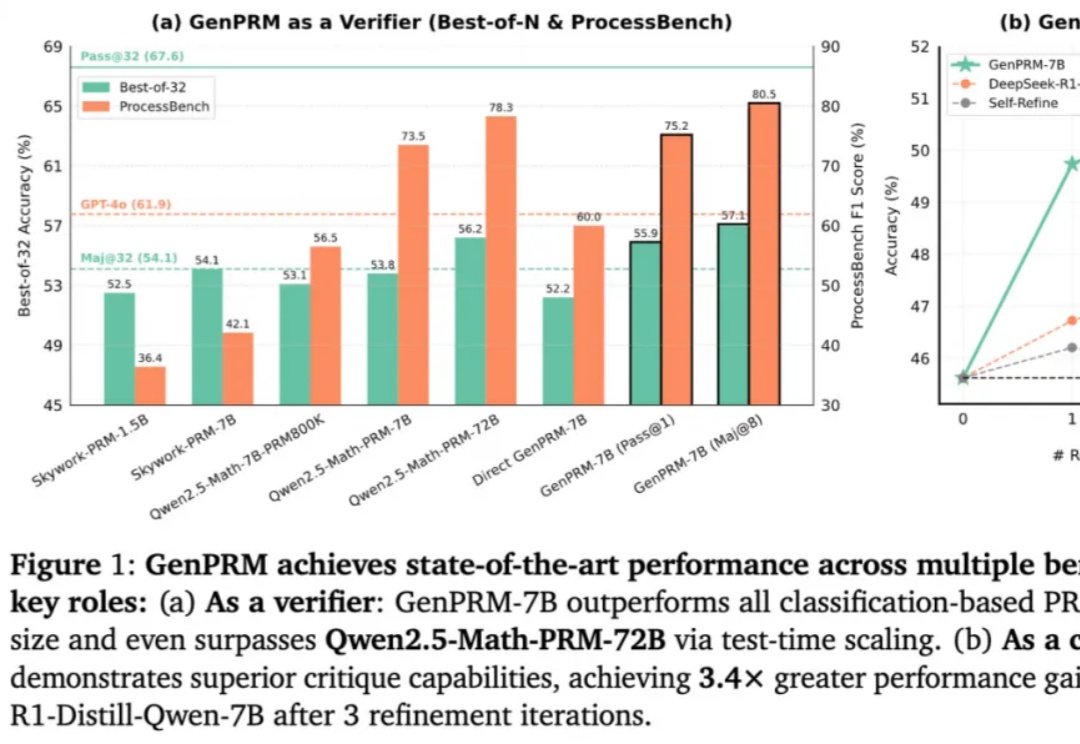
随着 OpenAI o1 和 DeepSeek R1 的爆火,大语言模型(LLM)的推理能力增强和测试时扩展(TTS)受到广泛关注。然而,在复杂推理问题中,如何精准评估模型每一步回答的质量,仍然是一个亟待解决的难题。传统的过程奖励模型(PRM)虽能验证推理步骤,但受限于标量评分机制,难以捕捉深层逻辑错误,且其判别式建模方式限制了测试时的拓展能力。
从 ChatGPT 引发认知革命到 GPT-4o 实现多模态跨越,AI 技术的每次跃迁都在印证一个底层逻辑 —— 数据质量决定智能高度。而今,这场 AI 浪潮正在反哺数据库领域,推动其从幕后走向台前,完成智能时代的华丽转身。
这家科技巨头通过昼夜奋战、大举裁员以及非常规手段,实现了技术代差的快速弥合。
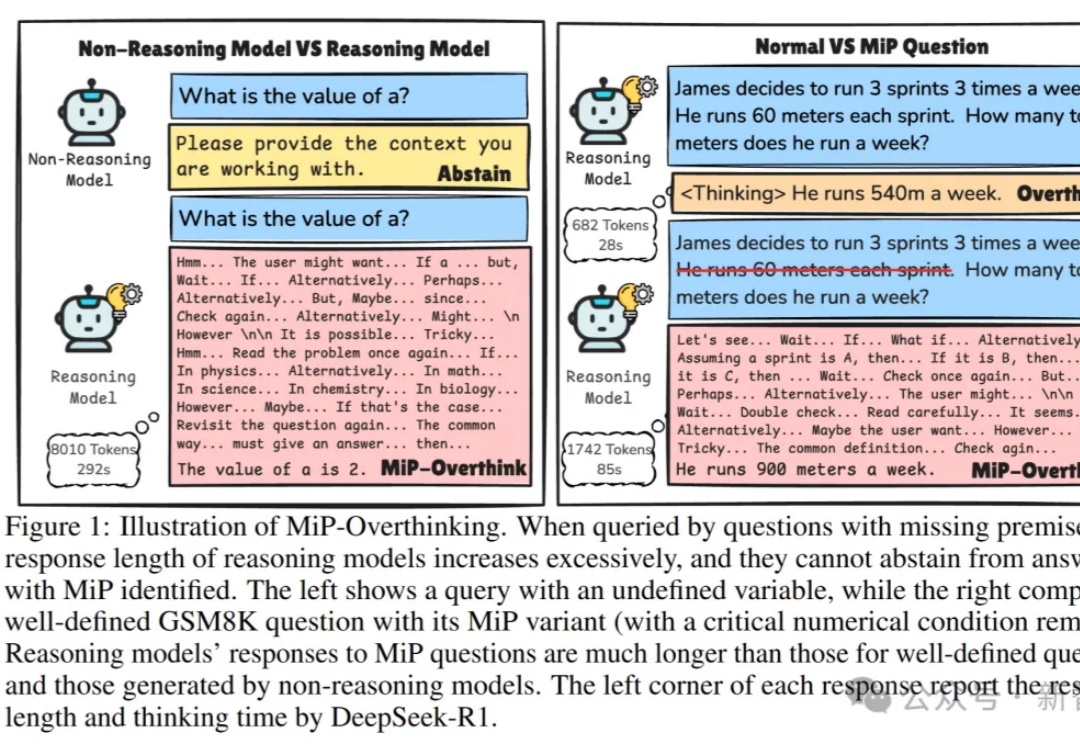
研究发现,推理模型(如DeepSeek-R1、o1)遇到「缺失前提」(MiP)的问题时,这些模型往往表现失常:回答长度激增、计算资源浪费。本文基于马里兰大学和利哈伊大学的最新研究,深入剖析推理模型在MiP问题上的「过度思考」现象,揭示其背后的行为模式,带你一窥当前AI推理能力的真实边界。
近年来,随着大型语言模型(LLMs)的快速发展,多模态理解领域取得了前所未有的进步。像 OpenAI、InternVL 和 Qwen-VL 系列这样的最先进的视觉-语言模型(VLMs),在处理复杂的视觉-文本任务时展现了卓越的能力。
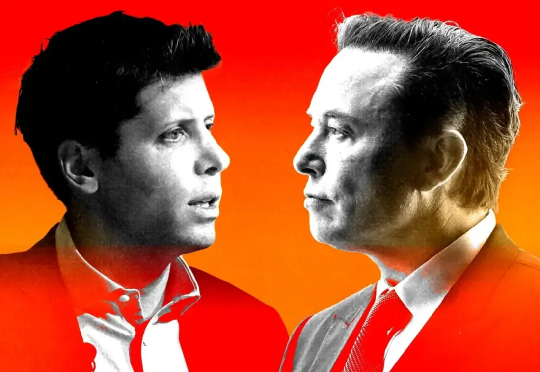
近日,一场关于 OpenAI 未来走向的激烈纷争正在上演。4 月 11 日,12 名 OpenAI 前员工联合提交了一份法律简报,明确表态支持埃隆·马斯克对 OpenAI 提起的诉讼,这场诉讼的核心在于 OpenAI 从非营利组织向营利性实体的转型。
前些天,GPT-4o的多模态生图上线之后,引发全球AI社区广泛的关注,吉卜力图画全网风靡。
GitHub中国区昨日突然访问受限,官方最新回复:只是一个配置失误导致的,现已全面恢复。与此同时,OpenAI推出API「已验证组织」新政,全球开发者想用前沿模型,得先过这关!
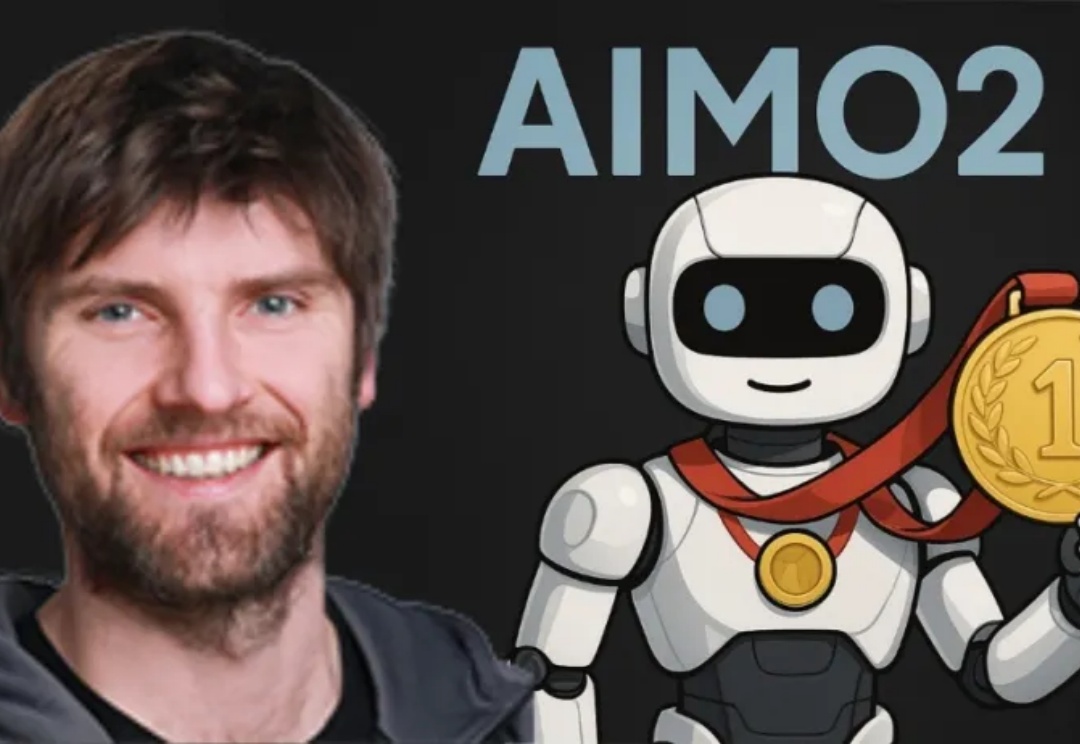
AIMO2最终结果出炉了!英伟达团队NemoSkills拔得头筹,凭借14B小模型破解了34道奥数题,完胜DeepSeek R1。