DeepSeek掀低成本革命,中科院系黑马闯入全球TOP 10!破解高精度-低能耗困局
DeepSeek掀低成本革命,中科院系黑马闯入全球TOP 10!破解高精度-低能耗困局2025年,中国大模型迎来最高光时刻。DeepSeek凭借深度推理、低成本强势崛起,中科院系AI企业祭出的YAYI-Ultra大模型在代码能力上超越GPT-4o,成功跻身OpenCompas榜单全球前十,高精度和低能耗兼而有之。
来自主题: AI资讯
9345 点击 2025-02-17 15:07

 搜索
2025年,中国大模型迎来最高光时刻。DeepSeek凭借深度推理、低成本强势崛起,中科院系AI企业祭出的YAYI-Ultra大模型在代码能力上超越GPT-4o,成功跻身OpenCompas榜单全球前十,高精度和低能耗兼而有之。
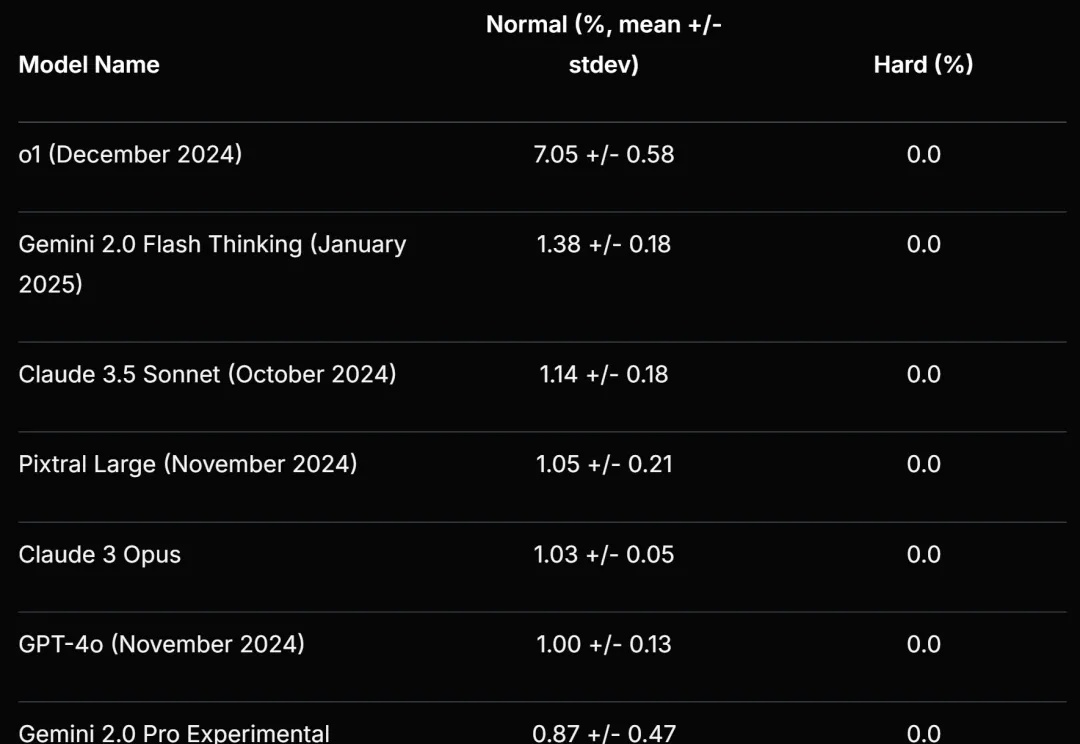
Scale AI 等提出的新基准再次暴露了大语言模型的弱点。
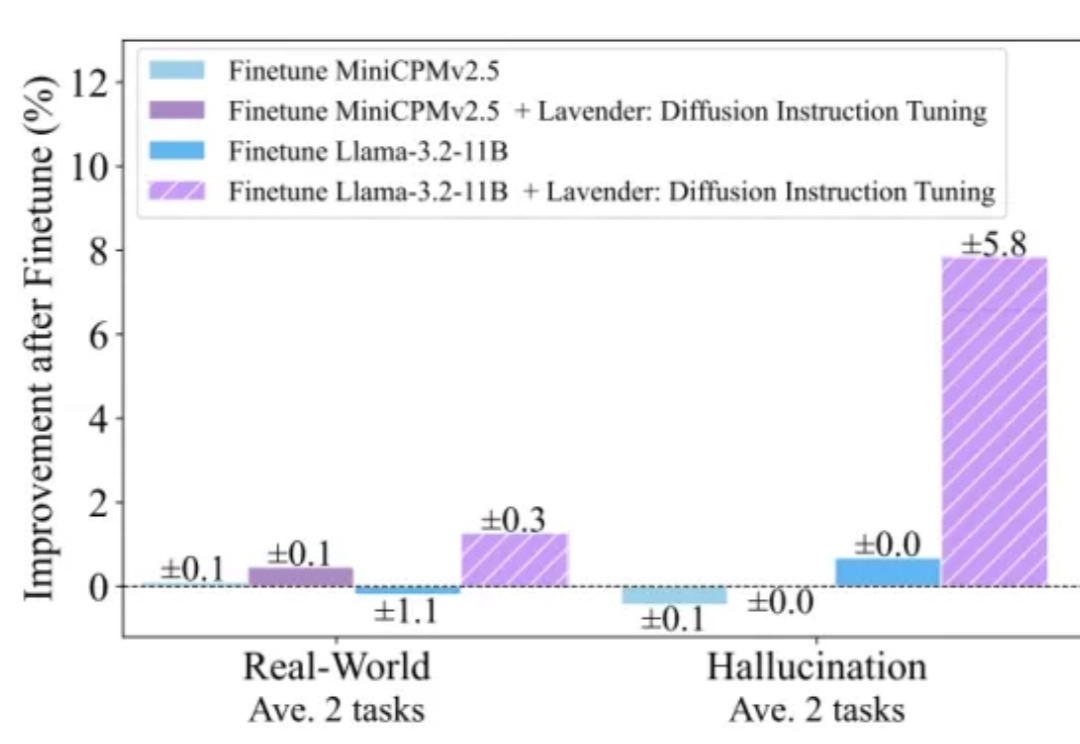
这次不是卷参数、卷算力,而是卷“跨界学习”——
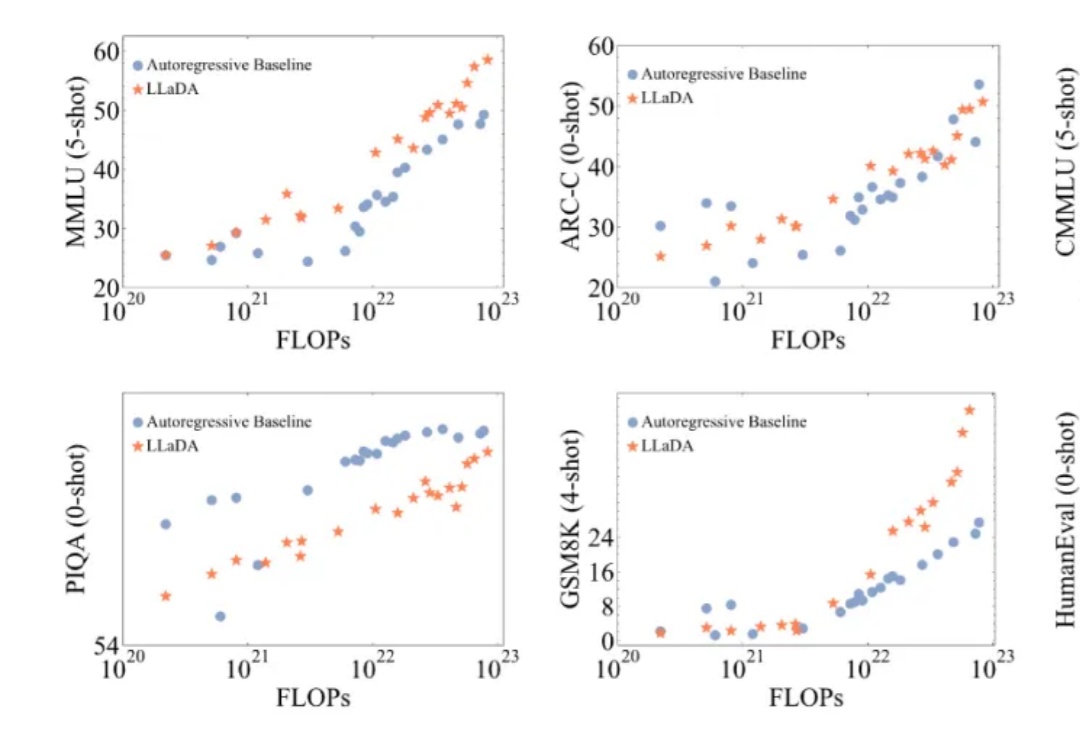
近年来,大语言模型(LLMs)取得了突破性进展,展现了诸如上下文学习、指令遵循、推理和多轮对话等能力。目前,普遍的观点认为其成功依赖于自回归模型的「next token prediction」范式。
全球空间智能第一股来了!来自中国,来自杭州。2月14日,空间智能独角兽群核科技正式向港交所递交招股说明书,启动IPO进程,冲击“全球空间智能第一股”,摩根大通、建银国际为联席保荐人。
据 BloomBerg 报道,OpenAI 的董事会正式拒绝了由埃隆·马斯克领导的一组投资者提出的以 974 亿美元收购控制这家人工智能公司的非营利组织的提议。

一张图、一句提示词,万物都能乱入你随手拍的视频。
一直以来,学术与实际产品的 Prompt 完全脱节,真实场景下,很多产品都聚焦情感陪伴,文案生成等开放任务里。而学术上这些任务没有明确的指标,无法量化也就没办法被比较,于是绝大部分的 Prompt 优化工作都聚焦在“刷榜”,例如怎么提升一个模型的代码/数学能力。我们今天跑的项目叫 SPO,具体什么意思并不重要,重要的是它把之前的所有问题全部解决了。

近年来,多模态大模型(MLLM)在视觉理解领域突飞猛进,但如何让大语言模型(LLM)低成本掌握视觉生成能力仍是业界难题!
北京时间2月16日,马斯克宣布,将于太平洋时间周一晚上8点(北京时间2月18日12:00)发布Grok 3大模型,届时将进行现场演示。马斯克称Grok 3有非常强大的推理能力,在测试中的表现超越包括DeepSeek在内的所有已发布的AI大模型模型。5G与6G公众号(ID:angmobile)注意到马斯克表示Grok 3的某些能力之强“让人感到可怕”。