将偏好学习引入模型训练,北大李戈团队新框架,可显著提升代码准确性与执行效率
将偏好学习引入模型训练,北大李戈团队新框架,可显著提升代码准确性与执行效率代码模型SFT对齐后,缺少进一步偏好学习的问题有解了。 北大李戈教授团队与字节合作,在模型训练过程中引入偏好学习,提出了一个全新的代码生成优化框架——CodeDPO。
来自主题: AI技术研报
9584 点击 2024-11-27 14:35

 搜索
代码模型SFT对齐后,缺少进一步偏好学习的问题有解了。 北大李戈教授团队与字节合作,在模型训练过程中引入偏好学习,提出了一个全新的代码生成优化框架——CodeDPO。
现在,Perplexity 可能又要推硬件产品了。Perplexity CEO 在 X 上发推文说,打算推一个简单的、低于 50 美金的硬件设备,它将以语音的方式(voice to voice)可靠地回答你的问题。
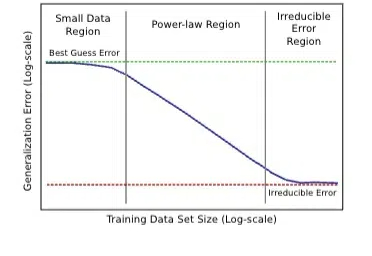
什么?Scaling Law最早是百度2017年提的?! Meta研究员翻出经典论文: 大多数人可能不知道,Scaling law原始研究来自2017年的百度,而非三年后(2020年)的OpenAI。

家人们,国产o1大模型,最近着实是有点火啊。 就在今天,昆仑万维的Skywork o1也开启了邀测。 那一波实测,这不就得安排一下么。
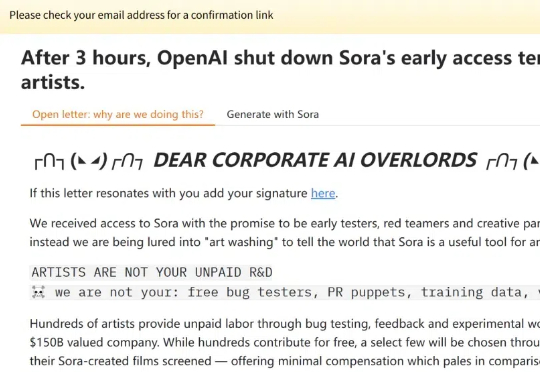
一觉醒来,挺突然的,Sora API 就这么泄露了。
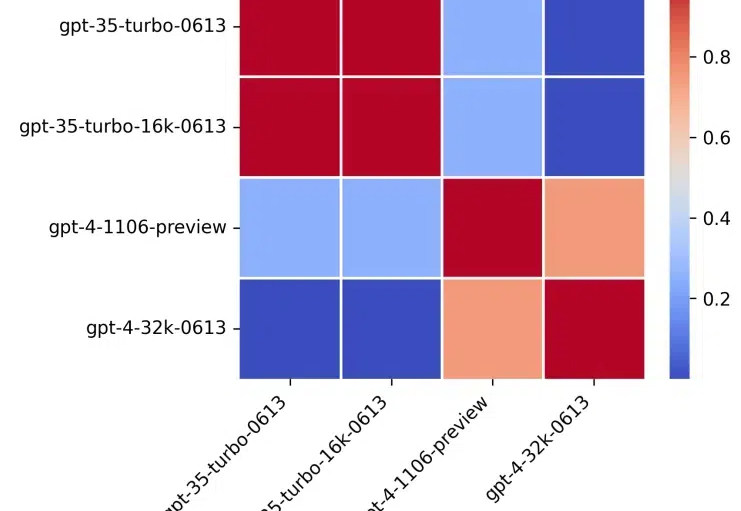
这篇文章研究了提示格式对大型语言模型(LLM)性能的影响。
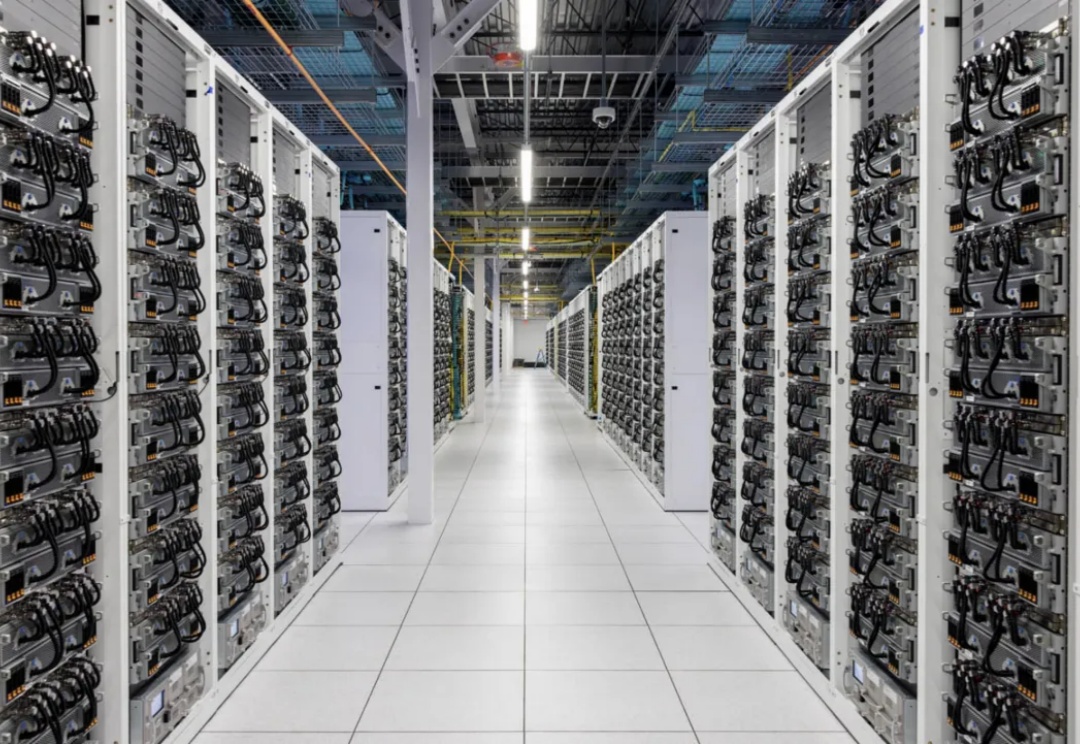
近日,美国政府效率部的马部长(Elon Musk)“跨到科技界”做了一个超级计算机/数据中心,名字叫做 Colossus (巨像)。

AI应用市场太小,烧钱营销为时尚早。

生成式AI热潮第三年,消费级AI应用受关注。
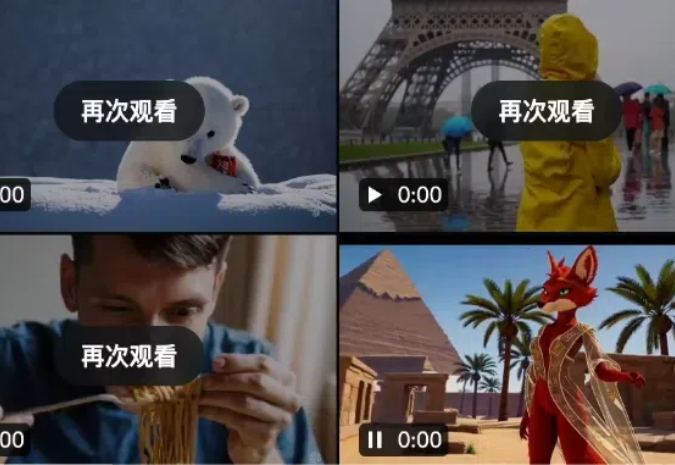
OpenAI Sora突遭泄露,似乎比2月的演示版又进化了!