多模态 Agent 记忆,为什么不能当成升级版多模态RAG?
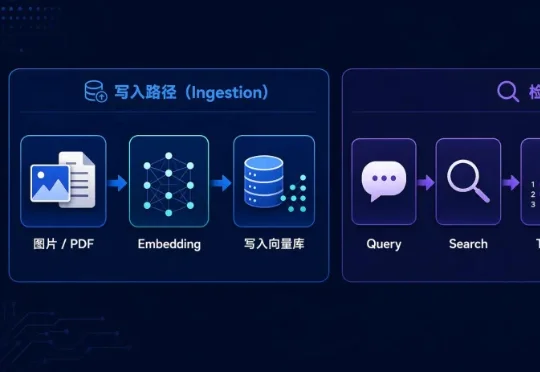
多模态 Agent 记忆,为什么不能当成升级版多模态RAG?多模态 Agent 的记忆系统,过去很容易被理解成一个升级版 RAG:图片、图表、PDF 进来之后,先抽取内容、做 embedding、写进向量库;用户提问时,再用 query 做检索,把命中的top-k图片、文档页或图表一并塞进上下文,再交给多模态模型回答。整个过程中,所有原始模态信息都会不加选择的塞给大模型。
搜索
多模态 Agent 的记忆系统,过去很容易被理解成一个升级版 RAG:图片、图表、PDF 进来之后,先抽取内容、做 embedding、写进向量库;用户提问时,再用 query 做检索,把命中的top-k图片、文档页或图表一并塞进上下文,再交给多模态模型回答。整个过程中,所有原始模态信息都会不加选择的塞给大模型。
最新世界模型 LingBot-World 2.0 正在试图实现的事情。「一个世界只需要几秒钟就能造出来」不再仅限于预制的世界,而是让每一次生成,都是一次全新的创造。这是一个秒级生成、支持实时交互的开源世界模型。
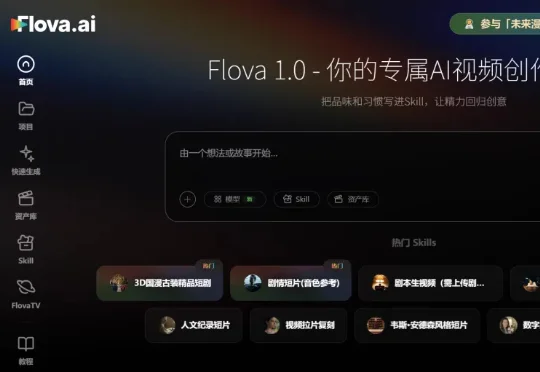
我最近又玩了一个新的视频制作平台,名叫 Flova,它的思路就是我上边说的这个方向。它不仅仅是一个调用单个模型的生成工具,而是一个面向 AI 视频 / AI 影视创作的全能六边形 Agent。
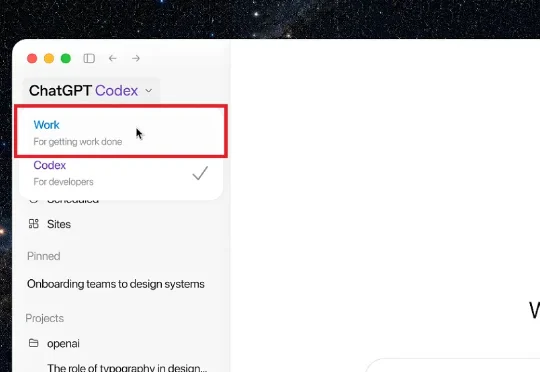
今天凌晨,OpenAI进行线上直播,正式面向全球用户推出新一代GPT-5.6模型家族,并同步发布Agent产品ChatGPT Work、全新ChatGPT桌面应用以及Hosted Sites(托管网站)三大产品更新。
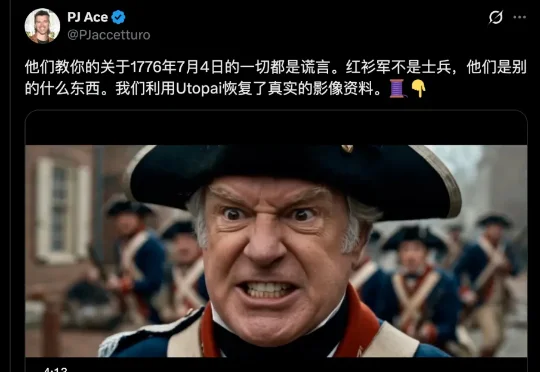
PJ Ace 在推文中兴奋地表示,他们借助 Utopai Studios 推出的下一代 AI 视频模型和智能体 PAI2.0, 以好莱坞灾难片大师罗兰·艾默里奇(Roland Emmerich)的视听风格,硬核「复活」了一段 250 年前激情澎湃、颠覆想象的美国独立日「真实历史影像」。
从ChatGPT掀起生成式AI浪潮到现在,不过短短两三年,AI能力的进化速度已经让"AI自我进化"这件事从科幻走进了现实。上个月,Anthropic在一份公开报告中预测,AI未来将进入"递归自我提升"(Recursive Self-Improvement, RSI)阶段,并呼吁人类共同为AI的发展设计出一个减速或暂停机制。
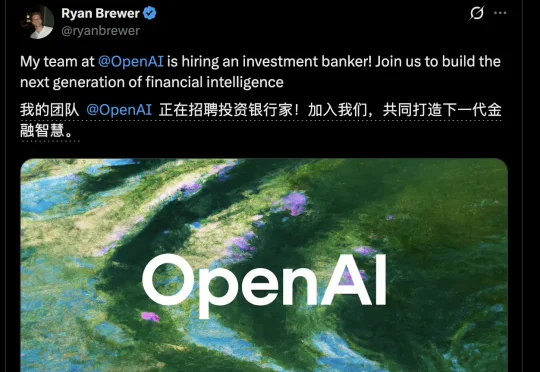
OpenAI开招新岗位:投行专家。核心任务就是教AI做投行的活儿,并且定义什么才算“做得好”。岗位全称Subject Matter Expert, Investment Banking,投资银行领域专家,隶属Applied AI团队,坐标旧金山。
最近发现了一个很便宜的平替方案,是在X上刷到的一个很有意思的开源项目:OpenSquilla 0.5.0(在Github 已经有5.5K Star)当时我还发了一篇推文。它揭示了一个非常反常识的事:一组便宜的国产模型以一定的方式组合起来,居然可以在公开评测上打赢国外更强的旗舰模型们(Claude Fable 5、Opus4.8、GPT-5.5)
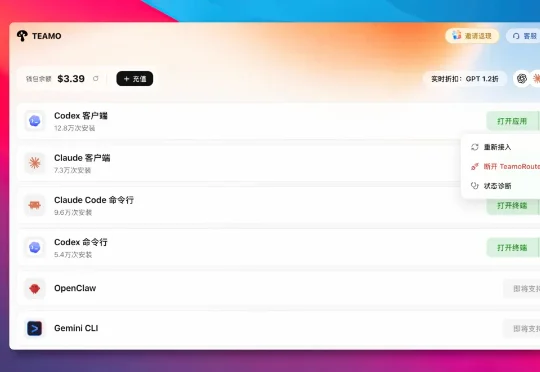
为了让大家快速上手,给大家推荐一下 Teamo客户端 ,一键完成 Codex 的下载、模型接入、客户端汉化以及各种省钱省心的配置骚操作,有手就行。而且现在模型还在大额补贴期,价格基本是一几折,二折,简直太疯狂了……
AI 行业尤其明显。Founder、产品经理、独立开发者都得有公众号/小红书/X 三件套(可能还要加一个即刻)。连平时不爱说话的 i 人,也要在朋友圈里输出几句“行业观察”。表达变多当然是好事,但话说多了,翻车概率也会跟着上来。