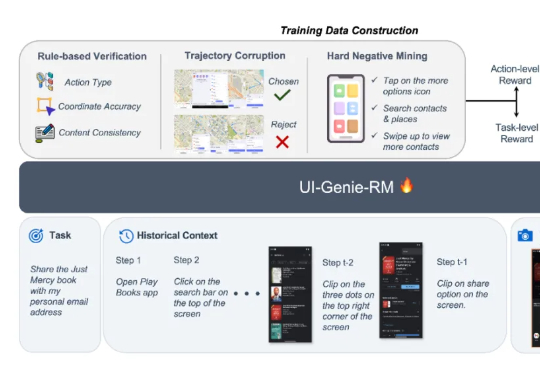
vivo AI Lab提出自我进化的移动GUI智能体,UI-Genie无需人工标注实现性能持续提升
vivo AI Lab提出自我进化的移动GUI智能体,UI-Genie无需人工标注实现性能持续提升本文来自于香港中文大学 MMLab 和 vivo AI Lab,其中论文第一作者肖涵,主要研究方向为多模态大模型和智能体学习,合作作者王国志,研究方向为多模态大模型和 Agent 强化学习。项目 le
来自主题: AI技术研报
9146 点击 2025-11-08 11:00

 搜索
本文来自于香港中文大学 MMLab 和 vivo AI Lab,其中论文第一作者肖涵,主要研究方向为多模态大模型和智能体学习,合作作者王国志,研究方向为多模态大模型和 Agent 强化学习。项目 le
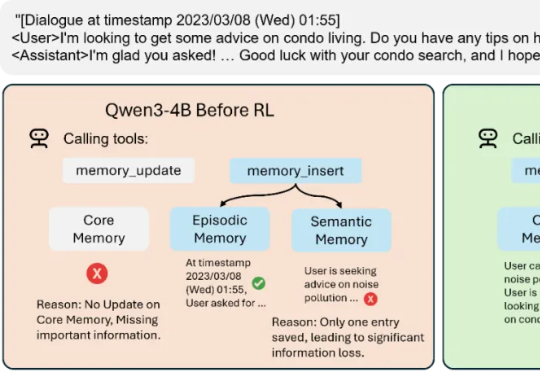
Mem-α 的出现,正是为了解决这一困境。由加州大学圣地亚哥分校的 Yu Wang 在 Anuttacon 实习期间完成,这项工作是首次将强化学习引入大模型的记忆管理体系,让模型能够自主学习如何使用工具去存储、更新和组织记忆。

正好上周(10月27日),MiniMax 公司发布了[2] M2 模型,代表了国产大模型的最新水平。我就想,可以测测它的实战效果,跟智谱公司的 GLM 4.6 和 Anthropic 公司的 Claude Sonnet 4.5 对比一下。毕竟它们都属于目前最先进的编程大模型,跟我们开发者切身相关。
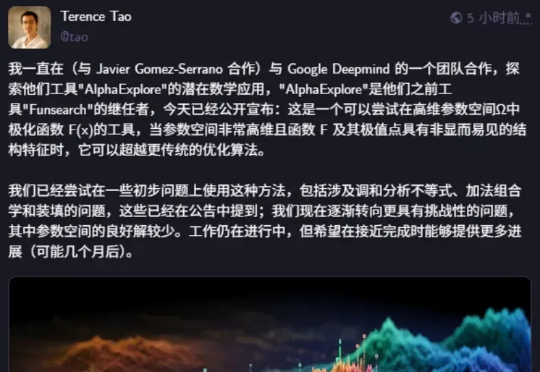
著名数学家陶哲轩发论文了,除了陶大神,论文作者还包括 Google DeepMind 高级研究工程师 BOGDAN GEORGIEV 等人。论文展示了 AlphaEvolve 如何作为一种工具,自主发现新的数学构造,并推动人们对长期未解数学难题的理解。AlphaEvolve 是谷歌在今年 5 月发布的一项研究,一个由 LLMs 驱动的革命性进化编码智能体。

两人小团队,仅用两周就复刻了之前被硅谷夸疯的DeepSeek-OCR?? 复刻版名叫DeepOCR,还原了原版低token高压缩的核心优势,还在关键任务上追上了原版的表现。完全开源,而且无需依赖大规模的算力集群,在两张H200上就能完成训练。

Kuyda 和她的团队开始痴迷于一个比喻:当前的聊天机器人相当于 AI 界面的 MS-DOS 时代,而将会出现某种类似 Windows 或 MacOS 的时刻。Wabi不是另一个代码生成工具,也不是开发者的辅助工具,而是一个真正面向大众市场的消费产品,专为非技术人员设计。
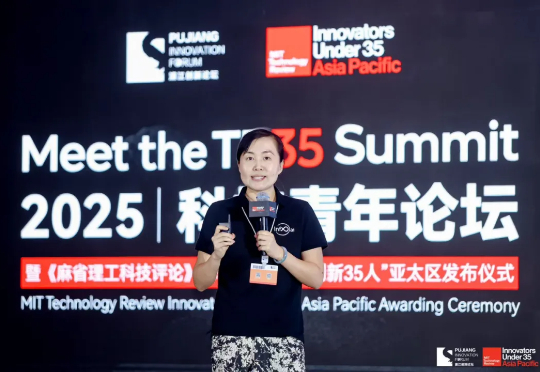
杨红霞,是中国大模型领域一个无法绕开的名字。人们从 M6 模型(阿里达摩院发布的万亿参数 AI 大模型)开始熟知她,而她又在最近走出创业隐匿模式,正式向世界宣告自己已经是一名创业者,并希望能够做出下一
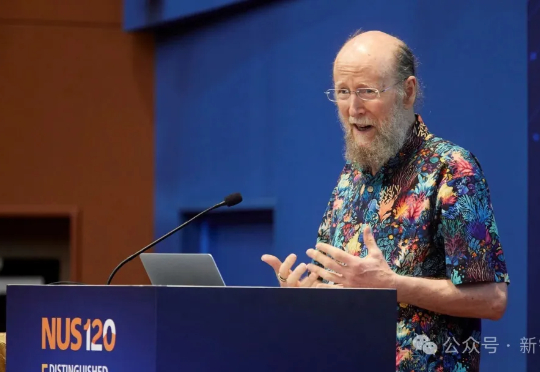
过去两年,AI靠模仿人类席卷世界。但强化学习之父Richard Sutton却说:「GenAI的时代正在结束。」他带着图灵奖的荣光,加入一家几乎没人听过的公司——ExperienceFlow.AI,他要让AI不靠人类数据喂养,而靠「经验」觉醒。
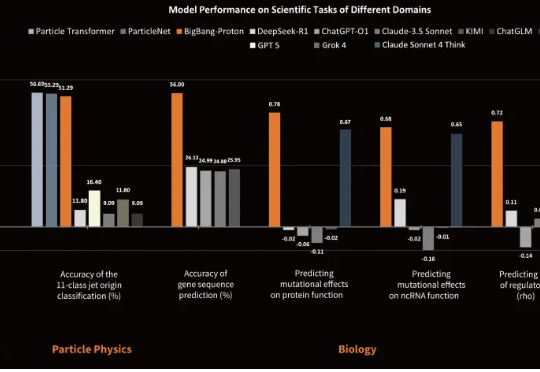
近日,专注于研发物质世界基座模型的公司超越对称(上海)技术有限公司(超对称)发布了新版基座模型 BigBang-Proton,成功实现多个真实世界的专业学科问题与 LLM 的统一预训练和推理,挑战了 Sam Altman 和主流的 AGI 技术路线。

目前,最先进的对齐方法是使用知识蒸馏(Knowledge Distillation, KD)在所有 token 上最小化 KL 散度。然而,最小化全局 KL 散度并不意味着 token 的接受率最大化。由于小模型容量受限,草稿模型往往难以完整吸收目标模型的知识,导致直接使用蒸馏方法的性能提升受限。在极限场景下,草稿模型和目标模型的巨大尺寸差异甚至可能导致训练不收敛。