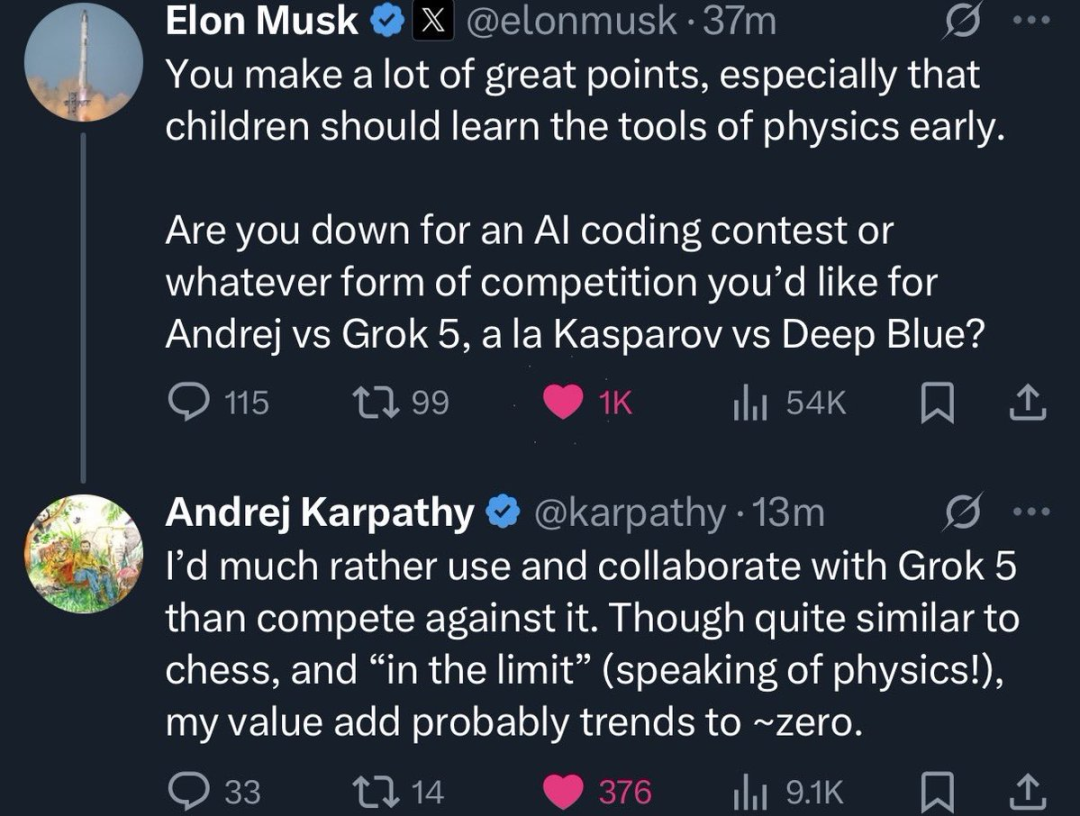
马斯克发起编程人机大战!卡帕西说了不
马斯克发起编程人机大战!卡帕西说了不拒绝世界首富是什么体验?卡帕西:这事我熟!刚刚,马斯克高调邀请卡帕西,与Grok 5来一场编程对决——就像当年的“卡斯帕罗夫大战深蓝”。
来自主题: AI资讯
10327 点击 2025-10-19 16:12

 搜索
拒绝世界首富是什么体验?卡帕西:这事我熟!刚刚,马斯克高调邀请卡帕西,与Grok 5来一场编程对决——就像当年的“卡斯帕罗夫大战深蓝”。
10月18日,在离开OpenAI,联合创办Thinking Machines后,Lilian Weng在硅谷难得地参加了一场公开对话。在这场华源Hysta2025年年会的炉边对谈里,她和主持人、硅谷知名投资人Connie Chan聊了聊她自己的研究经历、研究习惯、在OpenAI的研究思考和Thinking Machines 的发展方向。
我们又距离《Her》的世界更进一步。10 月 15 日,Sam Altman 在 X 上的一条推文炸了。 他的大意是:以前为了保护心理健康,ChatGPT 被我们限制得太严了……接下来,我们会放宽这些限制,让它更像人,更有个性。
在近日的一次访谈中,Andrej Karpathy深入探讨了AGI、智能体与AI未来十年的走向。他认为当前的「智能体」仍处早期阶段,强化学习虽不完美,却是目前的最优解。他预测未来10年的AI架构仍然可能是类似Transformer的巨大神经网络。

400元遥操95%机械臂,上海交大推出开源项目U-Arm! 目前它已在XArm6、Dobot CR5、ARX R5等多种机械臂真机上进行了遥操作的验证。
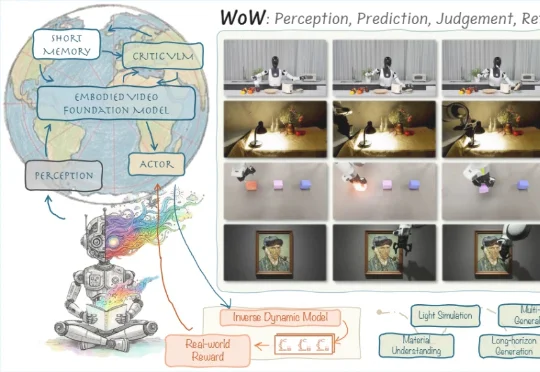
在「具身智能」与「世界模型」成为新一轮 AI 竞赛关键词的当下,来自北京人形机器人创新中心、北京大学多媒体信息处理国家重点实验室、香港科技大学的中国团队开源了全新的世界模型架构。
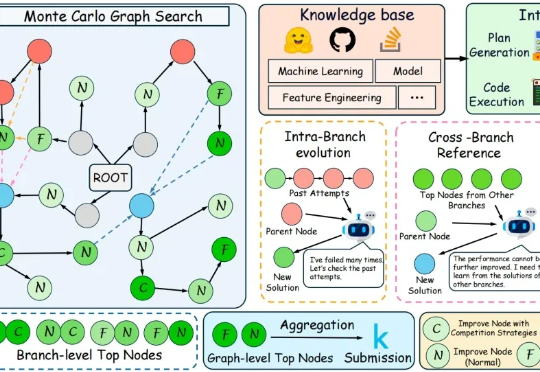
在代码层面,大语言模型已经能够写出正确而优雅的程序。但在机器学习工程场景中,它离真正“打赢比赛”仍有不小差距。
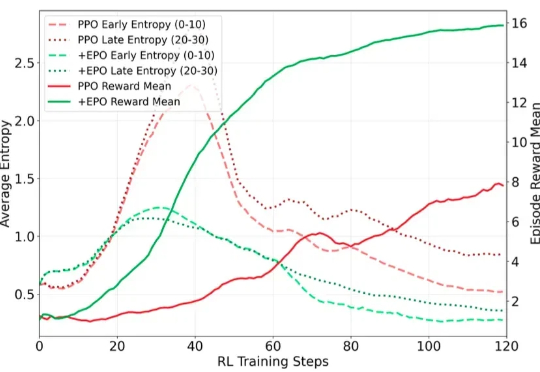
在训练多轮 LLM Agent 时(如需要 30 + 步交互才能完成单个任务的场景),研究者遇到了一个严重的训练不稳定问题:标准的强化学习方法(PPO/GRPO)在稀疏奖励环境下表现出剧烈的熵值震荡,导致训练曲线几乎不收敛。
硬刚Sora2,谷歌刚刚发布新动作——Veo3.1。
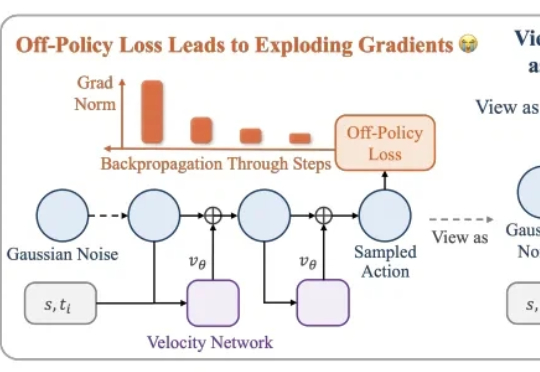
本文介绍了一种用高数据效率强化学习算法 SAC 训练流策略的新方案,可以端到端优化真实的流策略,而无需采用替代目标或者策略蒸馏。SAC FLow 的核心思想是把流策略视作一个 residual RNN,再用 GRU 门控和 Transformer Decoder 两套速度参数化。