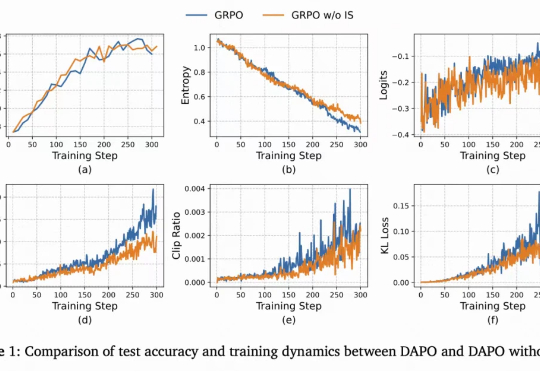
「重要性采样」并不「重要」?快手清华ASPO攻克重要性采样权重错配
「重要性采样」并不「重要」?快手清华ASPO攻克重要性采样权重错配从ChatGPT到DeepSeek,强化学习(Reinforcement Learning, RL)已成为大语言模型(LLM)后训练的关键一环。
来自主题: AI技术研报
9233 点击 2025-10-18 11:41

 搜索
从ChatGPT到DeepSeek,强化学习(Reinforcement Learning, RL)已成为大语言模型(LLM)后训练的关键一环。
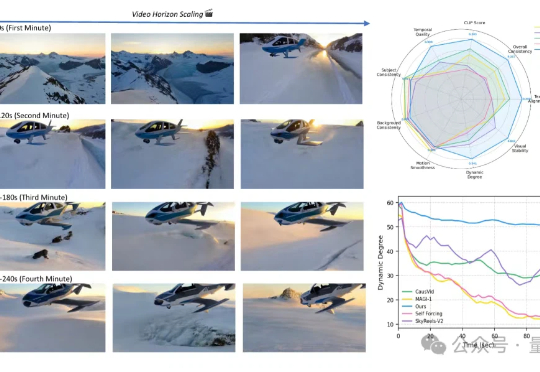
从5秒到4分钟,Sora2也做不到的分钟级长视频生成,字节做到了!这就是字节和UCLA联合提出的新方法——Self-Forcing++,无需更换模型架构或重新收集长视频数据集,就能轻松生成分钟级长视频,也不会后期画质突然变糊或卡住。
百度登顶全球第一!最新模型「PaddleOCR-VL」以0.9B参数量,在全球权威榜单OmniDocBench V1.5中以92.6分夺得综合性能第一,横扫文本识别、公式识别、表格理解与阅读顺序四项SOTA。
小米的最新大模型科研成果,对外曝光了。就在最近,小米AI团队携手北京大学联合发布了一篇聚焦MoE与强化学习的论文。而其中,因为更早之前在DeepSeek R1爆火前转会小米的罗福莉,也赫然在列,还是通讯作者。
OpenAI新研究团队,刚刚曝光了——OpenAI for Science,致力于构建加速数学和物理领域新发现的人工智能系统。
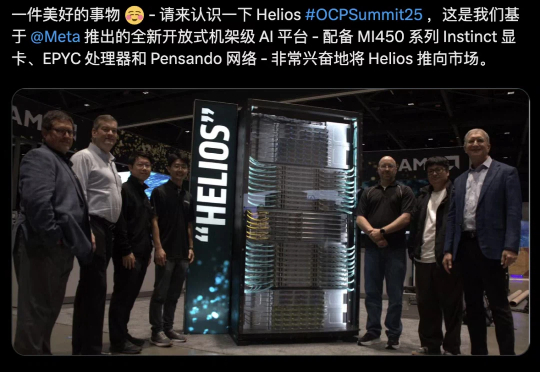
AMD再下一城!Oracle宣布自2026年第三季度起,将在其云基础设施(OCI)部署5万颗AMD Instinct™ MI450系列GPU,构建全新AI超级集群,并计划持续扩容。此举标志着AMD与Oracle的合作迈入新阶段,也被视为AMD在打破英伟达长期主导的AI算力生态中的又一关键突破。
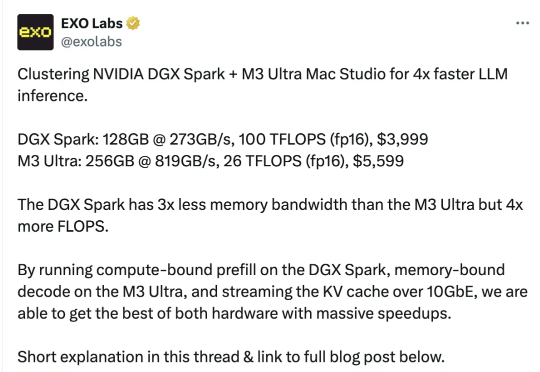
英伟达桌面超算,邪修玩法来了!两台DGX Spark串联一台苹果Mac Studio,就能让大模型推理速度提升至2.77倍。
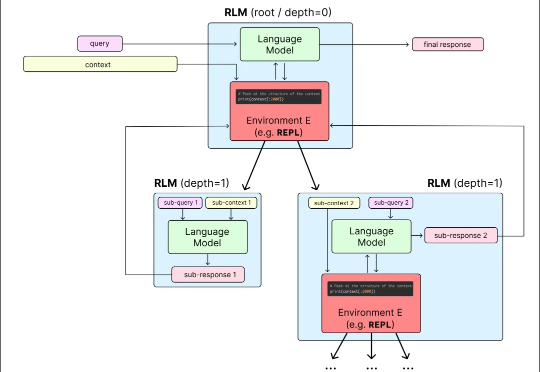
目前,所有主流 LLM 都有一个固定的上下文窗口(如 200k, 1M tokens)。一旦输入超过这个限制,模型就无法处理。 即使在窗口内,当上下文变得非常长时,模型的性能也会急剧下降,这种现象被称为「上下文腐烂」(Context Rot):模型会「忘记」开头的信息,或者整体推理能力下降。
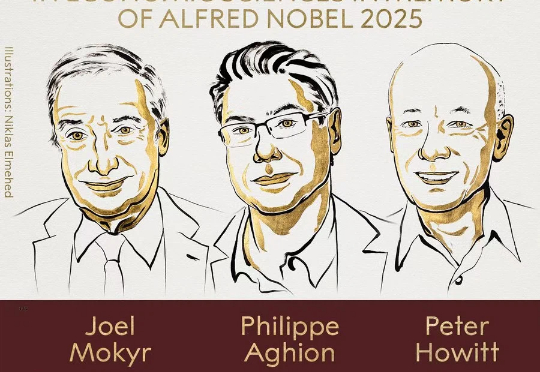
从蒸汽机到AI,自动化进程已持续两百年。在2017年,新晋诺奖得主Philippe Aghion就剖析AI对就业与增长的影响,强调它并非奇点催化剂,而是受「鲍莫尔成本病」制约的工具。
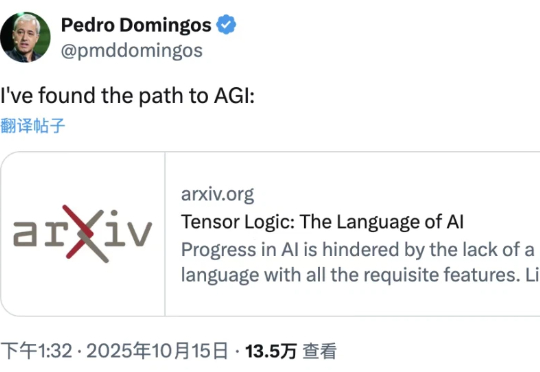
在通往AGI的道路上,人类欠缺的是一种合适的编程语言?华盛顿大学计算机学院教授Pedro Domingos在最新的独作论文中表示,当前AI领域使用的编程语言,无一例外全都存在缺陷。同时,Domingos还提出了一种新的统一语言,将AI逻辑统一成了张量表示。