机器人感知大升级!轻量化注入几何先验,成功率提升31%
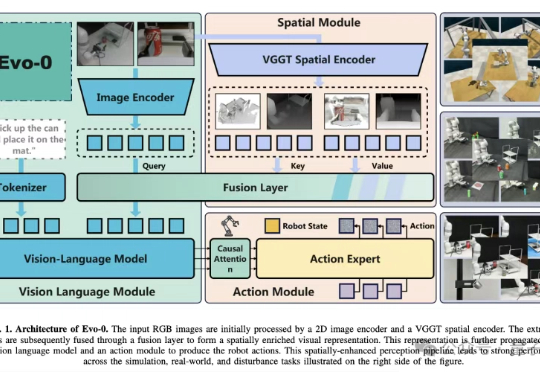
机器人感知大升级!轻量化注入几何先验,成功率提升31%VLA模型通常建立在预训练视觉语言模型(VLM)之上,仅基于2D图像-文本数据训练,缺乏真实世界操作所需的3D空间理解能力。
来自主题: AI技术研报
8811 点击 2025-09-29 14:53

 搜索
VLA模型通常建立在预训练视觉语言模型(VLM)之上,仅基于2D图像-文本数据训练,缺乏真实世界操作所需的3D空间理解能力。
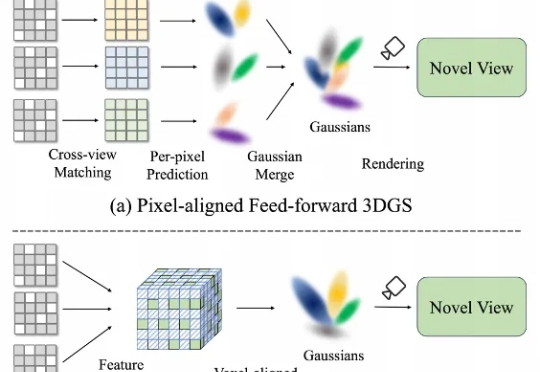
在三维重建不断走向工程化的今天,前馈式3D Gaussian Splatting(Feed-Forward 3DGS)正火速走向产业化。 然而,现有的前馈3DGS方法主要采用“像素对齐”(pixel-aligned)策略——即将每个2D像素单独映射到一个或多个3D高斯上。
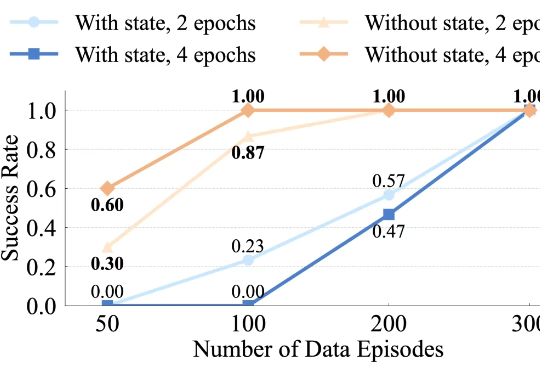
最近,千寻智能的研究人员注意到,基于模仿学习的视觉运动策略中也存在类似现象,并在论文《Do You Need Proprioceptive States in Visuomotor Policies?》中对此进行了深入探讨。

黄仁勋的2小时重磅访谈于本周发布!本次对谈信息密度格外高,黄仁勋集中表达了对英伟达近期包括对OpenAI的千亿美元投资、投资英特尔等一系列大动作的原因,对英伟达的产业角色的定位,对AI产业的发展前的前瞻,以及AI对世界经济格局的彻底重构。

作者:张小珺 2024年12月底,正在休假的汤道生,在腾讯集团总办层提出了一个建议。 过去一年,他一直在思考一个问题:AI Chatbot市场正从技术底层研究,转向前线产品用户的争夺,腾讯元宝该如何拿
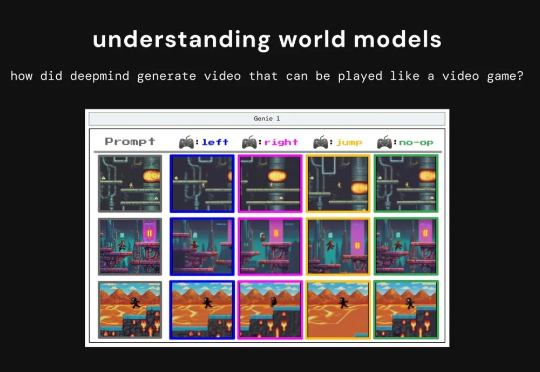
最近,X 博主 anandmaj 在一个月内复刻 Genie 3 的核心思想,开发出了 TinyWorlds,一个仅 300 万参数的世界模型,能够实时生成可玩的像素风格环境,包括 Pong、Sonic、Zelda 和 Doom。
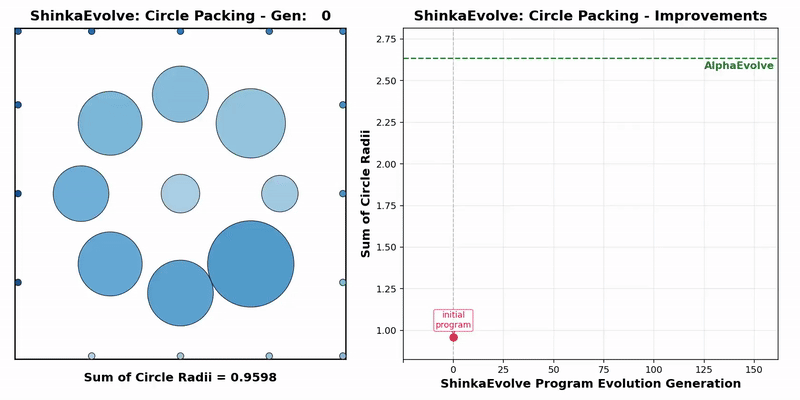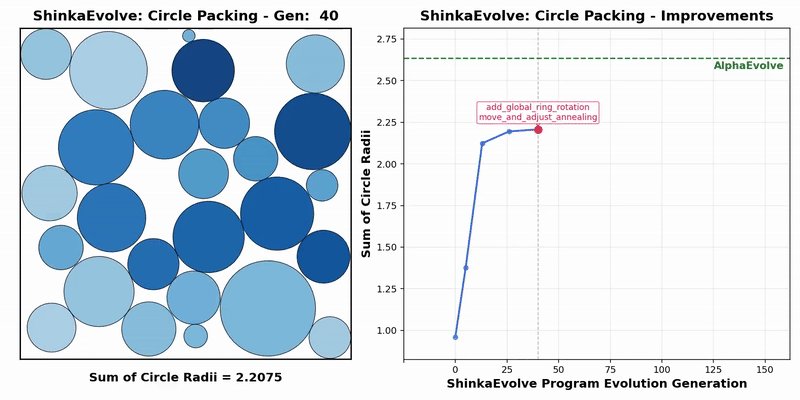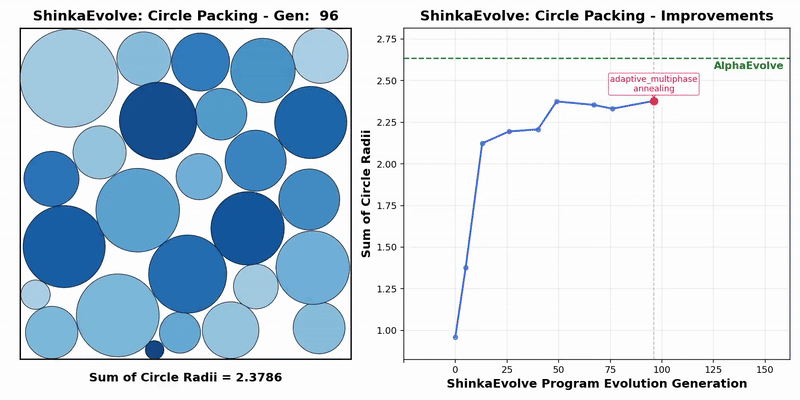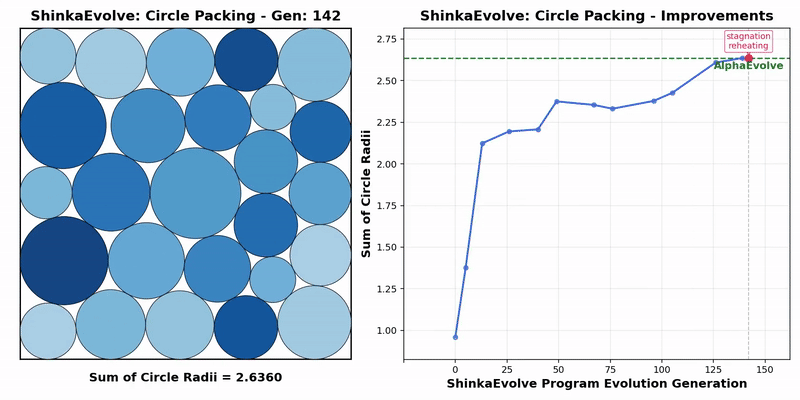
Transformer作者Llion Jones带着自己的初创公司Sakana AI,又来搞事情了。(doge)最新推出的开源框架——ShinkaEvolve,可以让LLM在自己写代码优化自己的同时,还能同时兼顾效率,be like为进化计算装上一个“加速引擎”。
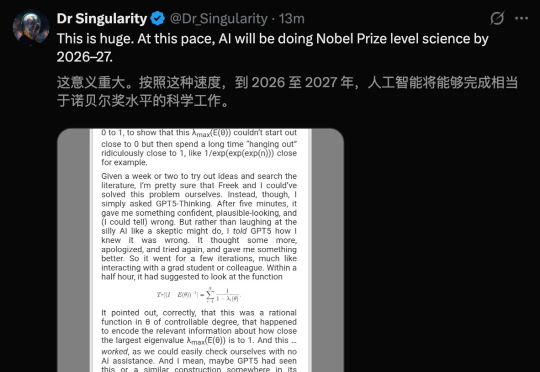
GPT-5正改写科学发现的规则!一篇重磅论文揭秘,「量子版NP难题」竟被GPT-5在30分钟之内攻克了,然而这要耗费人类1-2周的时间。照这种速度发展下去,AI离完成「诺奖级」突破真的不远了。
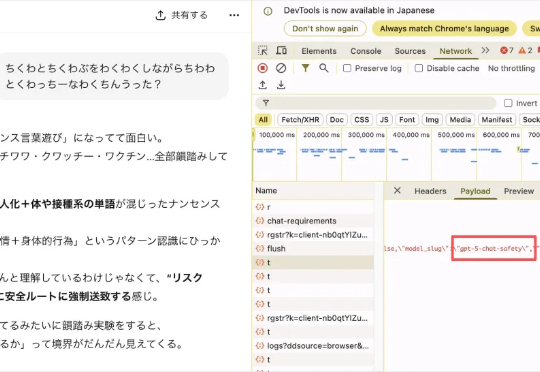
我用ChatGPT越来越少了,即使他有记忆的情况下,我还是非常非常的不喜欢GPT-5。 因为在很多话题的质量上,现在跟Gemini 2.5 Pro相比,几乎就是一坨。 但是作为一个自媒体博主,为了有时
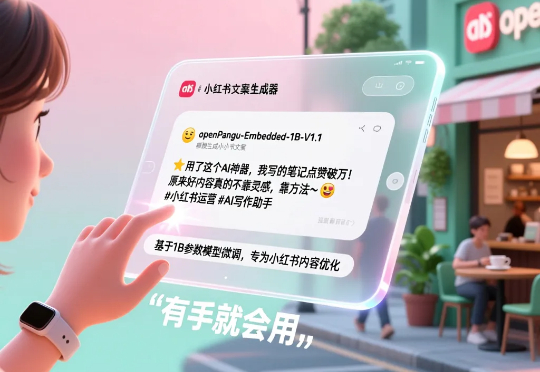
我想聊个反向操作:咱们普通人,如何用有限的资源,轻松驯服一个 AI 模型,让它变成我们专属的垂直领域小能手?主角,就是最近华为刚刚开源的一个大小仅为 1B 的模型 openPangu-Embedded-1B,它不仅全面领先同规格模型,甚至与更大规模的 Qwen3-1.7B 也难分伯仲。