超10万亿Tokens的高质量数据集是怎么炼成的?专访中国电信天翼AI阮宜龙
超10万亿Tokens的高质量数据集是怎么炼成的?专访中国电信天翼AI阮宜龙正所谓“得数据者得天下”,这家央企算是把高质量数据集给玩明白了——超过10万亿tokens的通用大模型语料数据,以及覆盖14个关键行业的专业数据集,总存储量高达350TB!
来自主题: AI资讯
10548 点击 2025-09-26 10:59

 搜索
正所谓“得数据者得天下”,这家央企算是把高质量数据集给玩明白了——超过10万亿tokens的通用大模型语料数据,以及覆盖14个关键行业的专业数据集,总存储量高达350TB!
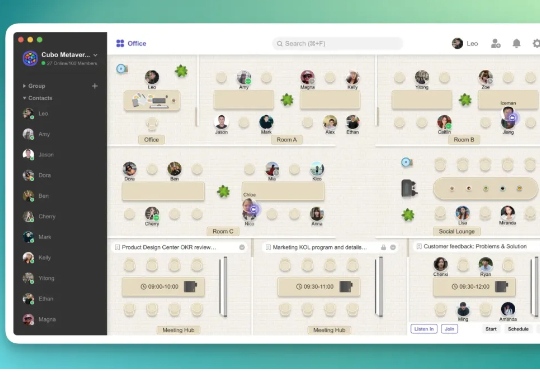
作为一名从移动互联网时代「穿越」而来的连续创业者,他经历过完整的周期起伏。而在 AI 时代,他选择不做具体的品类选手,而是成为一个「赛道服务者」。他创立的矩阵魔方 ( Cubo Group ),在过去一年多里,服务了超过 100 个 AI 产品的全球化营销,其中既有从零崛起的明星项目,也有在 4 个月内实现 ARR 从数百万到 5000 万美金的惊人增长案例。
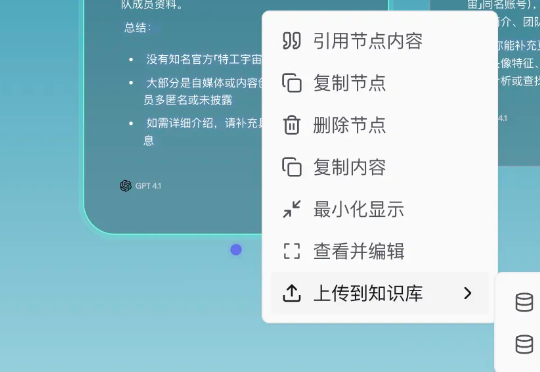
最近 flowith 推出了全新画布,交互形态全新升级,现在 AI 生成的任意内容,都可以被很方便的右键点击节点,存入任意知识库,后续工作都可以调用。说实话,flowith 是一款上手门槛比较高的产品,它不像一般对话式的 ChatBot 那样简单,

两项最新研究更新了Brynjolfsson最初提出的生产力悖论,揭示企业和入门级岗位所面临的危机——以及初创公司的机遇。20世纪90年代,Erik Brynjolfsson及其同事提出“生产力悖论”:尽管信息技术快速进步、电脑在工作场所普及,生产率增长却依旧乏力。该悖论指出,仅拥有新技术不足以推动生产力,还需组织变革、技能提升和业务流程创新等补充因素。
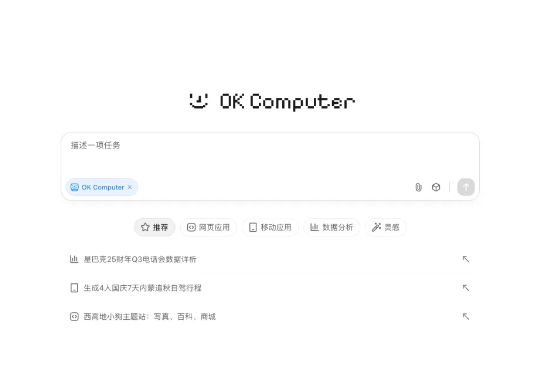
你有没有想过,AI助手的终极形态应该是什么样的?是更聪明的聊天机器人,还是能真正帮你完成复杂工作的数字员工?今天,当我体验了Kimi刚刚发布的"OK Computer" Agent模式后,我突然意识到:AI行业可能正在经历一次根本性的范式转变——从"回答问题"到"完成任务"。
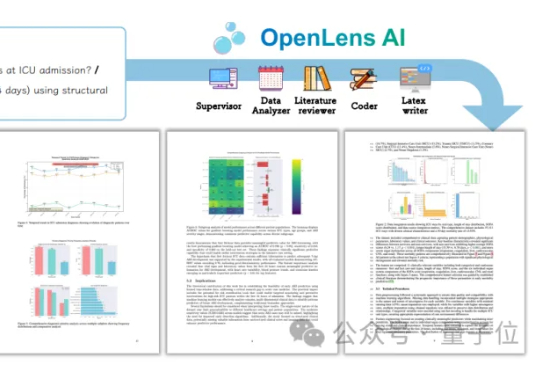
医学研究迎来“零人工”时代了?!清华大学自动化系索津莉课题组,发布首个专为医疗信息学设计的全自主AI研究框架——OpenLens AI。首次实现从文献挖掘→实验设计→数据分析→代码生成→可投稿论文的全链条自动化闭环。
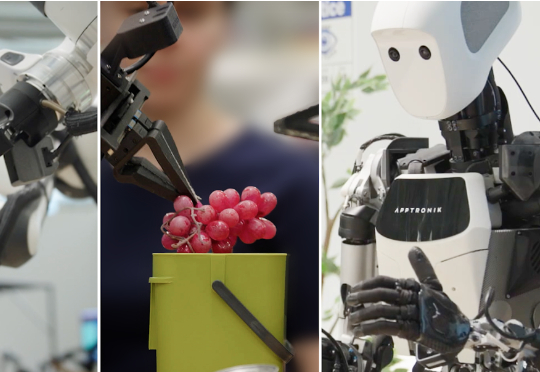
谷歌最新发布的Gemini Robotics 1.5系列模型,让机器人真正学会了「思考」,还能跨不同具身形态学习技能。这意味着,未来的机器人将成为和人类协作、主动完成复杂任务的智能伙伴。
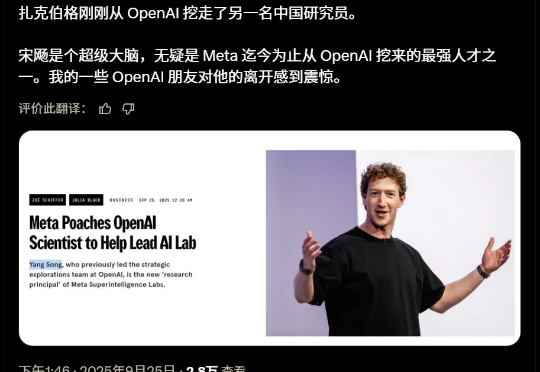
刚刚,Meta又从OpenAI挖来一员猛将——宋飏,扩散模型领域的核心人物,DALL·E 2技术路径的早期奠基者。他已正式加入Meta Superintelligence Labs,担任研究负责人,直接向他的师兄赵晟佳汇报。

这是 OpenAI CEO 山姆・奥特曼迄今为止最喜欢的 ChatGPT 功能。本周五凌晨,OpenAI 宣布推出 ChatGPT 新功能「Pulse」的预览版,首先向 Pro 订阅用户开放。ChatGPT 现在会每天晚上主动进行研究,根据你每天的聊天记录、反馈以及日历等关联应用提供个性化更新。每天清晨,你都会收到一组自定义生成的,可能感兴趣的内容,出现在手机 App 上。
今天,月之暗面正式发布全新 Agent,产品名别具一格:「OK Computer」。在大模型厂商进入战略对决关键时刻,这声“OK”,到底 O 不 OK?