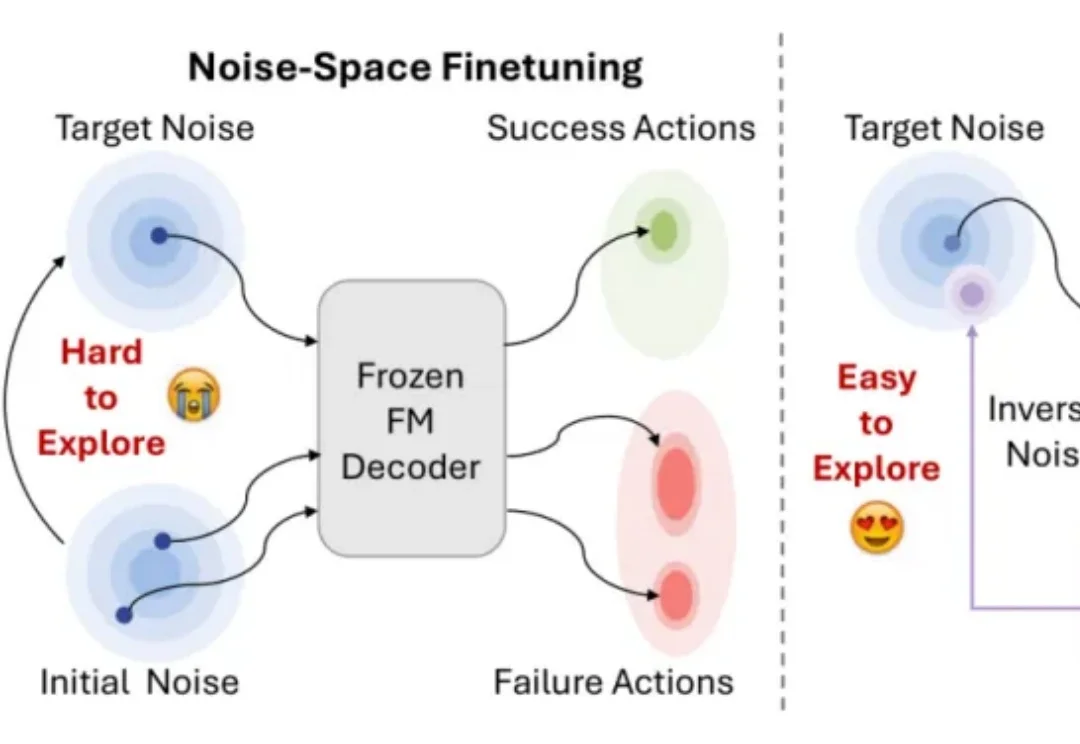
UniSteer用机械臂「拼豆」:让人类指导进入VLA噪声空间强化学习
UniSteer用机械臂「拼豆」:让人类指导进入VLA噪声空间强化学习视觉 - 语言 - 动作模型(Vision-Language-Action Model,VLA)正在成为机器人操作的重要基础模型。经过少量示范微调后,VLA 已经能够完成抓取、放置、堆叠等多种任务。然而,一旦任务涉及精密接触、狭小容差或分布外位置,模型的成功率仍会明显下降。
搜索
视觉 - 语言 - 动作模型(Vision-Language-Action Model,VLA)正在成为机器人操作的重要基础模型。经过少量示范微调后,VLA 已经能够完成抓取、放置、堆叠等多种任务。然而,一旦任务涉及精密接触、狭小容差或分布外位置,模型的成功率仍会明显下降。
Claude Fable 5.1发布数小时内即遭知名黑客Pliny the Liberator越狱,其在GitHub公开泄露了超27万字的完整系统提示词,曝光了模型的安全规则、记忆禁区及46个内置工具架构等核心细节。
「全球首个」多模态世界模型,来了!
大模型越来越强之后,企业究竟愿意为什么样的AI付钱?
现在的 AI 生图有点太强,像 images 2.0 这样的模型,一段 Prompt 敲进去,直接逼真到你怀疑现实的一切。
RSI,可能是 AI 世界里最像科幻的一个词。
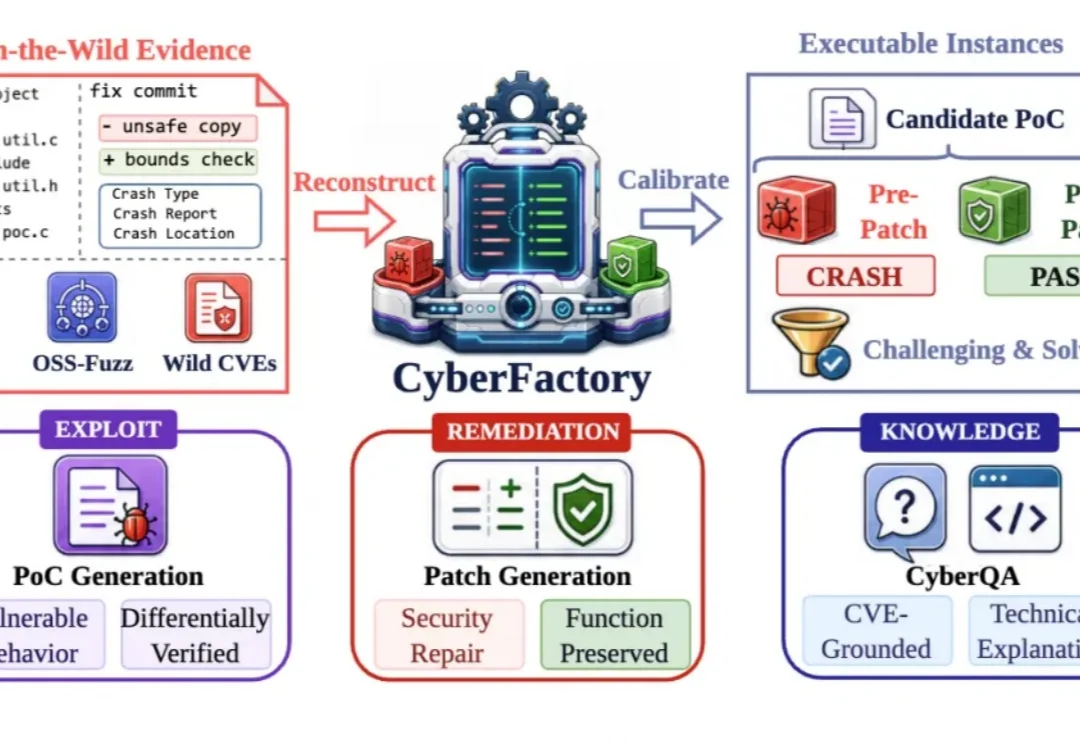
给一个大模型漏洞描述和代码仓库,它能否像安全研究人员一样,读代码、找入口、调用工具、构造输入,并反复验证自己的判断?
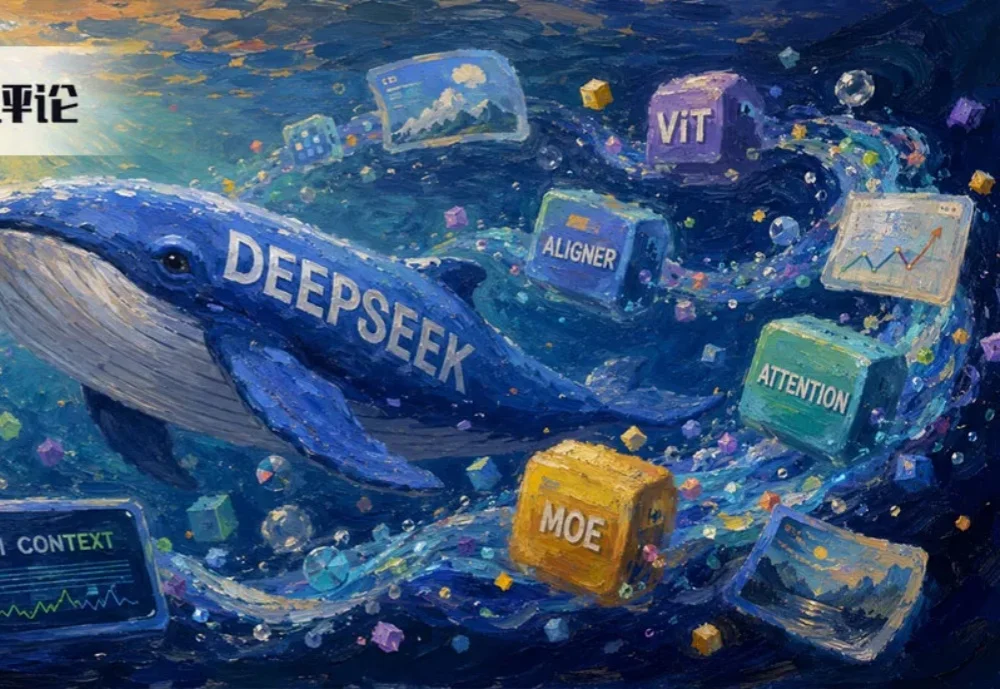
图片不只被编码,还直接参与 Attention、MoE 与 Agent 推理。
Anthropic 发布 Claude Fable 5.1 和 Claude Mythos 5.1,Fable 5.1 多项基准测试超越上一代,缓存读取成本降低 75%,典型任务整体费用降低约 25%、高 Agent 化任务最高降低约 45%,Mythos 5.1 则面向经审核的高风险领域合作伙伴提供更宽松能力并采用更严格的访问控制。
VAST完成B轮和B+轮共约30亿元融资,由经纬创投领投,累计融资约50亿元刷新3D原生智能领域融资纪录,同步发布行业首个支持原生四边面拓扑的3D原生基座模型Tripo P2.0。