ICML 2025 | 视频生成模型无损加速两倍,秘诀竟然是「抓住attention的时空稀疏性」
ICML 2025 | 视频生成模型无损加速两倍,秘诀竟然是「抓住attention的时空稀疏性」自 OpenAI 发布 Sora 以来,AI 视频生成技术进入快速爆发阶段。凭借扩散模型强大的生成能力,我们已经可以看到接近现实的视频生成效果。但在模型逼真度不断提升的同时,速度瓶颈却成为横亘在大规模应用道路上的最大障碍。
搜索
自 OpenAI 发布 Sora 以来,AI 视频生成技术进入快速爆发阶段。凭借扩散模型强大的生成能力,我们已经可以看到接近现实的视频生成效果。但在模型逼真度不断提升的同时,速度瓶颈却成为横亘在大规模应用道路上的最大障碍。
法国初创Mistral,刚刚推出定价碾压DeepSeek V3的模型,而模型性能,却超过Claude Sonnet 3.7的90%。不过在网友们的实测中,它却翻车了?有人建议:不必下载浪费流量和硬盘空间。
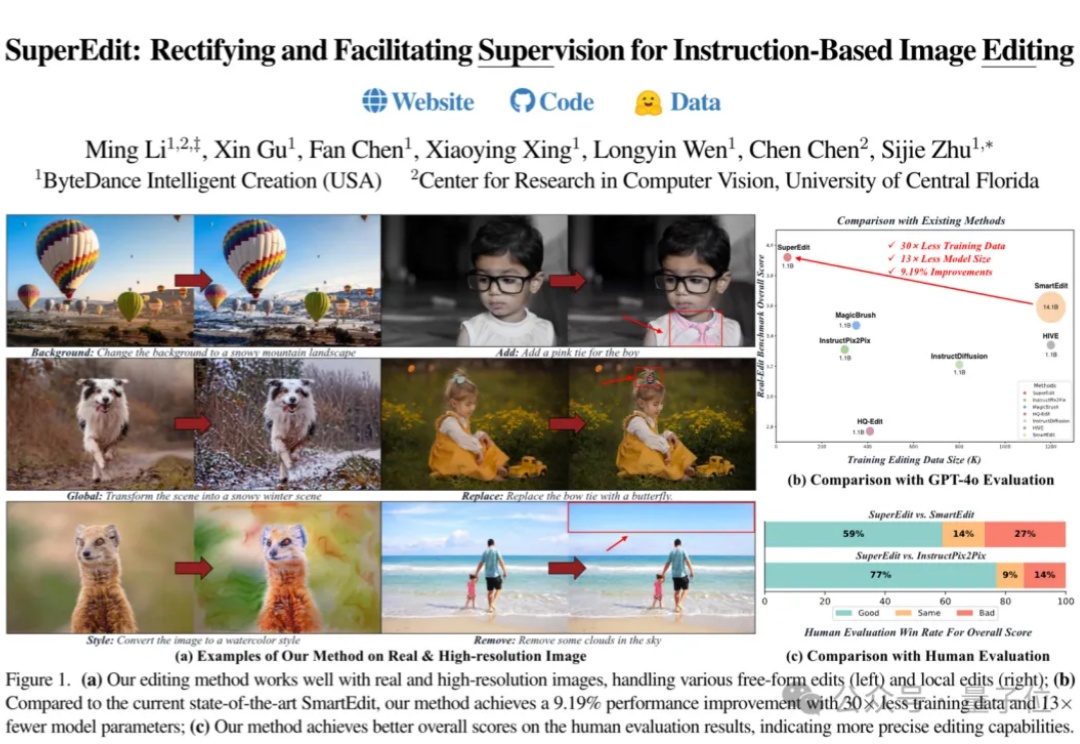
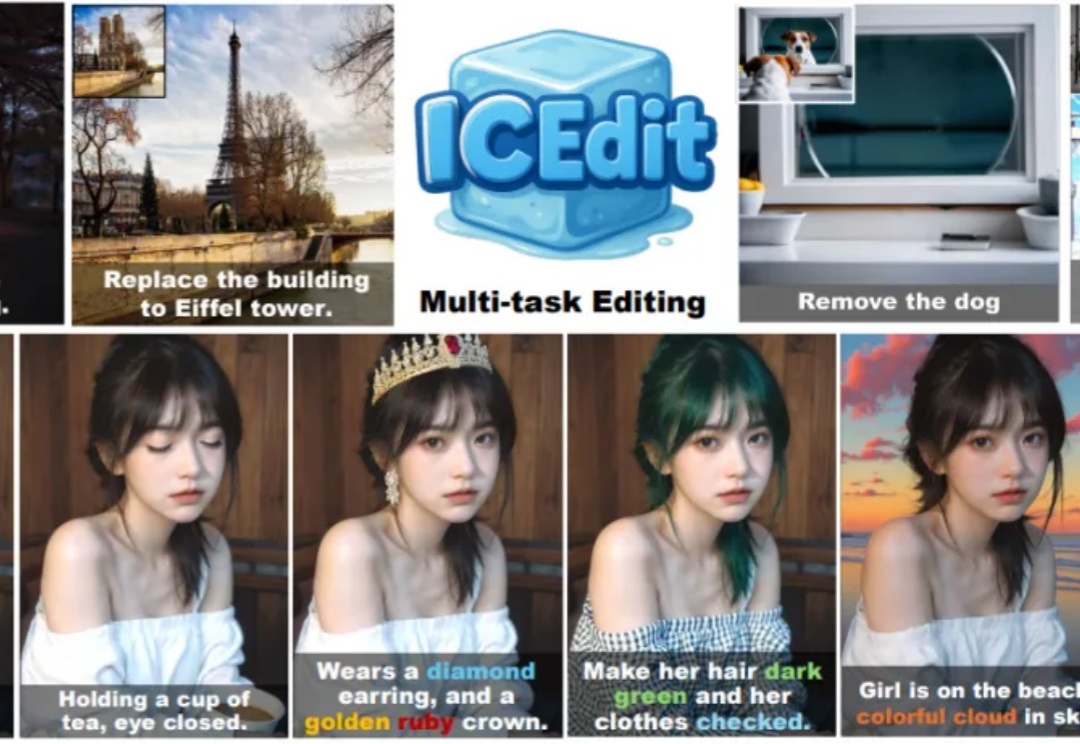
字节开源图像编辑新方法,比当前SOTA方法提高9.19%的性能,只用了1/30的训练数据和1/13参数规模的模型。
大家好,我是五一还在加班给大家写文章的Max 不会吧不会吧,不会真的只有我五一假期还在加班工作吧?
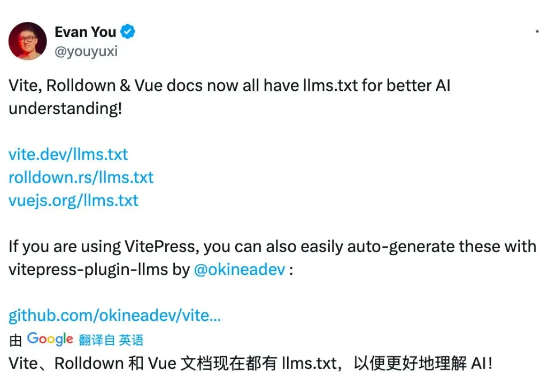
在前端开发领域,Vue 框架一直以其易用性和灵活性受到广大开发者的喜爱。而如今,Vue 生态在人工智能(AI)领域的应用上又迈出了重要的一步。尤雨溪近日宣布,Vue、Vite 和 Rolldown 的文档网站均已添加了llms.txt文件,这一举措旨在让大型语言模型(LLM)更方便地理解这些前端技术。
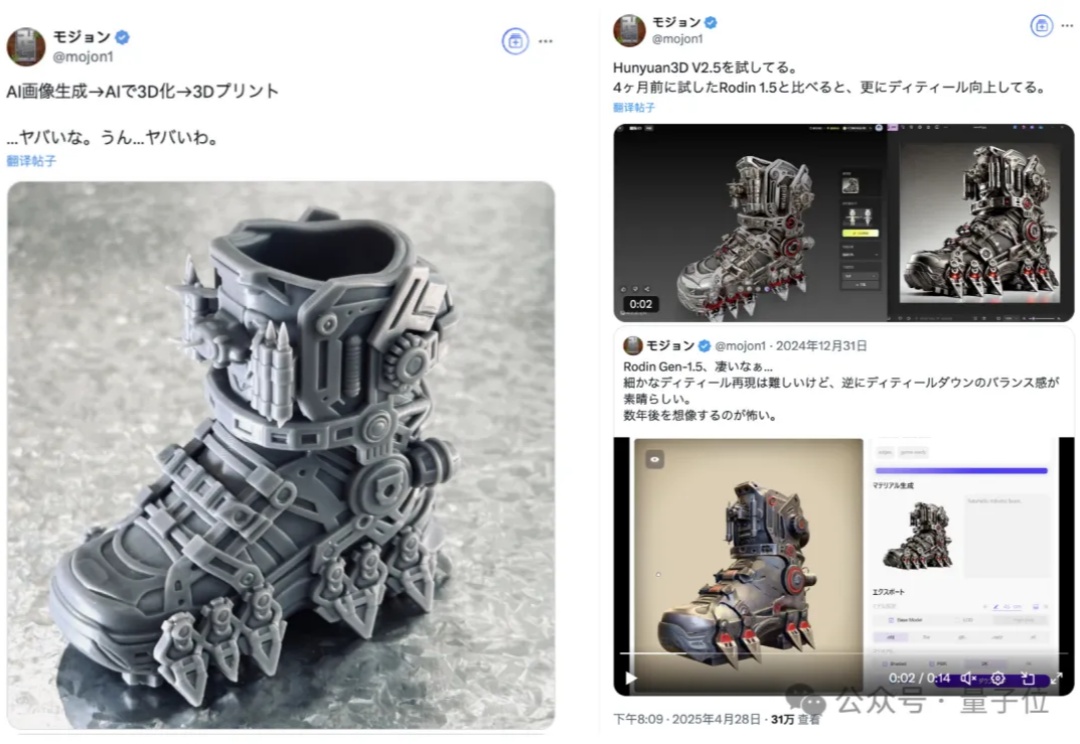
鹅厂最新的3D生成模型,狠狠地圈了一波粉,甚至有人拿它来创作小游戏动画了。
从 2023 年的 Sora 到如今的可灵、Vidu、通义万相,AIGC 生成式技术的魔法席卷全球,打开了 AI 应用落地的大门。
随着模型核心能力的进步,我们计划逐步将一些功能从产品中移除,或者至少将它们对用户极度隐藏,除非他们真的需要。
本周三,知名 AI 创业公司,曾发布「全球首个 AI 软件工程师」的 Cognition AI 开源了一款使用强化学习,用于编写 CUDA 内核的大模型 Kevin-32B。
随着Gemini、GPT-4o等商业大模型把基于文本的图像编辑这一任务再次推向高峰,获取更高质量的编辑数据用于训练、以及训练更大参数量的模型似乎成了提高图像编辑性能的唯一出路。然而浙大哈佛这个团队却反其道而行之,仅用以往工作0.1%的数据量(获取自公开数据集)和1%的训练参数,以极低成本实现了图像的高质量编辑,在一些方面媲美甚至超越商业大模型!