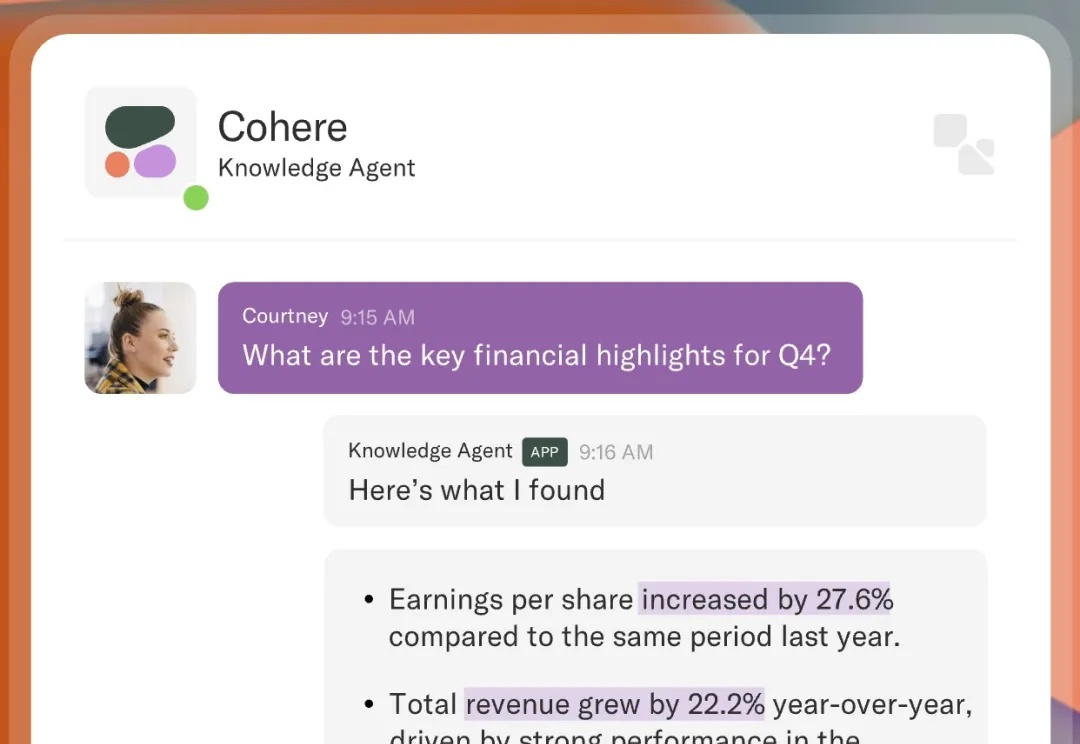
Cohere推出新一代多模态搜索模型Embed 4,在数据处理长文本建模和跨模态能力显著提升
Cohere推出新一代多模态搜索模型Embed 4,在数据处理长文本建模和跨模态能力显著提升2025年4月16日,Cohere 发布了其最新一代多模态搜索模型 Embed 4,在多模态数据处理、长文本建模和跨模态检索能力上实现了显著提升,进一步巩固了其在企业级 AI 搜索领域的领先地位。
来自主题: AI资讯
7530 点击 2025-04-18 10:16

 搜索
2025年4月16日,Cohere 发布了其最新一代多模态搜索模型 Embed 4,在多模态数据处理、长文本建模和跨模态检索能力上实现了显著提升,进一步巩固了其在企业级 AI 搜索领域的领先地位。
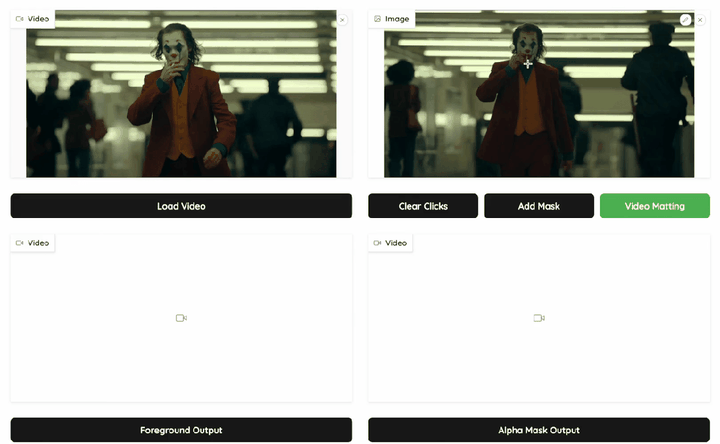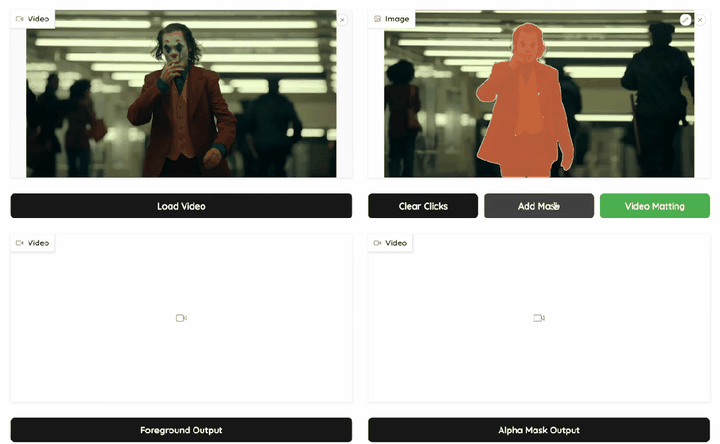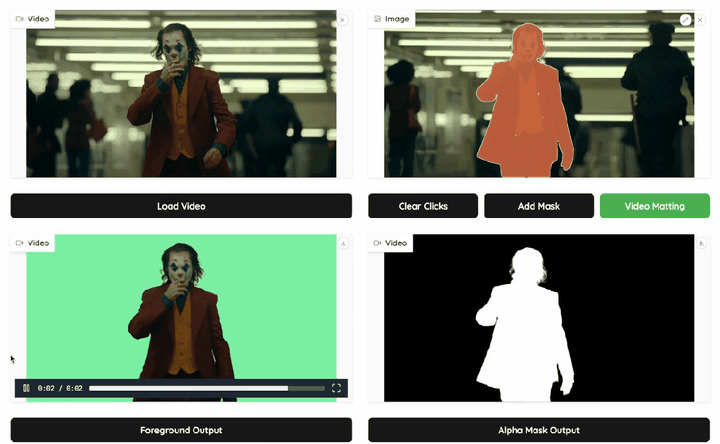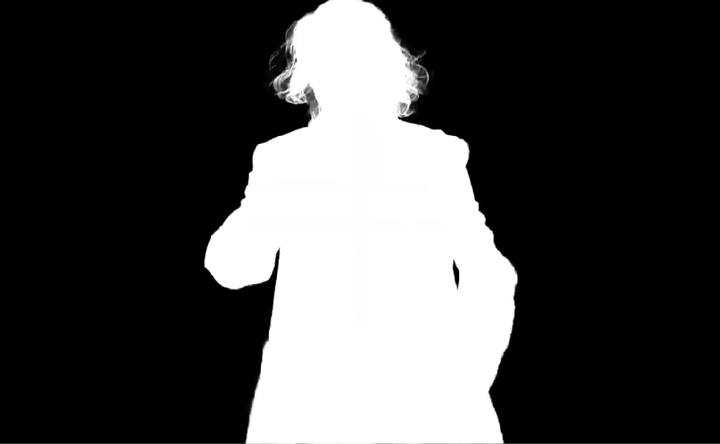
视频人物抠像技术在电影、游戏、短视频制作和实时视频通讯中具有广泛的应用价值,但面对复杂背景和多目标干扰时,如何实现一套兼顾发丝级细节精度及分割级语义稳定的视频抠图系统,始终是个挑战。
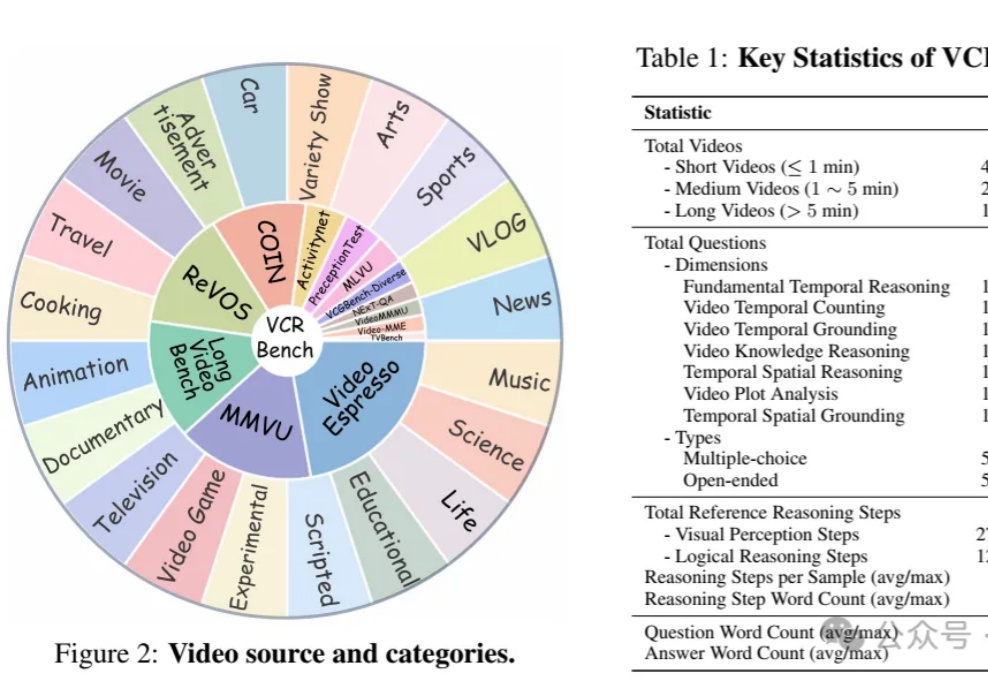
视频理解的CoT推理能力,怎么评?

AI趋势正在“中场休息”,在此之前训练>评估,在此之后评估>训练。
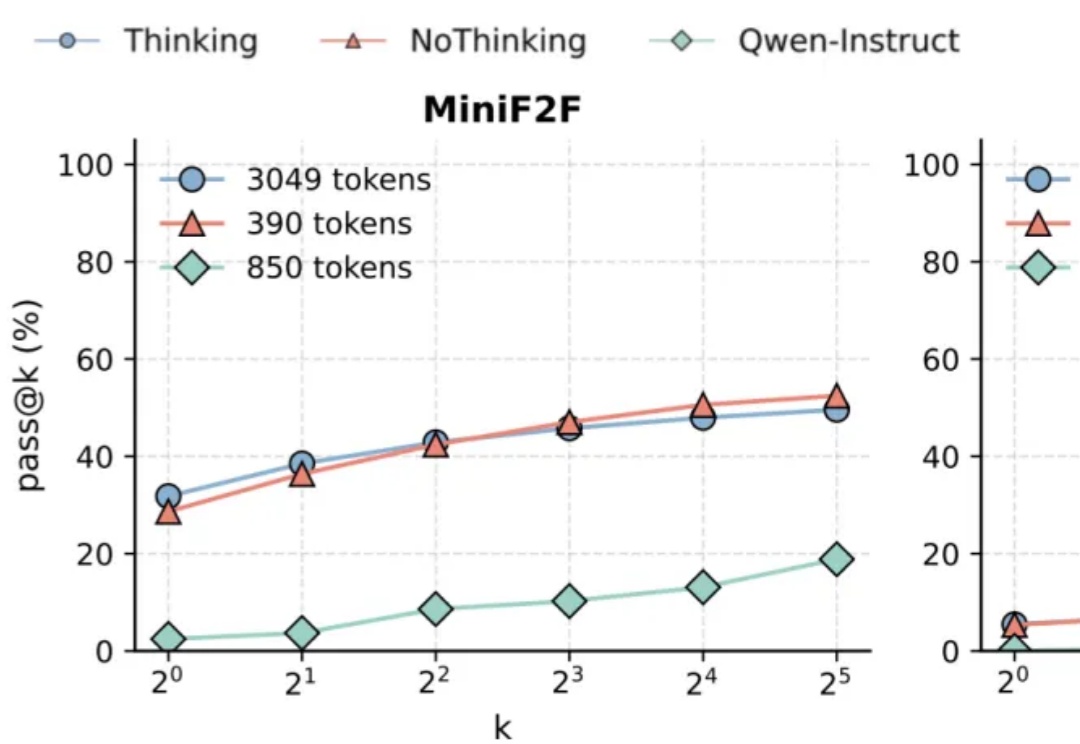
让推理模型不要思考,得到的结果反而更准确?
多模态生成技术持续突破内容创作的边界。

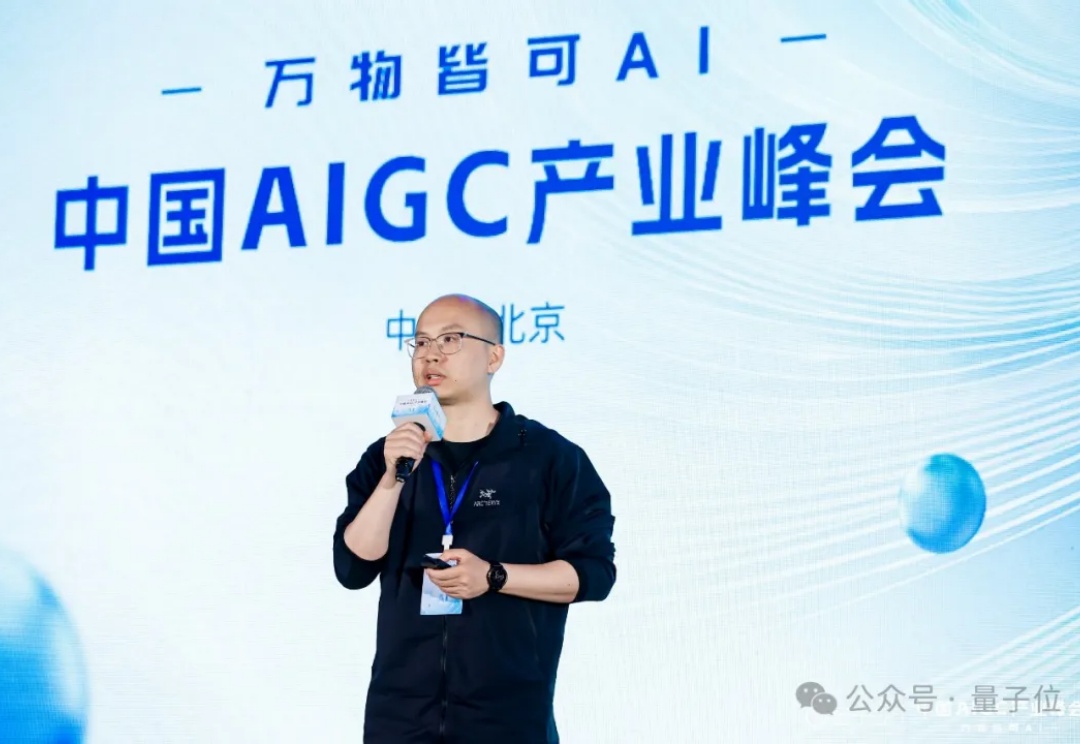
“DeepSeek,评价一下第三届中国AIGC产业峰会”:

2025,当大模型来到应用爆发之年,越来越多的垂直行业当中,开始涌现出AI落地的经典实践案例。

最近,来自大连理工和莫纳什大学的团队提出了物理真实的视频生成框架 VLIPP。通过利用视觉语言模型来将物理规律注入到视频扩散模型的方法来提升视频生成中的物理真实性。
“史上最强视觉生成模型”,现在属于快手。一基双子的可灵AI基础模型——文/图生图的可图、文/图生视频的可灵,都重磅升级到2.0版本。可图2.0,对比MidJourney 7.0,胜负比「(good+same) / (same+bad)」超300%,对比FLUX超过150%;