阿里开源PromptEcho:用冻结多模态大模型为文生图训练提供高质量Reward
阿里开源PromptEcho:用冻结多模态大模型为文生图训练提供高质量Reward用强化学习(RL)优化文生图模型的 prompt following 能力,是一条被广泛验证的路径 —— 让模型根据 prompt 用不同随机种子生成多张图片,通过 reward model 计算 reward,再利用相关 RL 算法优化模型。
搜索
用强化学习(RL)优化文生图模型的 prompt following 能力,是一条被广泛验证的路径 —— 让模型根据 prompt 用不同随机种子生成多张图片,通过 reward model 计算 reward,再利用相关 RL 算法优化模型。
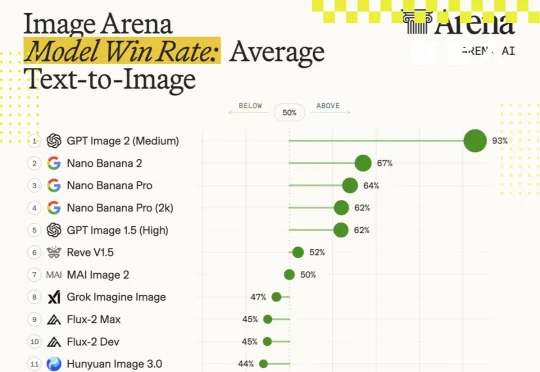
GPT Image 2 凭什么这么强?是扩散模型又迭代了一版?是把 DiT 的参数量从 7B 扩到 20B?是训了更多高质量数据?先给结论:OpenAI 很可能已经不在“纯扩散模型”这条主赛道上了。他们已经把图像生成从“美术课”调到了“语文课”——用一个能读懂指令、能记住上下文、能理解物体关系的 LLM 主导语义规划,至于最后一步的像素生成,可能由扩散组件或其他解码器完成。
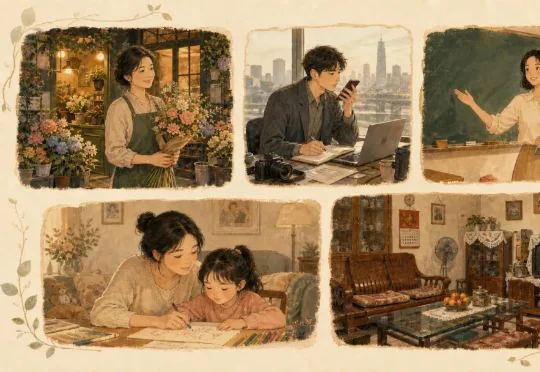
当AI生图真的开始被普通人使用,它会先被用在哪里?所以这次我没有继续测模型或者写Prompt分享。而是去找了10个身边的普通人,问他们怎么开始用AI生图,又为什么会在这些具体的小事上用到它。
商汤刚刚开源了一个全新架构的理解生成统一模型SenseNova-U1,虽然小尺寸版本只有8B,却能复刻不少GPT-Image-2的拿手绝活。太阳系图解,八大行星各自的轨道、属性、图文介绍一应俱全,看着挺像那么回事。
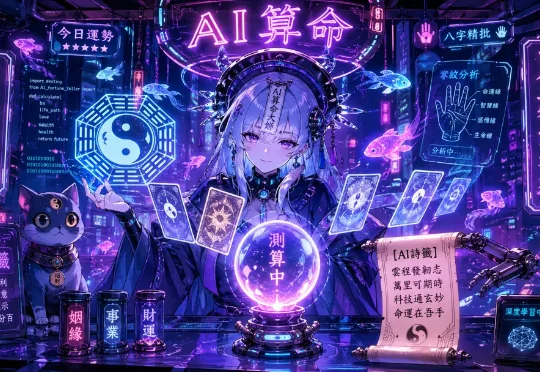
在消耗了无数张 GPU 资源、烧掉了够几座城市用一年的电力之后,OpenAI 最新推出的 AI 生图大模型 GPT-Image-2,再次迎来了它人生中的高光时刻——给人类看手相/面相。
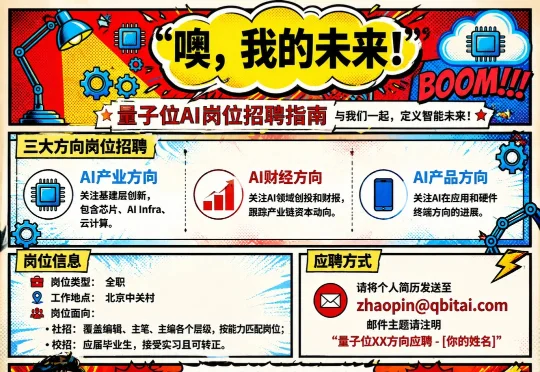
允中 发自 凹非寺 量子位 | 公众号 QbitAI 这两天,大家伙朋友圈是不是被GPT-Image-2刷屏了? 文字渲染精准、高密度的信息图,复杂布局和美学UI一次到位,真实感爆棚。 连社交媒体截图
AI第一次从包工头,变成了建筑设计师。
谷歌真是急了。 前脚刚传来消息,称谷歌联合创始人谢尔盖·布林重启“创始人模式”,亲自督战并组建精英“突击队”,全力提升Gemini在AI编程和自主智能体等关键能力上追赶Anthropic等对手。 后脚
今夜,ChatGPT Images 2.0震撼上线,成为首个「会思考」的图像AI。奥特曼直呼这是从GPT-3到GPT-5的飞跃。它不仅能精准听懂中文指令、渲染复杂UI,甚至能在米粒上刻字。
4 月初,LM Arena 评测平台上出现了三个匿名图像模型,代号分别是 maskingtape-alpha、packingtape-alpha、gaffertape-alpha。几小时后它们消失了。OpenAI 官方还没有正式宣布这个模型,但根据 API 返回的元数据和用户侧的测试记录,它已经有了一个被广泛接受的名字:GPT Image 2。