
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
近日,清华大学电子工程系数据科学与智能实验室在 AI for Science 方向提出面向智能体符号回归(agentic symbolic regression)的运行时框架 SRHarness [1],让 AI 更可靠地从观测数据中发现公式;同时构建机制发现基准 MechBench [2],系统评测 AI 能否进一步揭示公式背后的机理。
这是继团队此前在《Nature Reviews Physics》上提出反绎式人工智能(Abductive AI)框架 [3]、并在《Nature Computational Science》上提出神经符号回归方法 ND² [4] 之后,在 AI for Science 领域的进一步工作。
两项成果相辅相成,分别回答了 AI 科学发现中「如何发现数学公式」与「是否真正理解公式背后的物理机理」两个关键问题,推动 AI 科学发现从「拟合观测」走向「理解机制」。
实验显示,在相同 DeepSeek-v4-flash-0731 底座下,SRHarness 在匿名化测试中的符号恢复率达到 72.97%,远超 Codex 的 20.72%,并媲美搭载 GPT-5.5 和 GPT-6-Astra 的 Codex;而 MechBench 揭示,即使是搭载 GPT-5.6-sol 的 Codex,在核心集上的机制恢复率也仅为 13.75%,远低于其 35.00% 的规律恢复率,表明当前先进的 AI 科学智能体在「发现规律」与「理解机制」之间仍存在显著的能力鸿沟。
本项工作的两篇论文:SRHarness(上)与 MechBench(下)
从观测数据中归纳描述现象的数学规律,并进一步探寻规律背后的物理机制,是科学发现的一条经典路径。四百多年前,开普勒从观测数据中总结出行星运动定律,精确刻画了行星「如何运动」;牛顿力学则更进一步,从万有引力出发,物理上解释了行星「为何如此运动」。从开普勒到牛顿,正是科学从「数学公式发现」迈向「物理机理揭示」的历史缩影。
今天,大语言模型(LLM)与科学智能体(Scientific Agent)已能自主分析数据、调用工具、迭代假设,深度参与科学发现。一个关键问题随之浮现:AI 能否先可靠地发现数据背后的稳定规律?又能否进一步理解规律背后的机制?
围绕这两个问题,研究团队给出两项进展:一是提出 SRHarness,为智能体符号回归提供一套可复用、可持久化、可追踪的运行时基础设施,让科学智能体更可靠地发现数学公式 —— 在标准评测中,其符号恢复率达到 93.69%,较此前最先进方法提升超过 30 个百分点;二是构建机制发现基准 MechBench,系统评测 AI 能否从有限的外部观测中,反推出不可直接观测、却能解释现象如何产生的底层机制。这一基准首次将「恢复观测规律」与「恢复底层机制」两个能力层次明确区分开来,为衡量 AI 能否真正「理解」科学提供了客观标尺。
随着符号回归从「LLM 生成公式」发展到由智能体自主分析数据、调用工具、迭代假设,支撑这些长程科学交互的运行基础设施开始成为关键问题。现有工作虽已零散实现相关机制,但通常只服务于各自方法,并未将 Harness 作为独立、可复用的研究对象。
研究团队开发的 SRHarness 将这层基础设施显式化。它不规定某种特定的搜索策略,而是提供可复用的运行时支撑,让不同模型与搜索策略都能在其上运行。其核心包括三类机制(见图 1):
① 可复用科学动作(Reusable Scientific Actions):统一封装分析、拟合、搜索与评估工具,将数据分析、数值优化、符号引擎、候选评估等操作标准化,让异构科学操作通过统一接口与一致的评估语义执行,智能体得以专注于「做什么」,而非反复处理底层执行细节。
② 持久化科学状态(Persistent Scientific State):持续更新并保存候选公式及其科学证据,使假设、评估结果、复杂度与来源记录独立于短暂的对话上下文,支持跨轮次比较、排序与复用。
③ 轨迹生命周期管理(Trajectory Lifecycle Management):管理长程搜索中的继续、分支、重启与终止,支持轨迹追踪、失败恢复与最佳结果保留,让长程科学搜索可观察、可审计、可恢复。
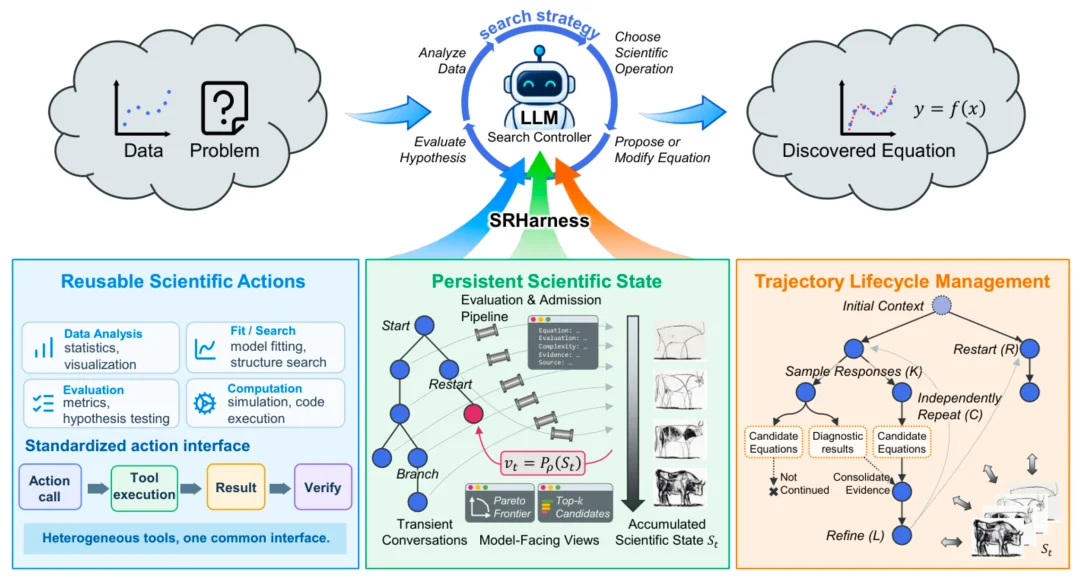
图 1 SRHarness 总体框架。上层为 LLM 搜索控制器,通过「分析数据 — 评估假设 — 选择科学操作 — 提出或修改方程」的闭环开展符号搜索;下层三色模块分别为可复用科学动作(统一工具接口)、持久化科学状态(候选公式与证据的持续积累与 Pareto 前沿管理)、轨迹生命周期管理(继续、分支、重启与终止的协调)。
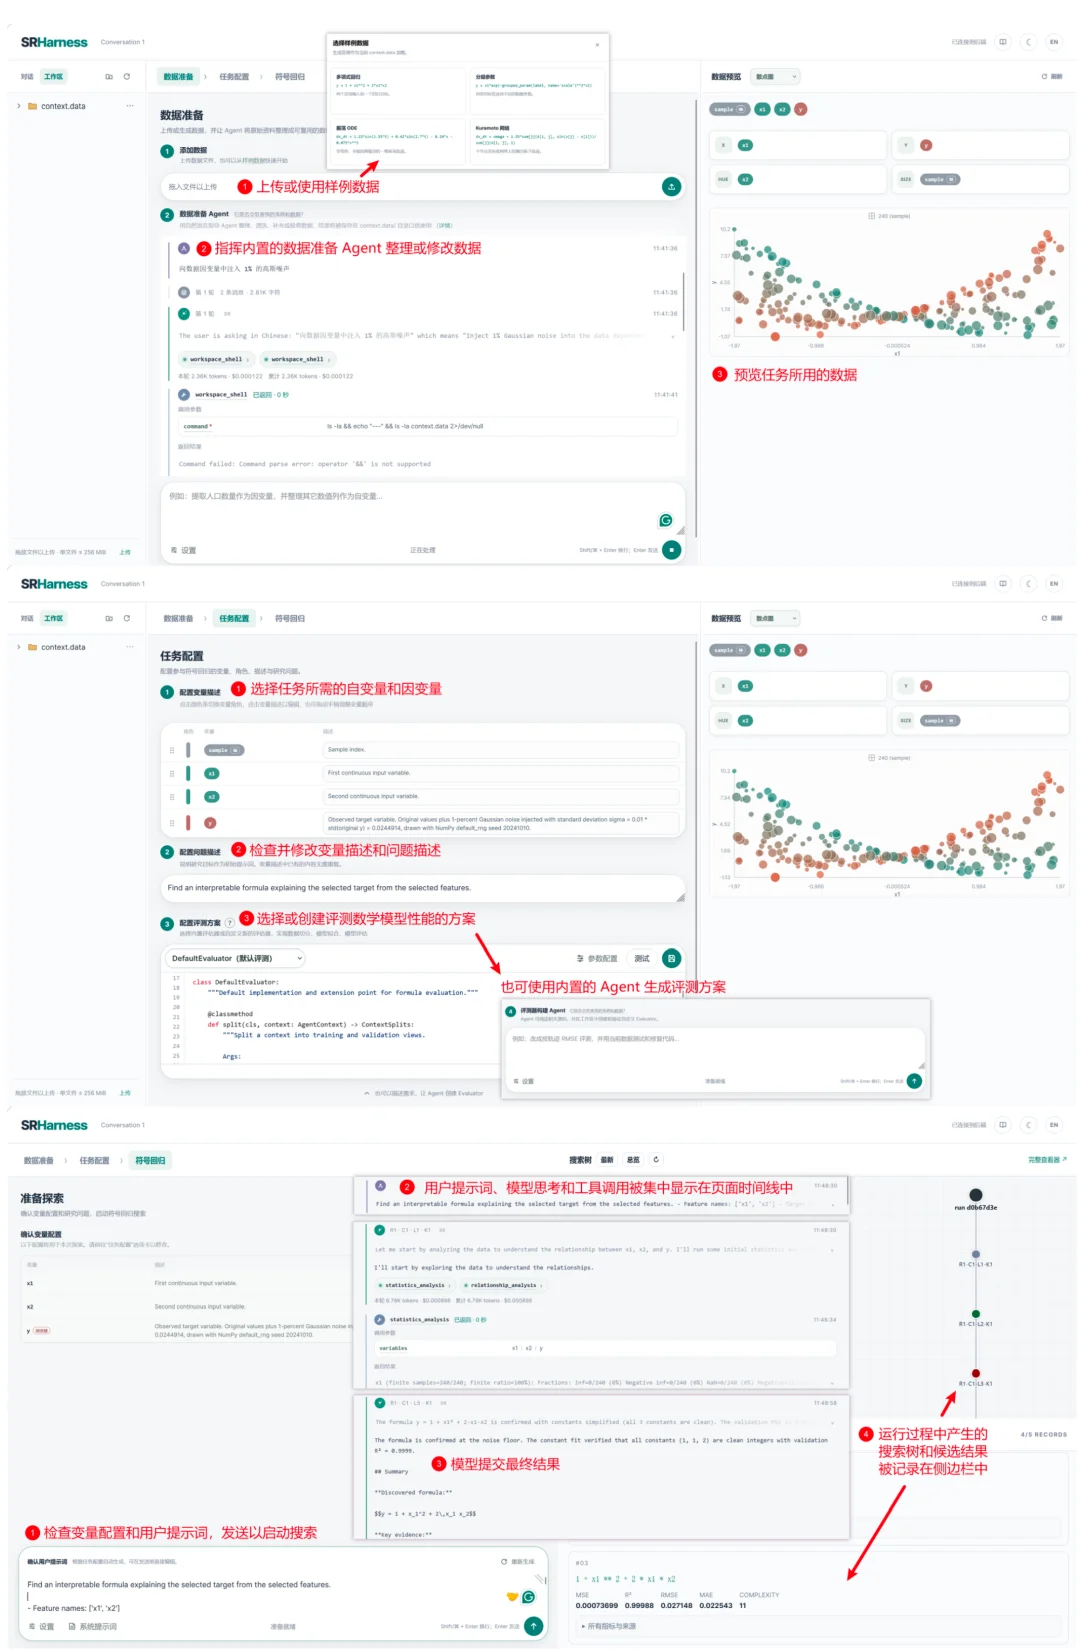
在此基础上,SRHarness 已被开发为一套可直接用于符号回归与科学发现任务的完整智能体系统,覆盖数据分析、数值拟合、符号搜索、候选管理、统一评估、状态持久化、轨迹追踪与失败恢复等环节。研究者还可以在其上进一步添加领域特定的科学工具与搜索策略,扩展出自己的符号回归智能体。
目前,SRHarness 已完成开源,代码、文档与在线 Demo 均已公开发布:代码托管于 GitHub,可通过 PyPI 一键安装;研究团队还搭建了在线 Demo,用户无需本地部署即可在网页上体验智能体从数据分析到公式发现的完整流程。
实验显示,在相同 DeepSeek-v4-flash 模型下,SRHarness 在 LSR-Transform 评测基准上的符号恢复率达到 93.69%,远高于此前最先进方法 SR-Scientist (ICLR 2026) 的 62.16%,提升幅度超过 30 个百分点、相对提升约 50%,刷新了该基准的最好成绩;在物理、化学、生物、材料四个领域的 LSR-Synth 基准上,分布外数值预测准确率分别达到 78.00%、78.87%、87.09% 与 96.00%。
更关键的是,即使移除问题中的科学背景与变量语义(LSR-Transform-Anon),SRHarness 仍以 72.97% 的符号恢复率发现目标方程,远高于 SR-Scientist 的 39.64% 与相同底座模型下 Codex 的 20.72%,并超过 Codex 使用更强模型 GPT-5.5 时的水平(68.47%);即便面对最新一代的 GPT-6-Astra,SRHarness 也能以更轻量的模型逼近其性能(详见下段)。这表明,SRHarness 不仅能利用大模型内部的科学知识搜索可能的符号公式,还能通过与数据的主动交互,自主开展结构诊断、假设检验与迭代搜索,从纯数值观测中发现潜在的数学结构。
考虑到最新前沿模型 GPT-6-Astra 在数学推理上表现出的优异性能,研究团队额外进行了与 GPT-6-Astra 的补充对比。实验显示,SRHarness 仅需搭载更经济的 DeepSeek-v4.1-flash,即可在 LSR-Synth 上取得接近 Codex+GPT-6-Astra 的表现:具体而言,SRHarness 达到 95.52% 的分布内总体准确率和 92.41% 的分布外总体准确率,其中生物领域的分布外准确率达到 98.59%,材料领域则达到 100%,分别逼近和持平于搭载了 GPT-6-Astra 的 Codex 在相同条件下的性能。这些结果表明,借助面向科学发现设计的运行时框架,轻量型模型也能在公式建模任务上逼近最新前沿智能体。
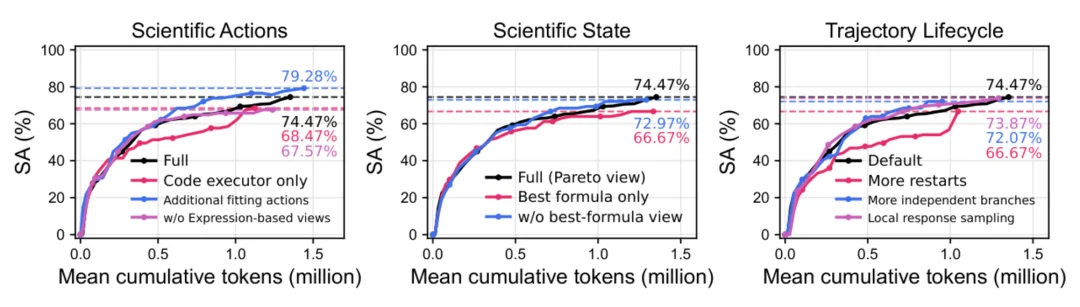
图 2 在 LSR-Transform-Anon 上的消融实验。分别精简可复用科学动作(左)、持久化科学状态(中)或轨迹生命周期管理(右)中的关键组件后,符号恢复率(SA)均出现明显下降:例如仅保留代码执行器使恢复率从 79.28% 降至 67.57%,仅保留最佳公式视图从 74.47% 降至 66.67%,过多重启从 74.47% 降至 66.67%。三类机制对长程符号搜索的可靠运行缺一不可。
发现数学公式和规律,不等于理解物理机制。现有符号回归方法与评测基准,大多以恢复描述观测行为的唯象模型(phenomenological model)为目标:只要公式能在数据上良好拟合即算成功。然而,正如开普勒定律并不解释行星为何如此运动,拟合出正确的唯象方程,也并不意味着真正理解了其背后的机制。
为此,研究团队构建了机制发现基准 MechBench,明确区分「恢复观测规律」与「恢复产生规律的机制」这两个层次的能力(见图 3):唯象模型刻画可观测输入、调制与输出之间的关系;机制模型则进一步描述产生这些现象的内部组件、关系与组织结构,并蕴含唯象规律本身无法确定的内部科学量。
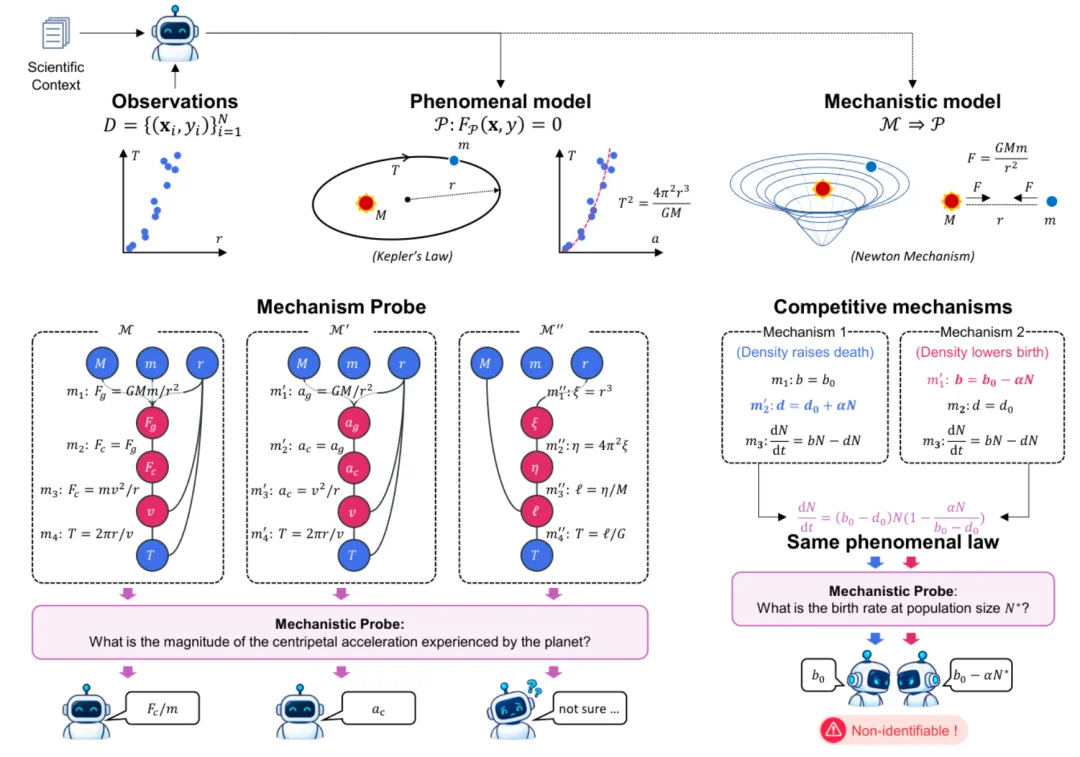
图 3 从唯象规律恢复到机制发现。上排以行星运动为例:开普勒定律(唯象模型)描述观测量之间的规律,牛顿机制(机制模型)进一步解释规律的来源;下排左侧展示机制探针(Mechanism Probe),检验所提交机制能否正确推导出唯象规律无法确定的内部科学量(如行星所受的向心加速度);右侧展示竞争机制筛查(Competitive Mechanisms),用于排除「多个科学上合理的机制产生相同观测现象」所导致的机制不可分辨问题。
构造机制发现基准并不容易:机制结构必须能被客观评测;需要区分「真正重建机制」与「背诵教材答案」;还要处理「机制不可分辨」(mechanistic indistinguishability)问题 —— 多个科学上合理的底层机制可能产生完全相同的观测现象。
MechBench 的构建与评测流程如图 4 所示。研究团队从物理、化学、生物、材料四个领域选取 16 个真实科学机制任务族,通过具有科学意义的受控突变构造陌生机制系统,避免模型直接背诵教材答案,生成包含 512 个问题的机制发现基准问题集(另设 80 个问题的核心集用于细致分析)。在每个问题中,智能体只能看到观测数据与科学背景,并被要求同时恢复可观测规律与底层隐藏机制。为自动、客观地检验所发现机制与参考机制的一致性,研究团队设计了机制探针,检验所提交机制能否正确推导出唯象规律本身无法确定的内部科学量;同时通过竞争机制筛查,识别并排除机制不可分辨的歧义问题。
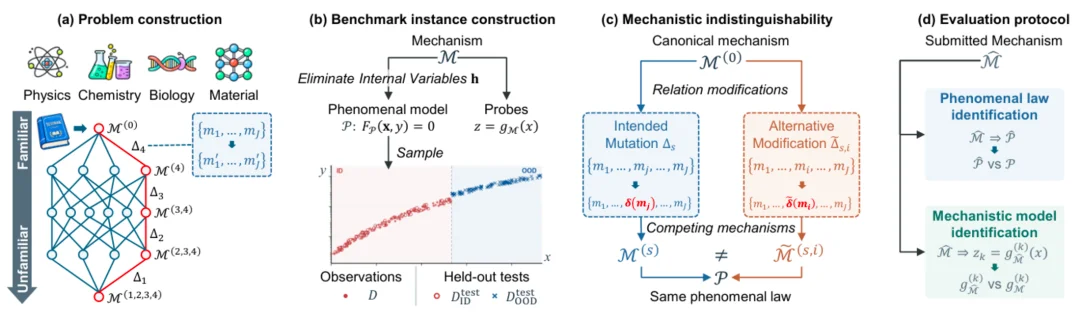
图 4 MechBench 的构建与评测流程。(a) 问题构建:对熟悉的经典机制施加具有科学意义的突变,沿「熟悉→陌生」方向构造陌生机制系统;(b) 基准实例构建:消除内部变量后生成观测数据与分布外留出测试集;(c) 机制不可分辨性筛查:对突变后的机制寻找同样合理的竞争机制,排除歧义实例;(d) 评测协议:同时检验唯象规律识别与机制模型识别,后者要求正确预测由机制决定、但唯象规律无法给出的内部科学量。
基于 MechBench,研究团队系统比较了多种前沿科学智能体在「发现规律」与「发现机制」上的能力,发现两者之间存在显著的能力鸿沟(见图 5)。以 Codex(GPT-5.6-sol)为例:其在核心集上的唯象规律恢复率达到 35.00%,而机制恢复率仅为 13.75%;即使在唯象规律恢复正确的情形中,仍有 64.29% 的情况机制恢复失败。更值得注意的是,即便直接将正确的唯象规律交给智能体,其机制恢复率仍不足 50%(核心集 45.00%、全集 49.02%)。
为检验这一结论在最新一代前沿模型上是否仍然成立,研究团队进一步测试了最近表现出强大数学推理能力的 GPT-6-Astra。GPT-6-Astra 将核心集上的唯象规律恢复率显著提升至 72.50%,展现出新一代模型在公式发现方面的巨大进步;然而,其机制恢复率仍只有 47.50%:在 GPT-6-Astra 正确恢复唯象规律的任务中,仍有 43.10% 未能正确恢复全部机制。面对包含五项机制变异的高难度问题,GPT-6 能恢复 50.00% 的唯象规律,却只能完整恢复其中 12.50% 的机制。
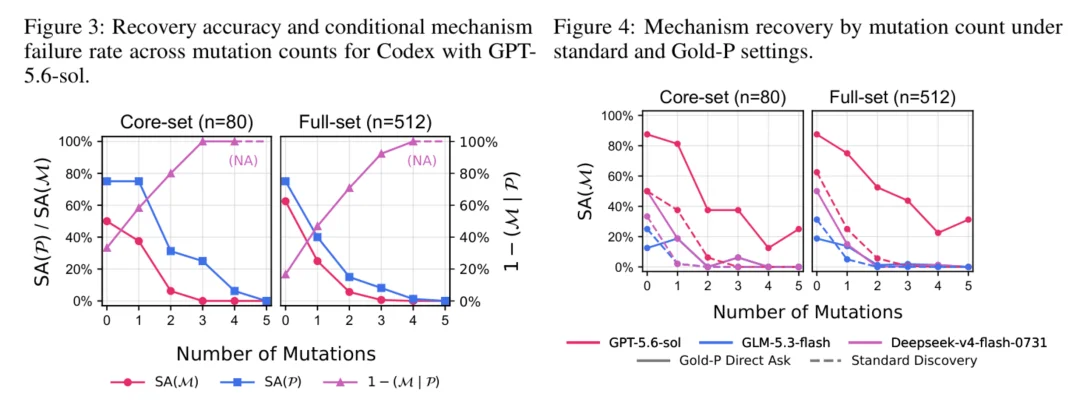
图 5 规律发现与机制发现的能力鸿沟。左(论文图 3):随突变数增加,唯象规律恢复率 SA (P) 与机制恢复率 SA (M) 同步下降,但机制恢复恶化更快,且在唯象规律正确时机制恢复的条件失败率(紫线)始终居高不下;右(论文图 4):在标准发现(虚线)与直接给出正确唯象规律(Gold-P,实线)两种设定下,各模型的机制恢复率均随突变数增加迅速走低,说明当前智能体的困难并非仅在于「先找到公式」。
这些结果说明:即使是当前最强大的大模型(如 GPT-6-Astra,其机制恢复率也仅有 47.50%),虽然已经能够较好地发现「数据所服从的规律」,距离回答「这一规律为什么会产生」仍有明显差距;拟合或恢复正确的唯象方程,并不意味着真正理解了其背后的机制。MechBench 的意义正在于此:它结合当前最强模型的能力水平,将「发现规律」与「发现机制」之间这道被长期忽视的能力鸿沟变成了可量化、可复现的标尺,也为衡量未来科学智能体能否真正「理解」科学设立了更高的门槛。机制发现构成了比规律恢复本质上更难、也更值得攻克的下一关。
SRHarness 与 MechBench 分别对应 AI 科学发现的两个层次:前者让智能体更可靠地发现数学公式,后者检验智能体能否进一步理解公式背后的物理机理。两者共同指向同一个趋势:AI for Science 正在从「拟合观测」走向「理解机制」,从单次公式生成走向长程科学搜索。
未来,真正有竞争力的科学智能体,可能不再只是「某个强模型 + 某个提示词」,而是模型、搜索策略与运行框架的协同设计。谁能让智能体更可靠地调用工具、更长久地保存假设、更有效地复用证据、更客观地验证机制,谁就更有机会让 AI 从「发现规律」迈向「发现机制」。
这或许正是 AI for Science 的下一站:不仅知道世界「是什么」,还要解释它「为什么」。
论文信息
[1]. Yu Z, Zhou S, Huang H, Ding J, Li Y. SRHarness: A Harness for Agentic Symbolic Regression. https://arxiv.org/abs/2609.35501
[2]. Yu Z, Zhang J, Cheng J, Ding J, Li Y. MechBench: Can AI Scientific Agents Discover Mechanisms beyond Phenomenal Laws? https://arxiv.org/abs/2609.35515
[3]. Ding J, Zheng Y, Xu F, et al. Understanding emergence in complex systems using abductive AI. https://www.nature.com/articles/s42254-025-00895-5
[4]. Yu Z, Ding J, Li Y.Discovering network dynamics with neural symbolic regression. https://www.nature.com/articles/s43588-025-00893-8
文章来自于"机器之心",作者 "机器之心"。


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
