字节找到了DeepSeek时强时弱的原因
字节找到了DeepSeek时强时弱的原因DeepSeek的神鬼二象性被字节Seed团队逮到了。
来自主题: AI资讯
9913 点击 2026-10-09 16:23

 搜索
DeepSeek的神鬼二象性被字节Seed团队逮到了。
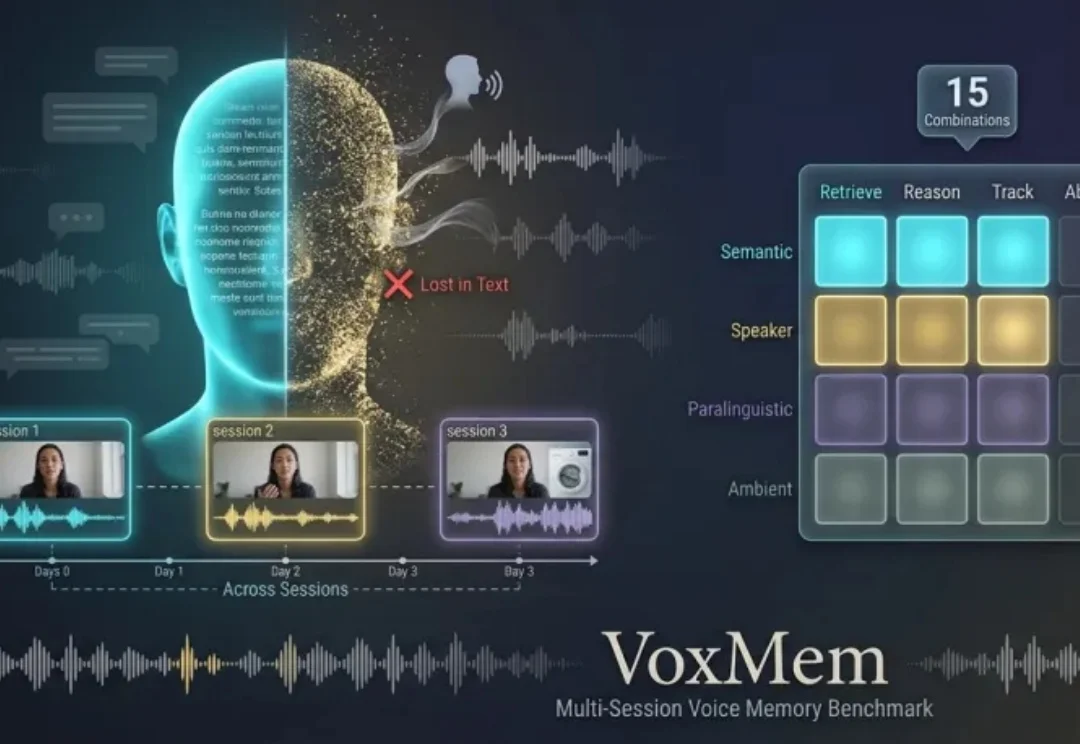
在语音助手、多用户共享的家庭助理等长期对话场景中,模型需要跨越多次会话记住用户的信息,但现有评测常遭遇两大难题:
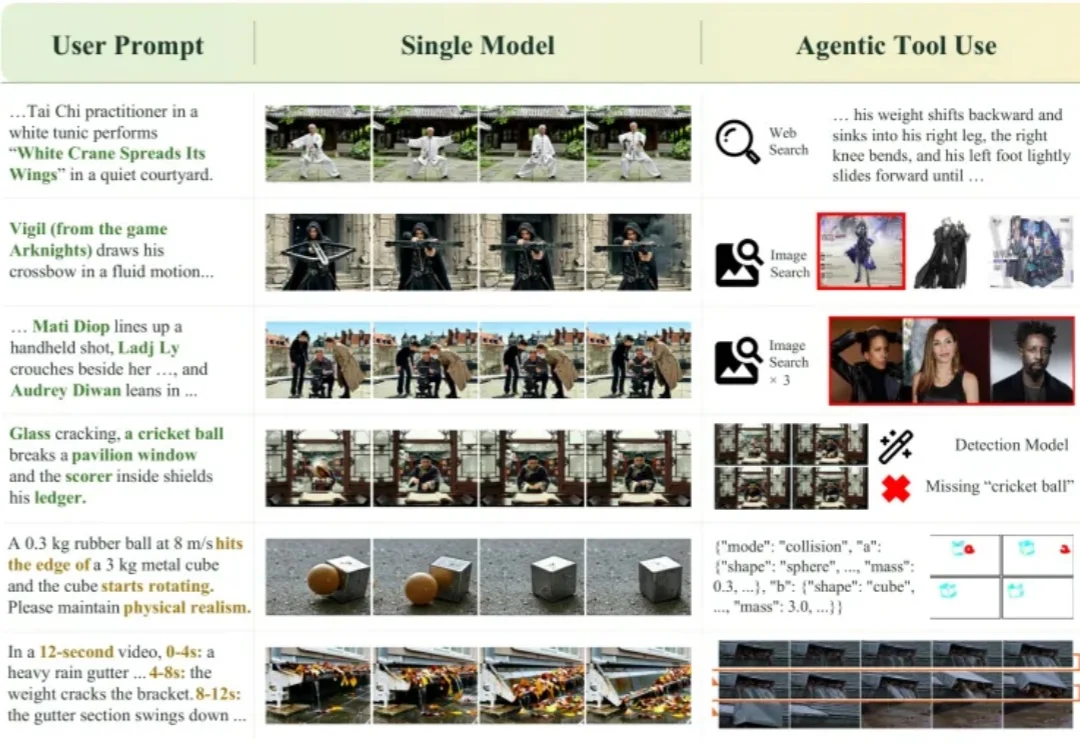
从检索动作知识、寻找角色参考,到模拟运动和衔接镜头,一个经过强化学习的智能体,能给视频生成带来多大提升?
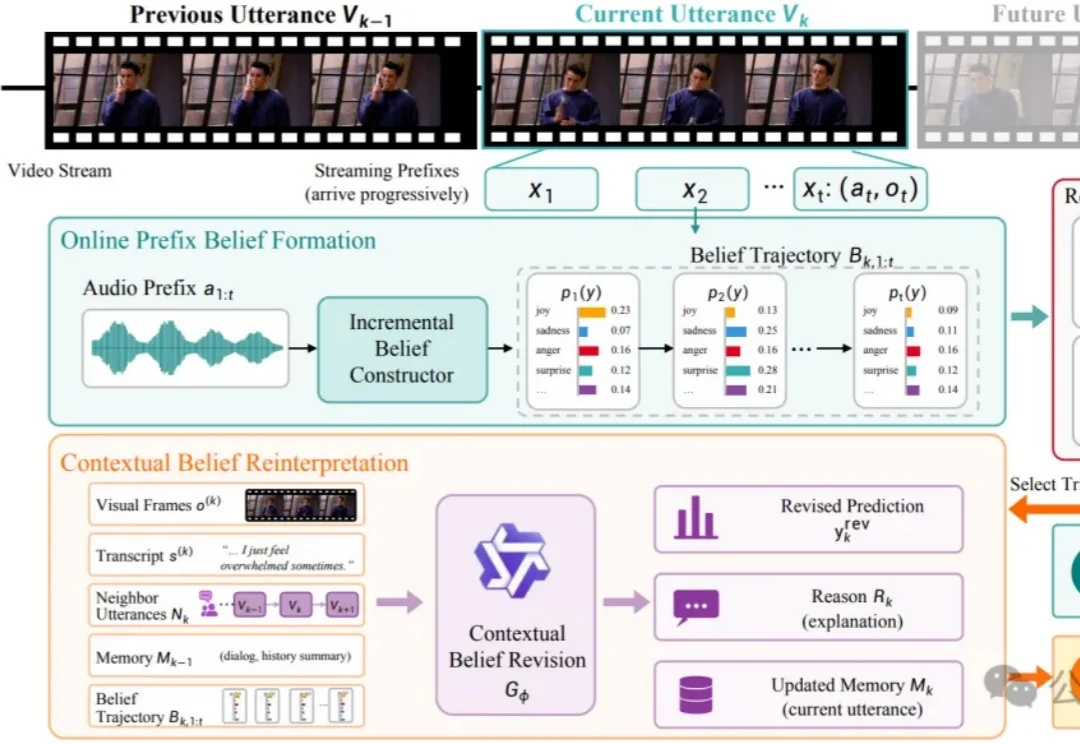
在与用户的实时对话中,AI能否及时感知情绪?模型给出的“高置信度”结论,又是否经得起推敲?
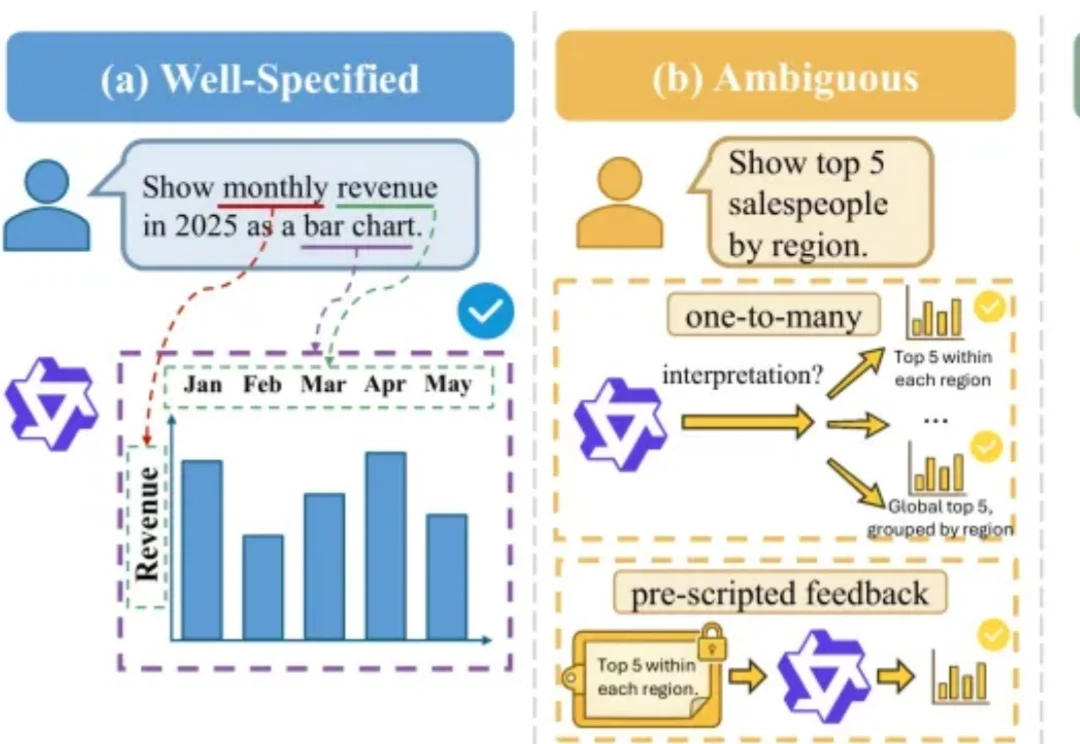
数据要让人看懂,通常得先从数据库里查出来,再画成图。文本到可视化(Text-to-Vis)做的就是这件事:用户说出想看什么,系统去库里查询,再用图表把需要的数据展示出来。
智能体时代,安全研究不仅要关心模型说了什么,现在还必须进一步回答:它做了什么、为什么这么做,以及这次的执行轨迹是否越过了当前场景明确规定的安全边界。
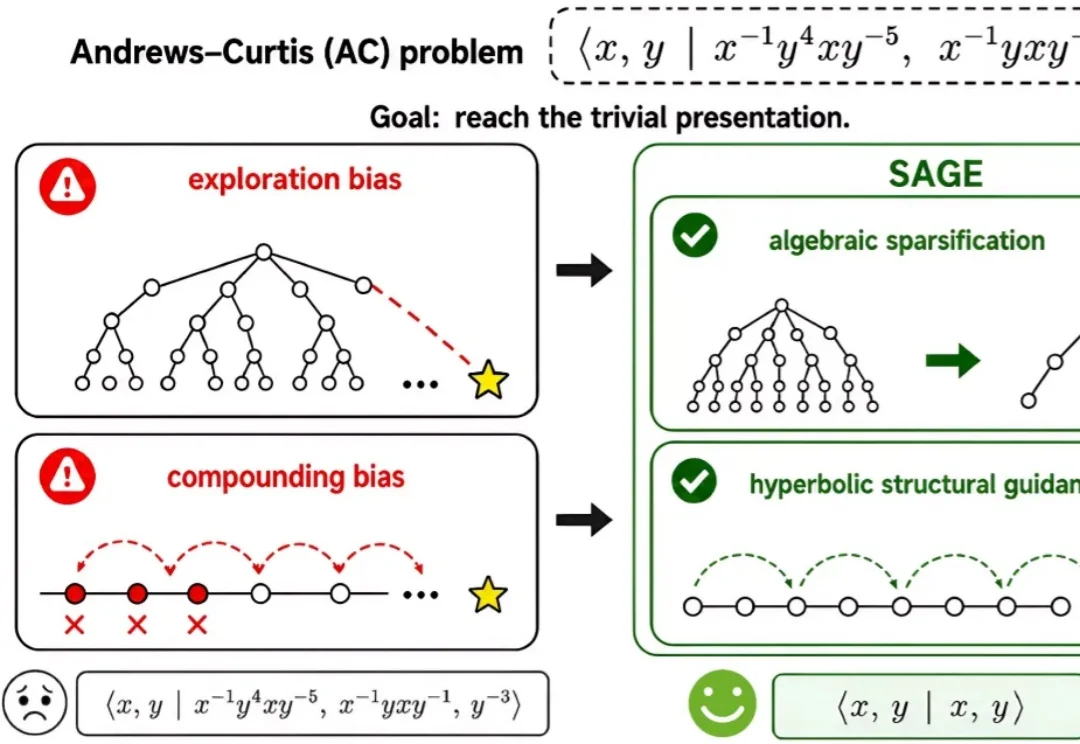
大模型解短题常能给出流畅答案,推理链一长,却可能每一步都看似合理、终点仍然失效。来自弗吉尼亚理工大学、威斯康星大学麦迪逊分校和达特茅斯学院的研究团队在 NeurIPS2026 论文中提出 SAGE:用符号闭包分析(SCA)解释长推理中的探索偏差与累积偏差,再把这一诊断变成训练时的结构引导。
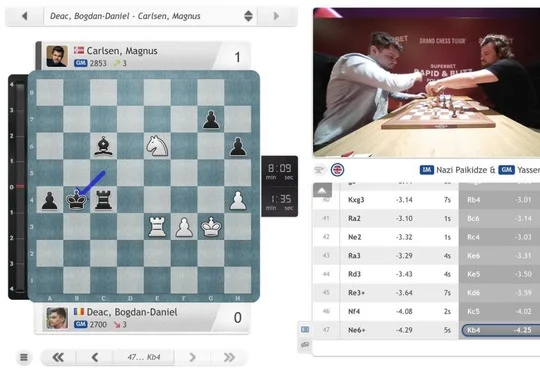
普林斯顿大学陈丹琦团队在arXiv发布约4B参数模型QUEEN,通过门控交叉注意力连接Leela与SmolLM3-3B,并引入四阶段课程和迭代搜索蒸馏,使其棋力接近特级大师且能用自然语言解释着法。
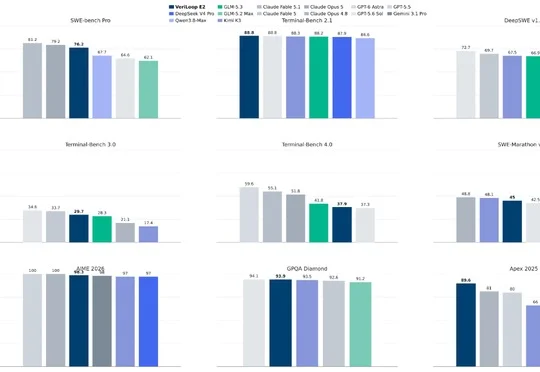
清华团队开源以Qwen 3.8-27B为基础模型的VeriLoop E2,通过VGR外部证据门控实现可验证状态提交,并取得黎曼猜想临界线零点比例下界67.350003708785593%的严格有限维证书,但上游形式化桥接尚未完成。
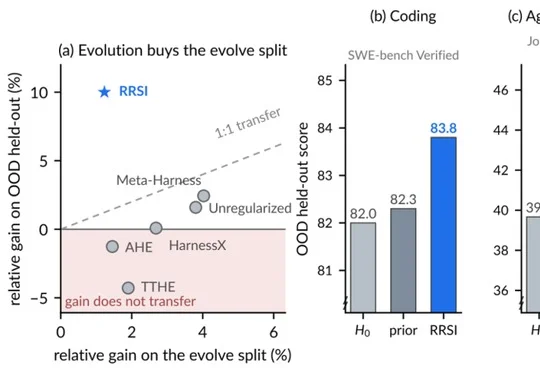
Google等提出RRSI,通过正则化Agent Harness自我改进中的Proposal与Selection,减少过拟合与复杂度累积,并提升未见基准上的迁移表现、降低Token成本。