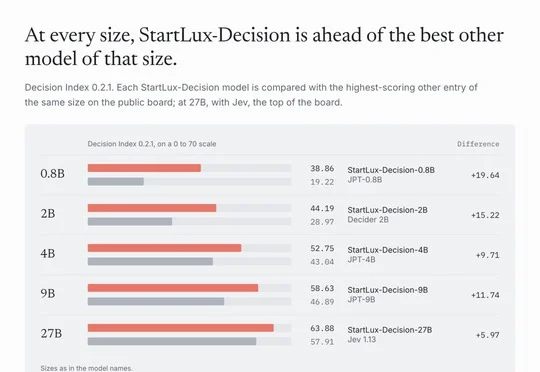
Jev被请下王座,StartLux中国开源决策模型冲上第一
Jev被请下王座,StartLux中国开源决策模型冲上第一StartLux发布完全开源的StartLux-Decision,其27B版本在Decision Index 0.2.1的38项基准中有31项超过Jev 1.13,并以63.88分升至公开榜首。
来自主题: AI资讯
8767 点击 2026-10-06 14:39

 搜索
StartLux发布完全开源的StartLux-Decision,其27B版本在Decision Index 0.2.1的38项基准中有31项超过Jev 1.13,并以63.88分升至公开榜首。
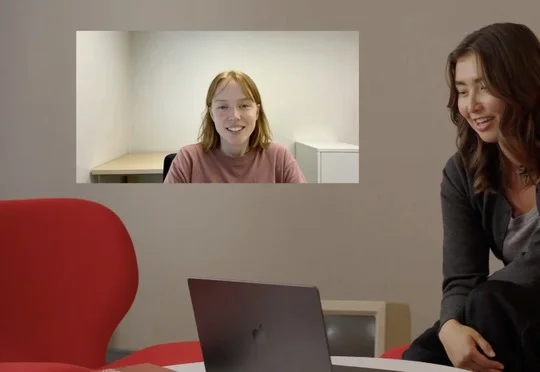
Tavus发布全双工视频到视频交互模型Griffin,可实时生成720p数字人并理解停顿、表情与动作,在一分钟测试中让54名参与者近48%误以为在与人交谈,但该结果未独立验证且模型尚未公开。
Anthropic 为 Claude Code 默认开放可深度改装的 Mods,并推出拥有超 2000 个插件和连接器的 Claude Marketplace,但高权限与暂缺收益分成也带来安全和持续运营疑问。
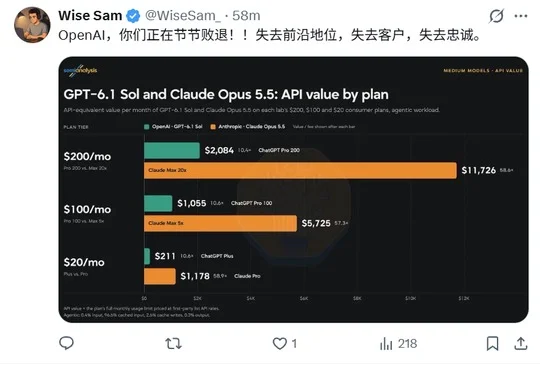
OpenAI将订阅用户使用GPT-6 Astra和GPT-6.1 Sol的速度提升约50%,但SemiAnalysis实测称Anthropic订阅的API等价价值约为OpenAI的5倍,OpenAI 200美元套餐额度也已减半。
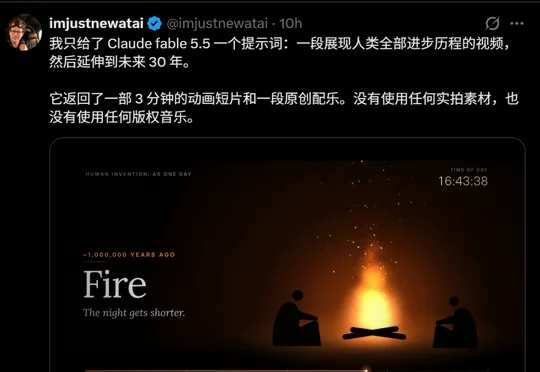
今天,外网被这个视频刷屏了。有人用Fable 5.5一键生成了一部「人类数万年进化史」,把整个人类历史压缩进了3分钟。整个过程,都是用纯代码写出,零视频素材,零版权音乐,没有使用任何视频生成模型。
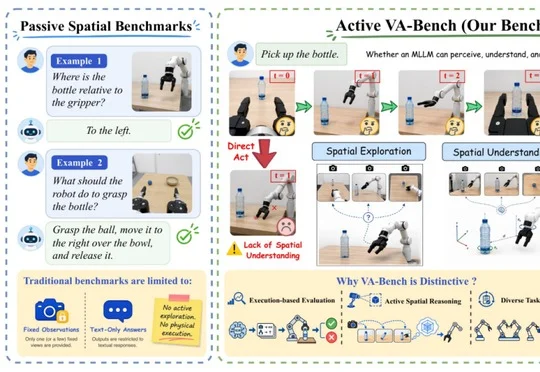
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
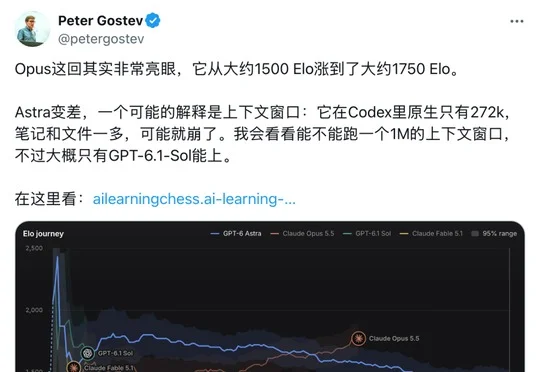
大模型竞技场Arena让Claude Opus 5.5与GPT-6 Astra各自练棋200局,前者估算评分从约1500升至1760,后者从第29盘的1810降至1400,显示AI仅靠记录与复盘提升能力的表现并不一致。
来自上海创智学院、复旦大学、伦敦国王学院与牛津大学等机构的研究团队推出SocioVerse2,将大模型社会模拟扩展为可干预、可迭代、可回溯的开源社会科学研究框架。
AMD以约82亿美元股票收购李飞飞创办的World Labs后,作者认为交易更看重人才与模型理解而非成熟产品,并批评世界模型标签滥用及AI圈压制对低质产品的批评。
OpenAI在开发者日后因GPT-6.1 Sol实际体验不及预期、使用额度收紧等问题遭遇用户信任危机,Tibo承诺未来将进行连续28天发布或重置,并将简化产品、提高效率作为核心方向,以兑现此前过度宣传的承诺。