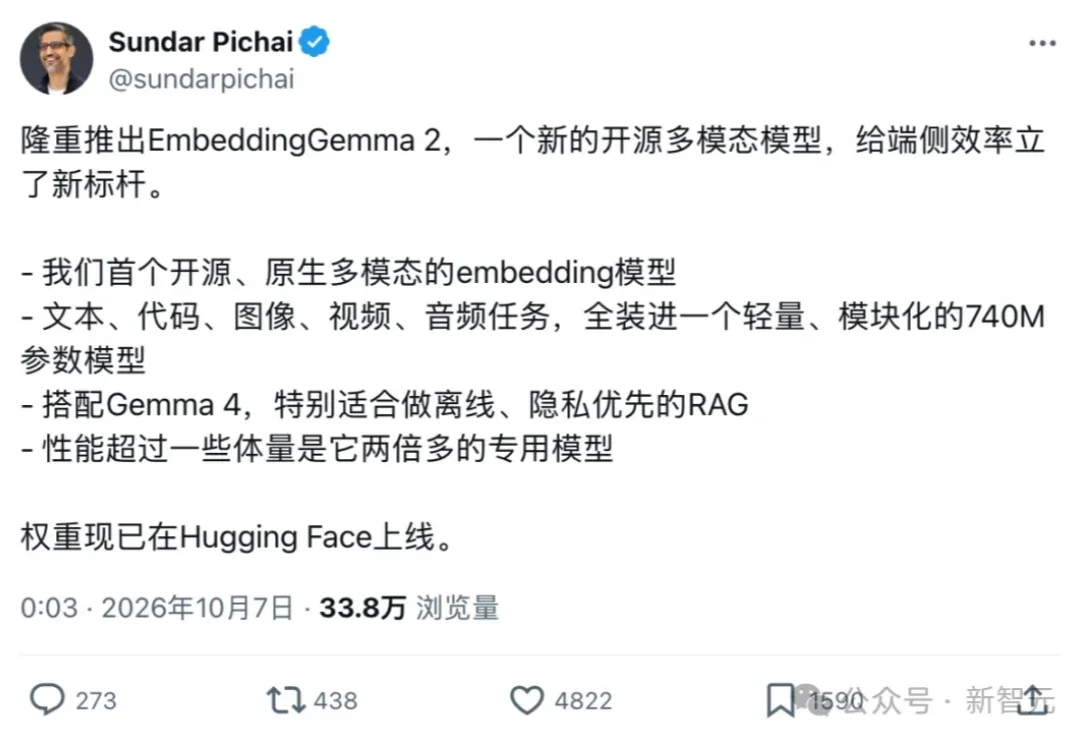
谷歌把AI搜索塞进手机!不到600MB,照片、视频、录音断网照样搜
谷歌把AI搜索塞进手机!不到600MB,照片、视频、录音断网照样搜10月6日,谷歌开源EmbeddingGemma 2,把一个能搜图、看视频、听声音的搜索引擎,塞进了一个内存不到600MB的小模型!
来自主题: AI资讯
8366 点击 2026-10-08 12:14

 搜索
10月6日,谷歌开源EmbeddingGemma 2,把一个能搜图、看视频、听声音的搜索引擎,塞进了一个内存不到600MB的小模型!
AI 初创公司 Ema 完成 7700 万美元 B 轮融资,估值较 2024 年增长超 4 倍,该公司通过协调多个 AI 智能体组成的"AI 员工"系统,逐步接管企业内部的 HR、IT 和财务等业务流程,过去两年收入增长 50 倍,客户包括 NTT DATA、日立、ADP、普华永道、谷歌、毕马威等大型企业。
又一个新里程碑! 就在今天,谷歌DeepMind官宣Gemma开源「全家桶」的最新战绩—— 累计下载,首破十亿大关。 2024年2月首次上线,从0到10亿,用了整整两年半的时间。 如今,全
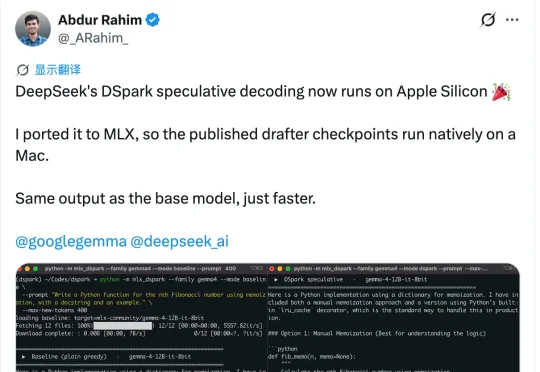
DSpark刚开源一周,就被搬进了苹果电脑。移植版本叫mlx-dspark,跑的是Gemma-4 12B和Qwen3-4B这两个模型。装上之后,这两个模型在Mac上的生成速度分别提了1.6倍和1.4倍。
2026 年 6 月,大模型行业正在经历一场前所未有的「开源海啸」:英伟达放出了 550B 参数的混合架构模型,谷歌送出多模态的 Gemma 新版本,智谱用最宽松的协议全量开源了自家旗舰模型。
最近,我们都在关注旗舰级大模型的进步,其实本地运行的 AI 模型也迎来了重要的分水岭。
Google DeepMind在6月份对外分享了DiffusionGemma的技术报告,明确指向了一条与现有主流完全不同的演进道路。当大家都在绞尽脑汁让大模型逐词吐字的速度变快时,谷歌干脆把生成顺序改了。
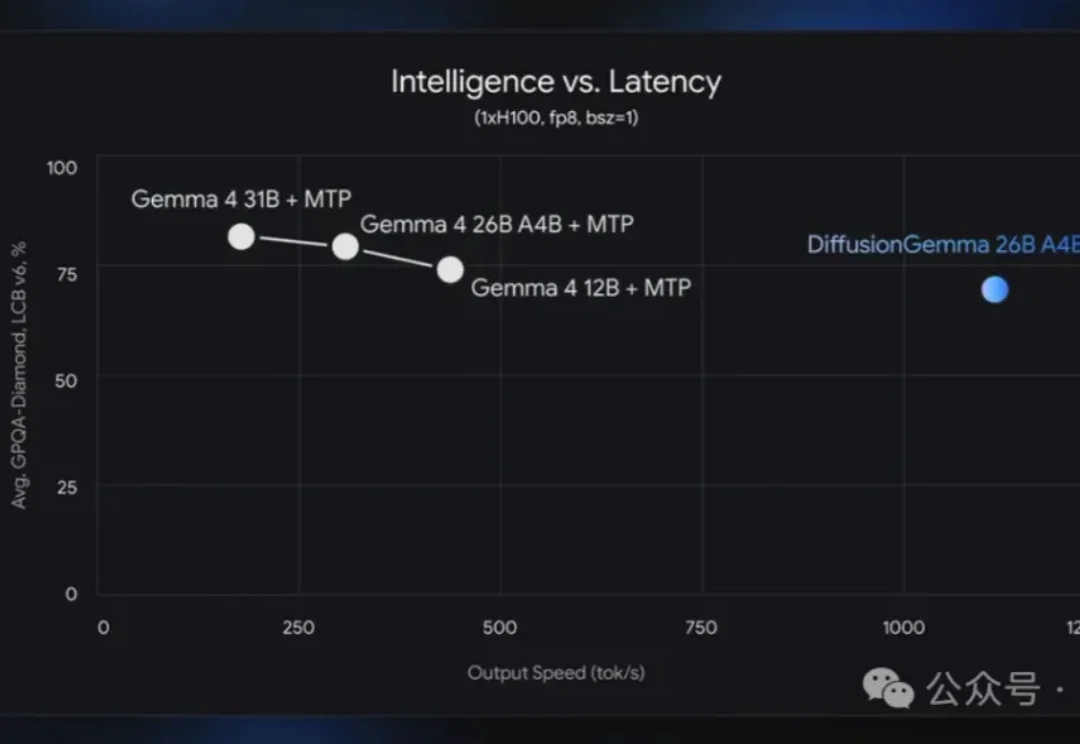
就在刚刚,谷歌闷头干了件大事:把生成图片的扩散模型,拿来写文字了,而且一出手就是4倍加速。 新模型名为DiffusionGemma,它直接抛弃了传统自回归那套“逐Token生成”的打字机模式,而是像“印刷机”一样工作——
今天一早,谷歌又发新模型了!
过去一年,开源模型的发布节奏已经快到让人麻木。每次发布,伴随的永远是一组跑分、一张能力雷达图,以及几个“超越某某”的结论。