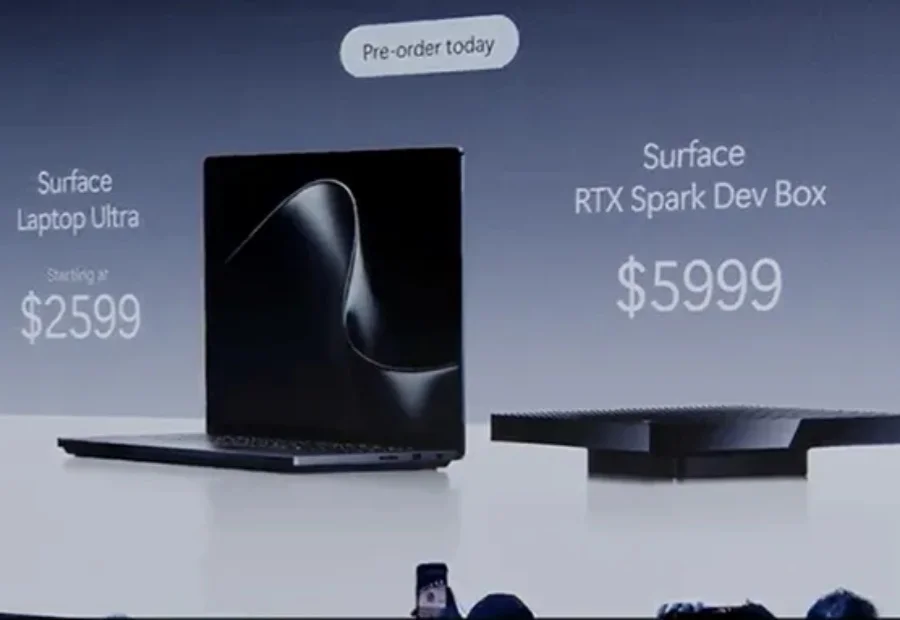
首款RTX Spark电脑,开卖!可跑1200亿参数大模型
首款RTX Spark电脑,开卖!可跑1200亿参数大模型最高20核CPU、6144核GPU、128GB统一内存、1PFLOPS本地AI算力。
来自主题: AI资讯
7220 点击 2026-10-08 12:14

 搜索
最高20核CPU、6144核GPU、128GB统一内存、1PFLOPS本地AI算力。
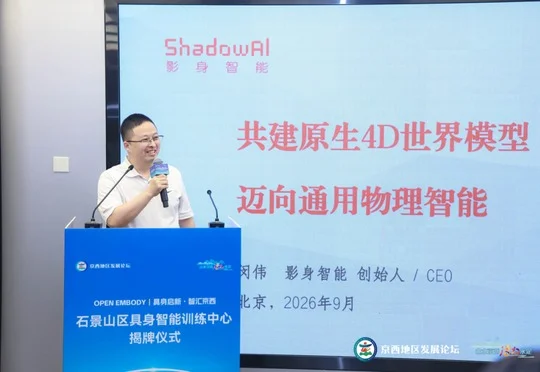
AMD以约82亿美元收购World Labs之际,影身智能凭借比World Labs早两年押注原生4D世界模型路线引起关注,其利用4至6台消费级摄像头和单块消费级GPU实时生成4D数据的技术已在福建晋江制鞋工厂落地,斩获2亿元机器人订单。
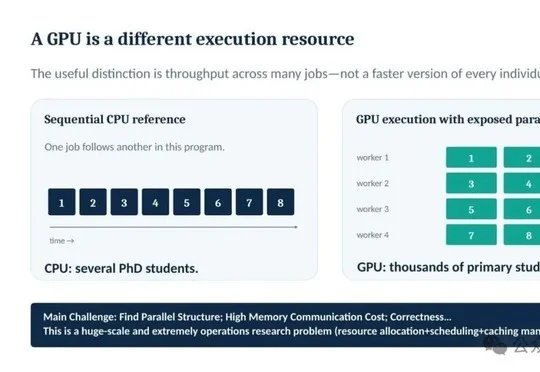
港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。
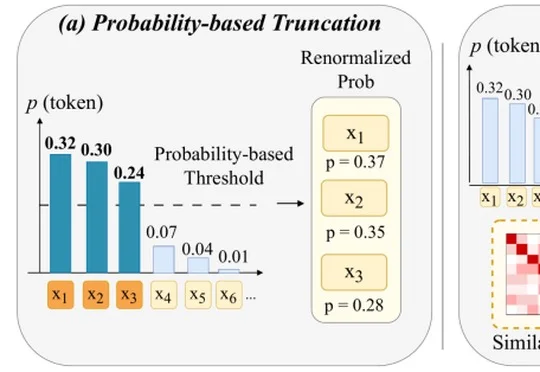
中国人民大学代文林、孟澄研究员团队提出的ME-Decoding方法被EMNLP 2026接收,该方法在解码时同时利用token概率与embedding相似度,从集合层面筛选低冗余候选token,在GSM8K和GPQA上取得所比较方法中最高的平均准确率,端到端GPU延迟仅增加约3%。
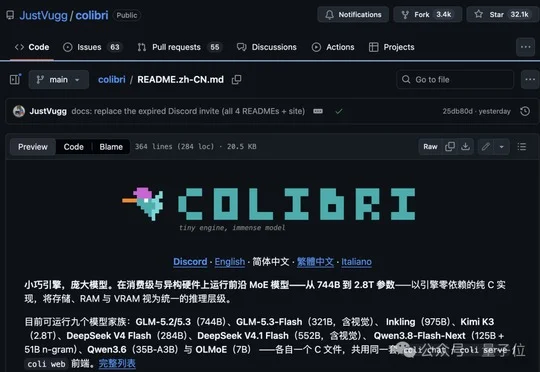
GitHub火热开源项目Colibrì以纯C实现分层推理框架,通过AI内存多层化将SSD、RAM和VRAM组成动态调度系统,无需GPU即可让普通笔记本运行744B参数GLM-5.2等超大MoE模型,已揽获32k Star并支持9个模型家族。
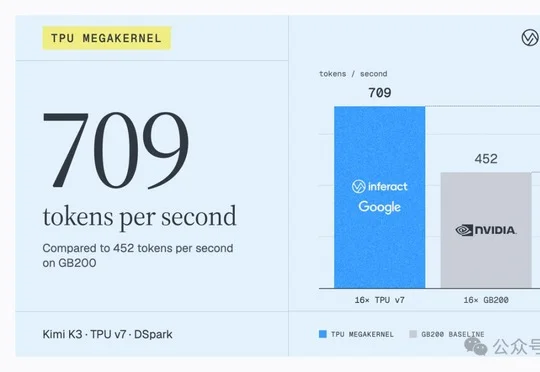
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
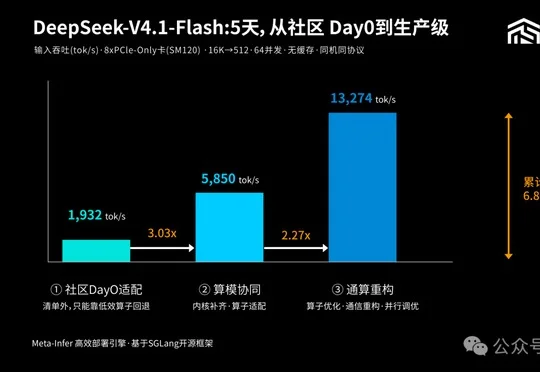
是石科技自研Meta-Infer高效推理引擎通过内核补齐、算子通信重构、并行调优与缓存复用等纯软件手段,在不改动模型前提下将DeepSeek-V4.1-Flash在PCIe显卡上的推理吞吐提升近7倍,该方法论同样适用于DeepSeek-V4-Flash、GLM5.3及国产GPU。
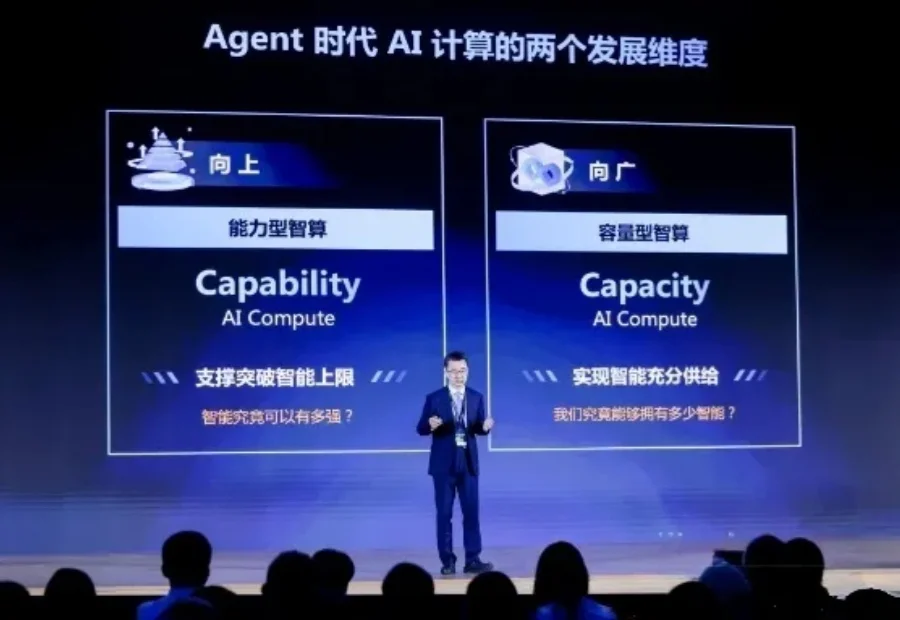
AI产业的两道坎,浪潮信息怎么翻?
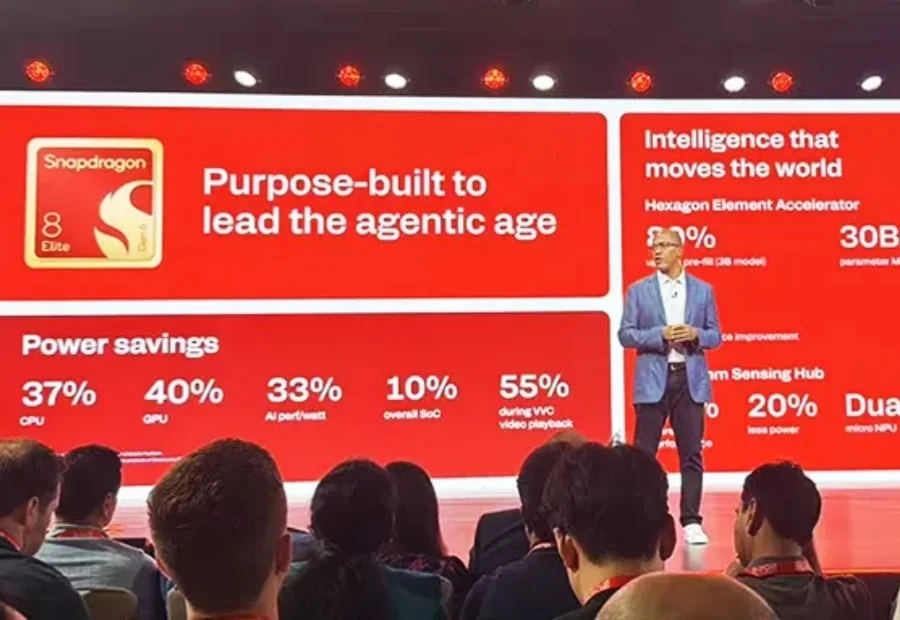
骁龙首次双旗舰齐发,最高8核CPU、GPU内置AI核、NPU内存扩容,安卓旗舰大战正式开打。
AI基础设施公司Cornelis完成2.05亿美元融资并发布Active Compute Fabric网络技术,以开放架构与Nvidia竞争,解决GPU等待数据造成的算力浪费问题。