用不着Ctrl+F了!全新AI论文工具,帮你在原文献里海里捞针
用不着Ctrl+F了!全新AI论文工具,帮你在原文献里海里捞针GitHub新上线的AI论文生成工具Open Academic Paper Gen以九阶段多智能体工作流完成选题、文献检索、初稿写作与核验,并可在获取全文后定位相关段落,检查引用是否支撑正文论点及标注PDF页码。
来自主题: AI资讯
9153 点击 2026-10-10 12:38

 搜索
GitHub新上线的AI论文生成工具Open Academic Paper Gen以九阶段多智能体工作流完成选题、文献检索、初稿写作与核验,并可在获取全文后定位相关段落,检查引用是否支撑正文论点及标注PDF页码。
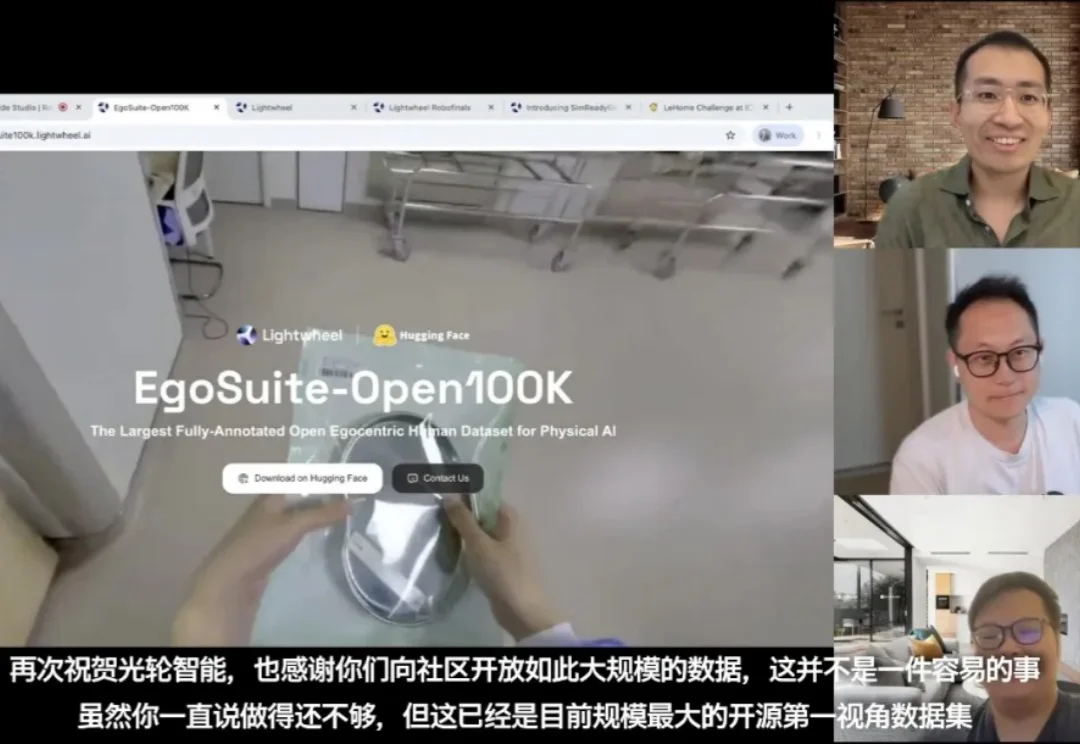
近日,机器人圈知名播客节目 RoboPapers 更新了一期专访,对象是光轮智能创始人兼 CEO 谢晨博士。这期节目的采访人是 RoboPapers 播客联合主持人 Michael Cho 和新加坡国立大学(NUS)助理教授 Jiafei Duan。后者是 MolmoAct 系列机器人模型的作者,研究方向正是机器人基础模型与可扩展数据采集。
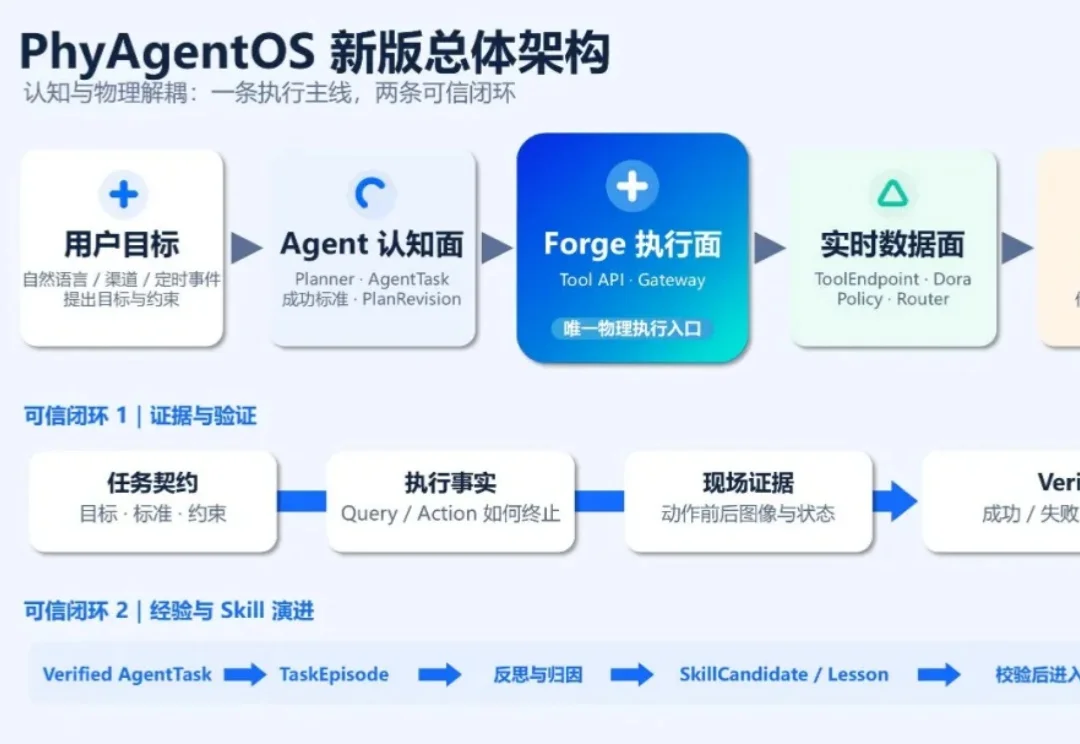
模型竞争的下一站,是让智能体在真实世界里可执行、可验证、可进化。

今年,由倪赞林担任第一作者,王慎执、乐洋共同参与的《The Flexibility Trap》获得 ICML 2026 Outstanding Paper Award。ICML 2026 投稿量达到创纪录的 24,000+ 篇,仅评出 2 篇 Outstanding Paper,该论文成为ICML历史上首篇完全由国内单位学者完成的获奖成果,为更好地理解和设计扩散语言模型做出了重要贡献。
刚读了一篇 AI4AI 论文《AI4AI at Scale》,来自 XYZ Agentic Team。还是第一次听到这个 Lab。他们用 AI4AI 的方式做出了两个很强的搜索 agent,也公开了方法。借这篇 paper 讲讲 AI4AI 到底怎么工作,下面尽量少堆术语。
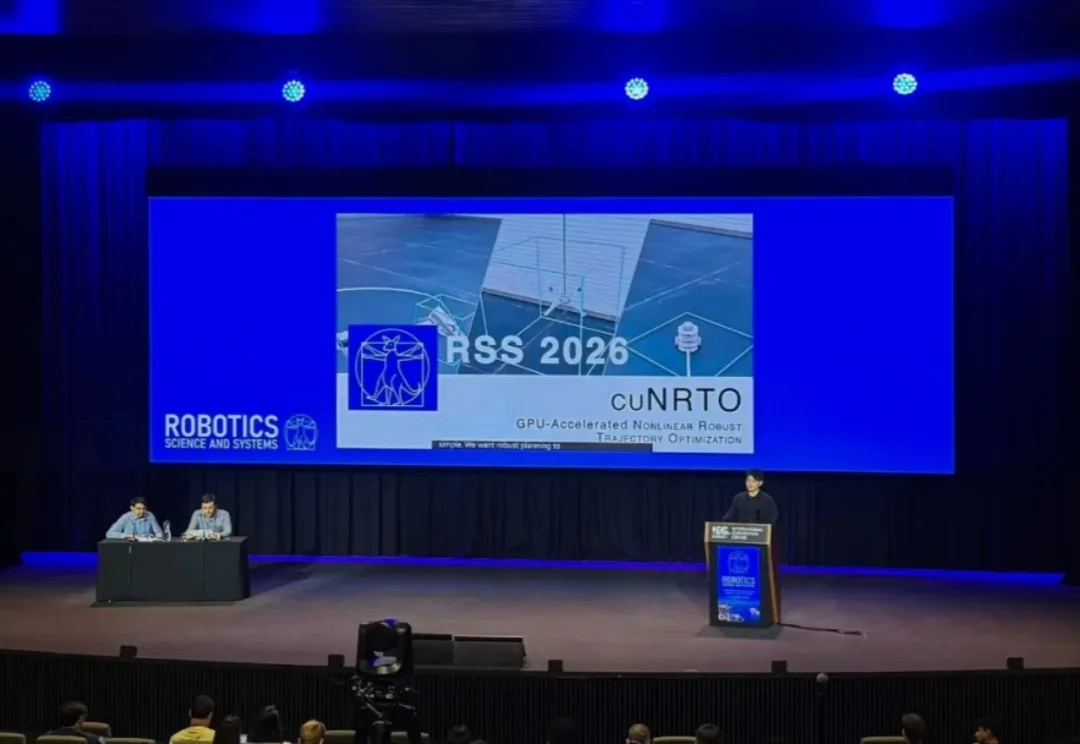
在近日的具身智能顶会 RSS(Robotics: Science and Systems)2026 上,最高奖项 Outstanding Paper Award 提名名单里,出现了一个不太 “机器人” 的名字 —— 影眸科技,一家头部 3D 生成大模型公司。
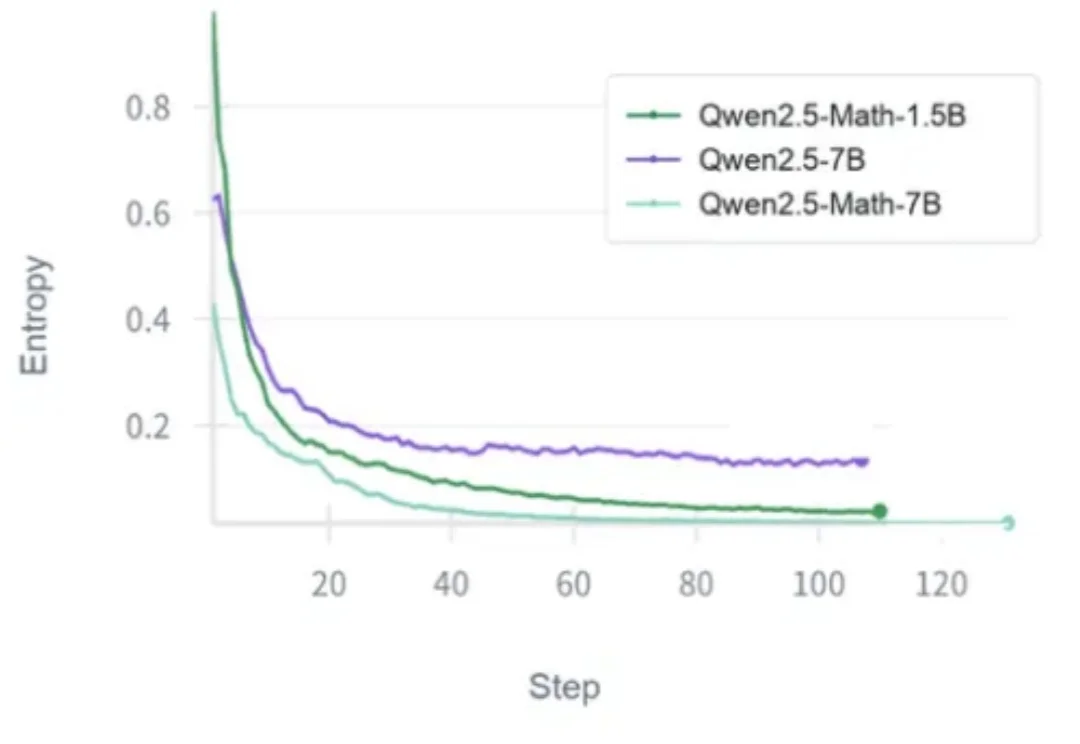
基于可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards,RLVR)正在成为大模型后训练的关键技术。数学题能判对错,代码能跑测试,可验证奖励让大模型可以通过强化学习持续提升推理能力。
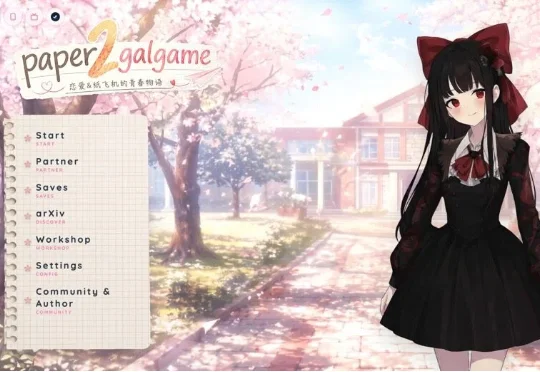
大家好,我是 Paper2GalGame 的开发者塔米基。 半年前,我做了一个”把论文变成 Galgame”的软件。 当时很多人觉得这是一个玩笑。 但今天,它已经有了十万用户,并准备登陆 Steam。
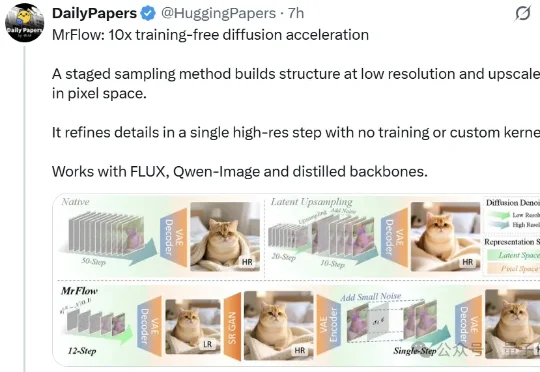
MrFlow(Multi-Resolution Flow Matching)就用这样的三阶段,在Qwen-Image等模型上把端到端生成时间从49.32s压到4.77s,实际加速10.35x。文章发布当日即登上Hugging Face Daily Papers;发布三天内,GitHub已收获200+stars;目前也已登上Hugging Face Trending Papers。
我们今天以 PDF 写论文的方式,已经持续了三百多年。然而论文其实是把一段混乱反复、充满试错的真实研究,讲成一个干净利落、足以服人的完美故事。