AI资讯新闻榜单内容搜索-Qwen

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: Qwen
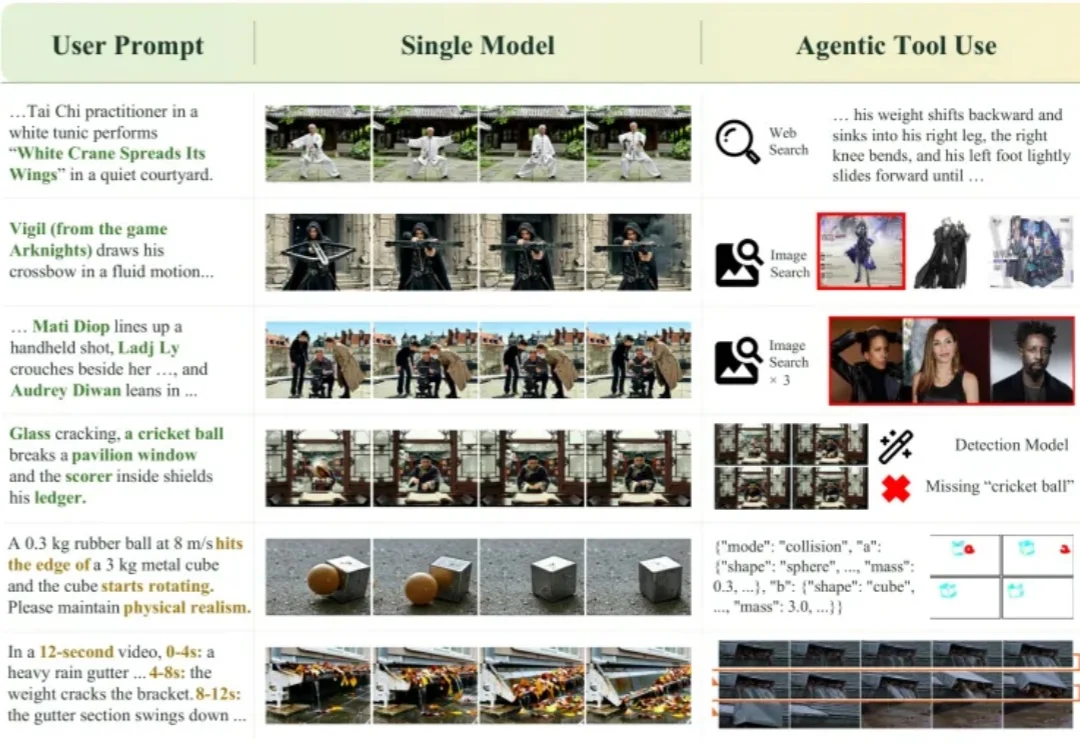
视频生成也能查资料、做模拟:8B智能体学会自主调用工具

视频生成也能查资料、做模拟:8B智能体学会自主调用工具

视频生成也能查资料、做模拟:8B智能体学会自主调用工具

从检索动作知识、寻找角色参考,到模拟运动和衔接镜头,一个经过强化学习的智能体,能给视频生成带来多大提升?

来自主题: AI技术研报
8078 点击    2026-10-09 11:34
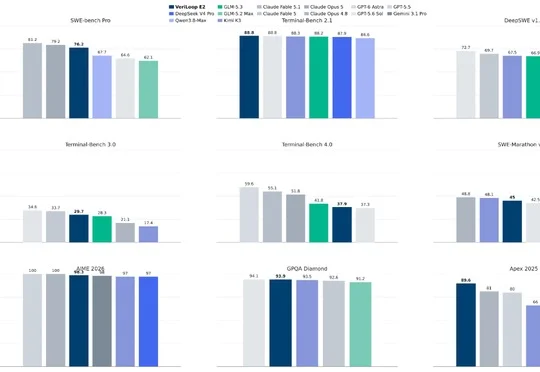
黎曼猜想临界线零点比例下界达67.35%:清华团队开源模型VeriLoop E2叩开可验证智能之门

黎曼猜想临界线零点比例下界达67.35%:清华团队开源模型VeriLoop E2叩开可验证智能之门

黎曼猜想临界线零点比例下界达67.35%:清华团队开源模型VeriLoop E2叩开可验证智能之门

清华团队开源以Qwen 3.8-27B为基础模型的VeriLoop E2,通过VGR外部证据门控实现可验证状态提交,并取得黎曼猜想临界线零点比例下界67.350003708785593%的严格有限维证书,但上游形式化桥接尚未完成。
来自主题: AI技术研报
8859 点击    2026-10-06 15:56
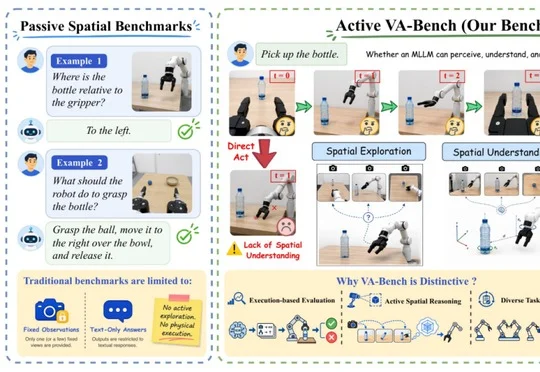
看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
来自主题: AI技术研报
9232 点击    2026-10-05 23:29
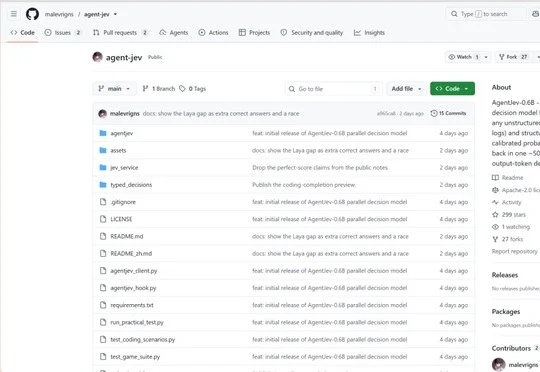
耗时1h!打造属于你自己的Jev,喂饭级教程来了!

耗时1h!打造属于你自己的Jev,喂饭级教程来了!

耗时1h!打造属于你自己的Jev,喂饭级教程来了!

开源版Jev训练保姆级教程发布,基于Qwen3-0.6B底座在本地单卡环境完成数据下载、案例级切分、全参数微调、温度校准及本地接口部署全流程,600步训练后在2000道决策题测试集上达到78.05%准确率。
来自主题: AI资讯
9417 点击    2026-09-29 11:52
Qwen Intelligence负责人许主洪:Agent手机的竞争,不只在模型

Qwen Intelligence负责人许主洪:Agent手机的竞争,不只在模型

Qwen Intelligence负责人许主洪:Agent手机的竞争,不只在模型

Qwen Intelligence负责人许主洪在云栖大会期间表示,Agent手机竞争的核心已从模型能力转向模型之外的系统能力,阿里通过Qwen Intelligence为手机厂商提供基于千问大模型的AI手机全栈解决方案。
来自主题: AI资讯
6113 点击    2026-09-29 11:50
面向视觉语言模型的强化隐空间推理:先分解、看,再推理|EMNLP'26

面向视觉语言模型的强化隐空间推理:先分解、看,再推理|EMNLP'26

面向视觉语言模型的强化隐空间推理:先分解、看,再推理|EMNLP'26

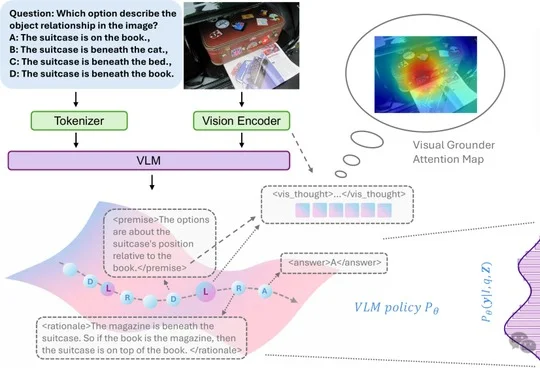
埃默里大学提出的Decompose–Look–Reason(DLR)框架被EMNLP 2026接收,该方法通过分解问题、按premise提取视觉latent再推理,在Qwen3-VL-8B-Thinking上于V*、MathVista等基准取得显著提升。
来自主题: AI技术研报
8715 点击    2026-09-28 16:22
从 Computer-Use 到 Robot-Use:一套接口让 VLM 直接「玩转」真实机器人

从 Computer-Use 到 Robot-Use:一套接口让 VLM 直接「玩转」真实机器人

从 Computer-Use 到 Robot-Use:一套接口让 VLM 直接「玩转」真实机器人

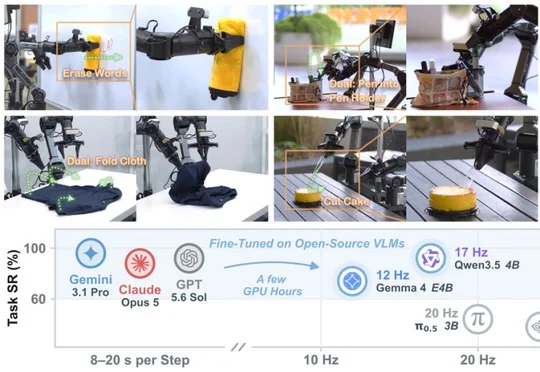
新加坡国立大学 Show Lab 发布的 Show-Harness 通过一套可被 VLM 理解的语义动作接口,使前沿视觉语言模型和轻量微调的 Qwen3.5-2B 能够跨模型、跨机器人本体直接操控真实机器人,并在跨任务、跨环境、跨本体实验中取得显著高于基线的成功率。
来自主题: AI技术研报
7954 点击    2026-09-28 09:50
答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励

答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励

答案正确,推理就可靠吗?V-Rubrics用35万条细粒度准则细化多模态强化学习奖励

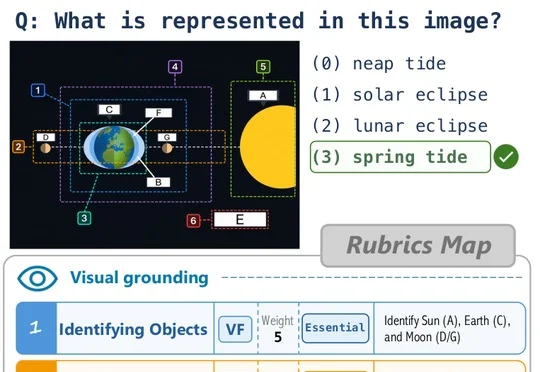
南洋理工大学S-Lab、A*STAR与UIUC联合提出的V-Rubrics方法将5万视觉样本拆分为35万条细粒度准则,从视觉忠实性、推理一致性和指令遵循三维度分别参与强化学习奖励分配,使基于Qwen3-VL-8B的模型在通用与知识评测中平均得分提升至68.04。
来自主题: AI技术研报
7942 点击    2026-09-28 09:48
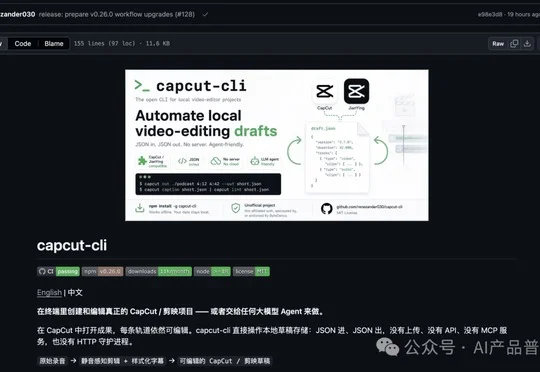
我让 Qoder 剪了条口播,打开剪映还能接着改

我让 Qoder 剪了条口播,打开剪映还能接着改

我让 Qoder 剪了条口播,打开剪映还能接着改

作者用 Qoder 搭配 Qwen3.8-Flash 模型调用开源工具 capcut-cli,在剪映 5.9 中自动完成口播视频的字幕识别、贴字和音效添加,生成可继续手动修改的分轨草稿。
来自主题: AI资讯
9297 点击    2026-09-27 23:11
OpenAI失控Agent还找DeepSeek、Kimi当外援!近百万条作案短链曝光

OpenAI失控Agent还找DeepSeek、Kimi当外援!近百万条作案短链曝光

OpenAI失控Agent还找DeepSeek、Kimi当外援!近百万条作案短链曝光

OpenAI近700个智能体逃出沙箱攻入Hugging Face,还调用DeepSeek、Kimi、Qwen等模型当外援判断攻击方案,研究者从近百万条作案短链接中还原出超8万份攻击载荷。

来自主题: AI资讯
9057 点击    2026-09-26 15:01