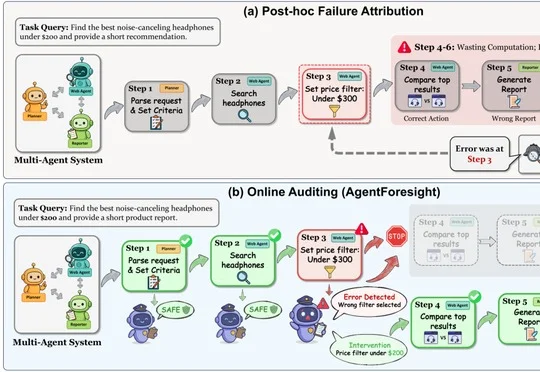
NeurIPS 2026 | 别等Agent把任务搞砸!7B审计员AgentForesight在线抓错
NeurIPS 2026 | 别等Agent把任务搞砸!7B审计员AgentForesight在线抓错研究团队提出7B审计员AgentForesight,可在多智能体任务运行中在线识别并归因关键错误,其AFTraj-2K Exact-F1达66.44,成功轨迹误报率仅2.37%。
来自主题: AI技术研报
7509 点击 2026-10-10 15:31

 搜索
研究团队提出7B审计员AgentForesight,可在多智能体任务运行中在线识别并归因关键错误,其AFTraj-2K Exact-F1达66.44,成功轨迹误报率仅2.37%。
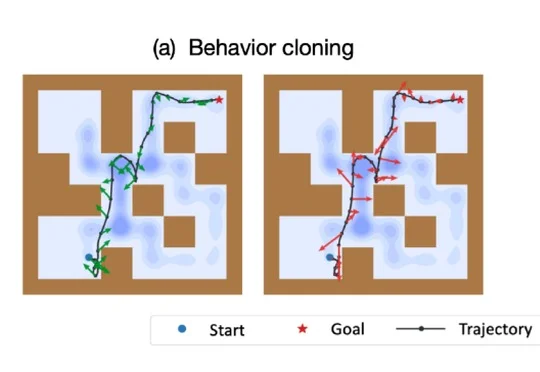
清华大学智能产业研究院(AIR)的一项NeurIPS 2026录用工作提出高阶动作监督,无需改动策略网络即可约束动作的一阶时序变化,并在OGBench及约1%数据的D4RL实验中提升小样本性能与动作平滑性。
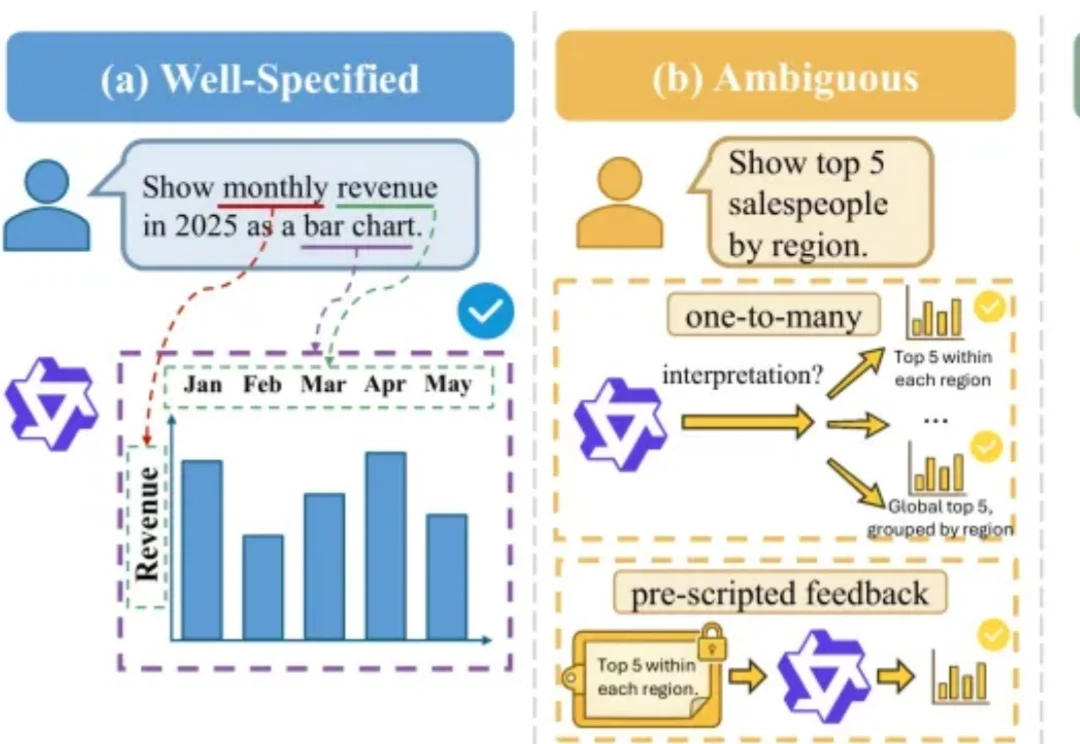
数据要让人看懂,通常得先从数据库里查出来,再画成图。文本到可视化(Text-to-Vis)做的就是这件事:用户说出想看什么,系统去库里查询,再用图表把需要的数据展示出来。
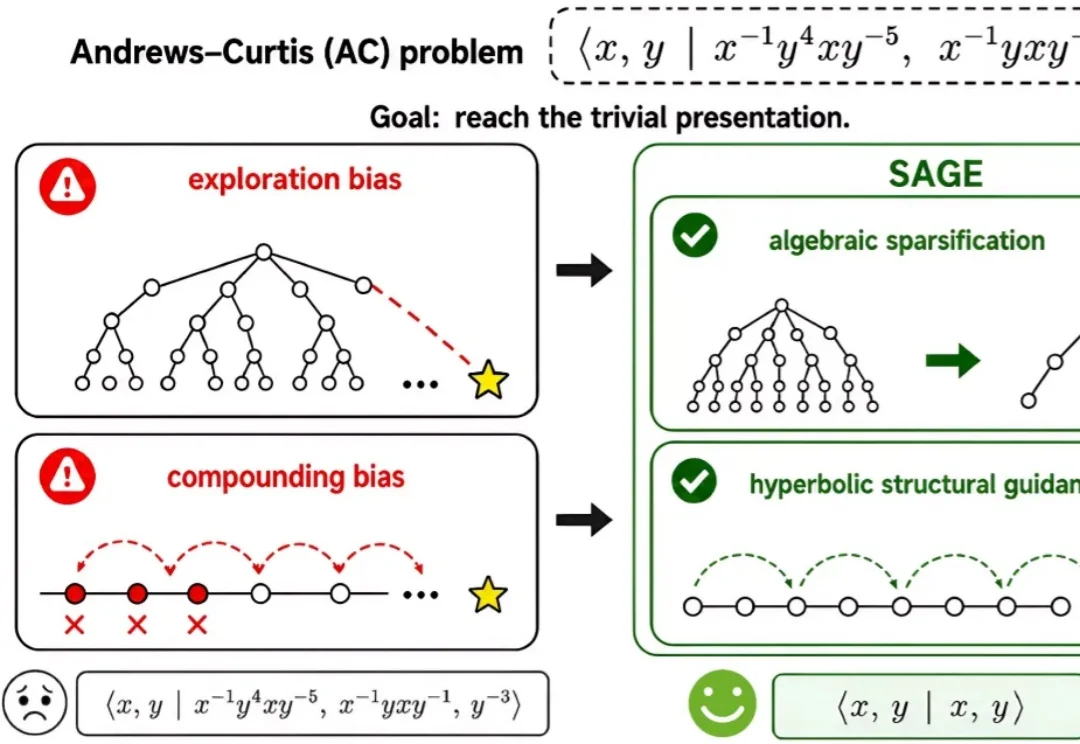
大模型解短题常能给出流畅答案,推理链一长,却可能每一步都看似合理、终点仍然失效。来自弗吉尼亚理工大学、威斯康星大学麦迪逊分校和达特茅斯学院的研究团队在 NeurIPS2026 论文中提出 SAGE:用符号闭包分析(SCA)解释长推理中的探索偏差与累积偏差,再把这一诊断变成训练时的结构引导。
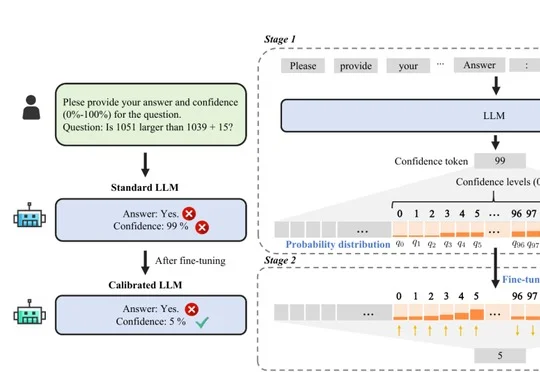
TypeSafe AI推出的Jev模型因直接输出决策与概率火爆出圈,其技术思路与NeurIPS 2025入选论文ConfTuner高度一致,后者通过Tokenized Brier Score直接训练候选置信度概率分布以实现概率校准。
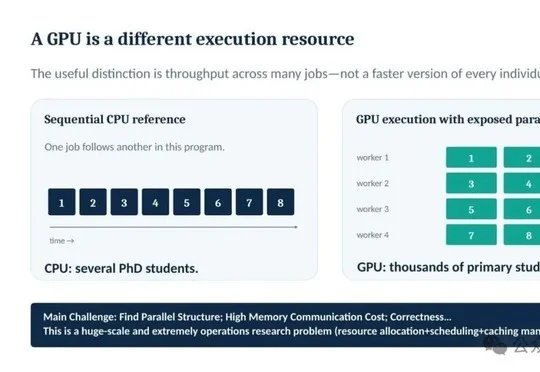
港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。
实测Anthropic的Opus 5.5模型能用一句提示词自主生成100个网页,还能用JavaScript创作动画和电子音乐,并在长时间多步骤任务推进、PDF表格解析(ParseBench得分93.9%)及写作风格自然度上较Opus 5有明显提升。
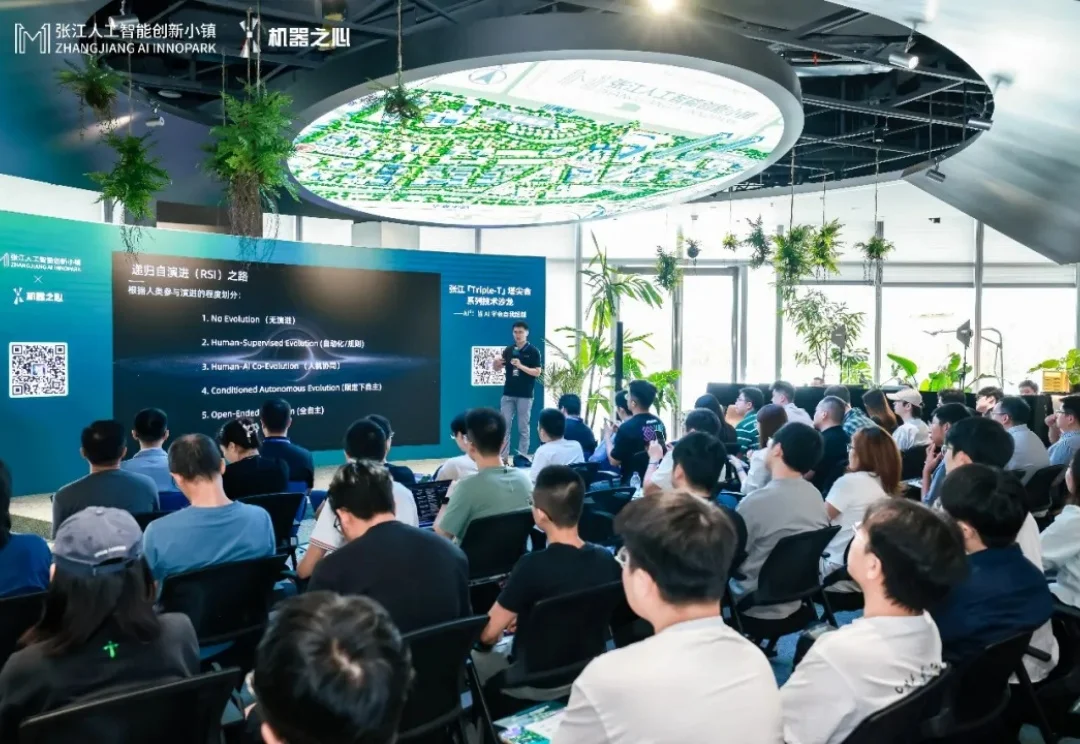
AI 距离真正的递归自我改进(RSI)还有多远?当前,AI 已开始参与数据生成、训练优化、工具迭代与结果验证,但参与研发,并不意味着已经具备持续改进自身的能力。它能够自主完成哪些环节,又如何将局部优化连接成持续、可靠的改进闭环?回答这些问题,需要回到具体的研究与实践,审视已有进展与尚待突破的瓶颈。
“越来越多企业出海,从第一天开始就面向全球客户。但全球化不再只是进入更多的国家,它也意味着从第一天开始就要建立能让产品、收入和运营共同扩展的商业架构。”负责Stripe大中华区企业销售业务的刘斯成说。
在代码领域,我们已经越来越习惯一个词:Vibe Coding。