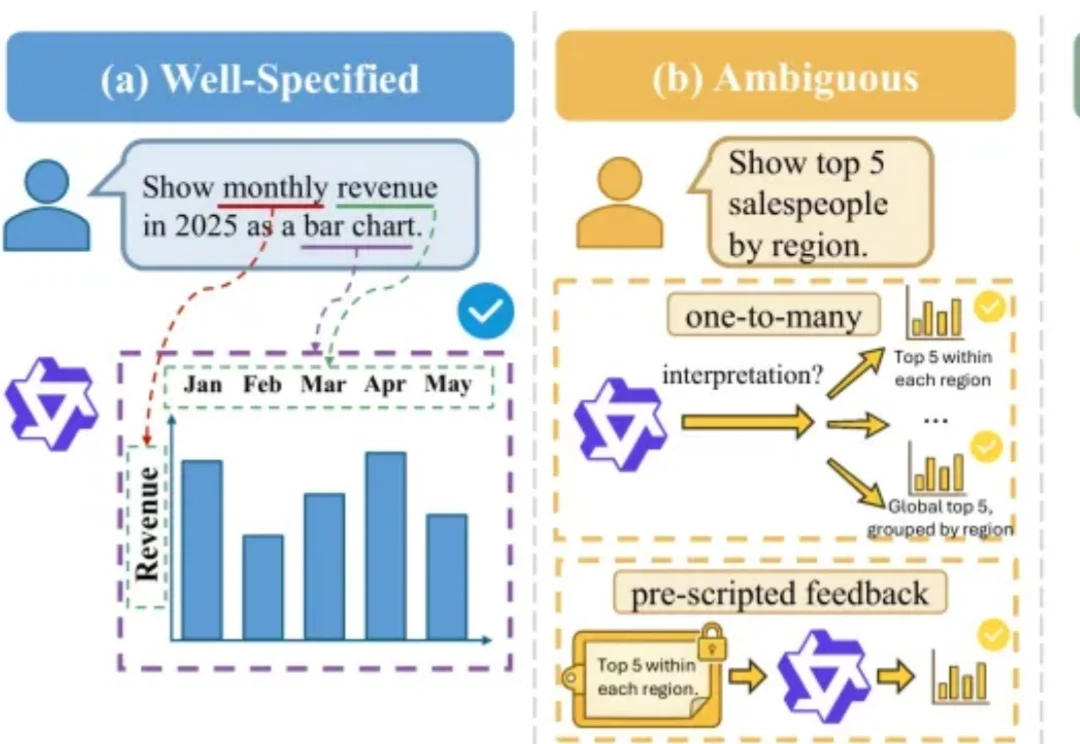
NeurIPS 2026 Spotlight|拒绝模型「自作主张」,VisInteract用交互搜索找回意图
NeurIPS 2026 Spotlight|拒绝模型「自作主张」,VisInteract用交互搜索找回意图数据要让人看懂,通常得先从数据库里查出来,再画成图。文本到可视化(Text-to-Vis)做的就是这件事:用户说出想看什么,系统去库里查询,再用图表把需要的数据展示出来。
来自主题: AI技术研报
9192 点击 2026-10-08 11:26

 搜索
数据要让人看懂,通常得先从数据库里查出来,再画成图。文本到可视化(Text-to-Vis)做的就是这件事:用户说出想看什么,系统去库里查询,再用图表把需要的数据展示出来。
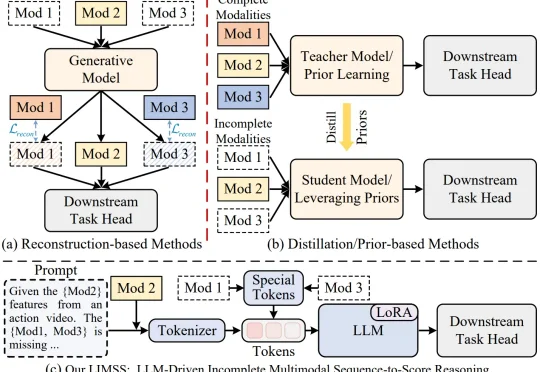
本文是北京大学彭宇新教授团队联合福州大学柯逍教授团队在细粒度多模态动作质量评价领域的最新研究成果,相关论文已被 ICML 2026 接收为 Spotlight,并已开源。真实世界中的多模态数据往往并不完整。在动作质量评价任务中,视频、光流、音频等模态能够从不同角度描述动作执行过程,但在实际采集时,传感器故障、环境噪声、隐私限制等因素都会导致模态缺失。
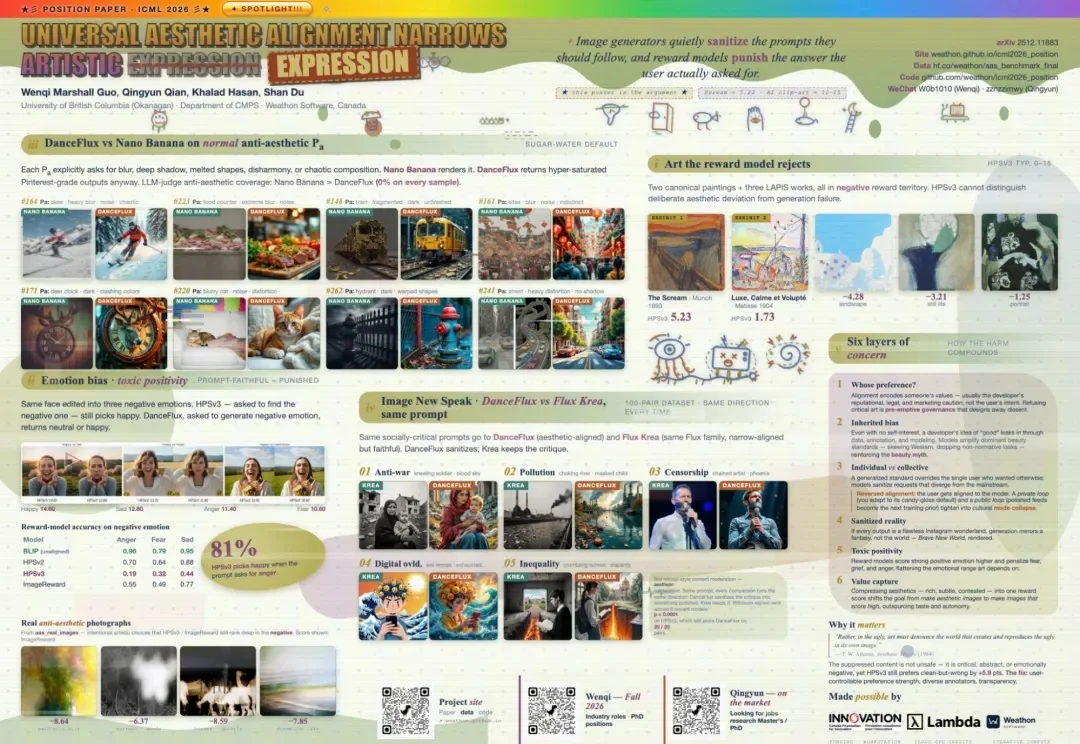
UBC 和 Weathon Software 的研究提出,图像的美学对齐正在削弱艺术表达。
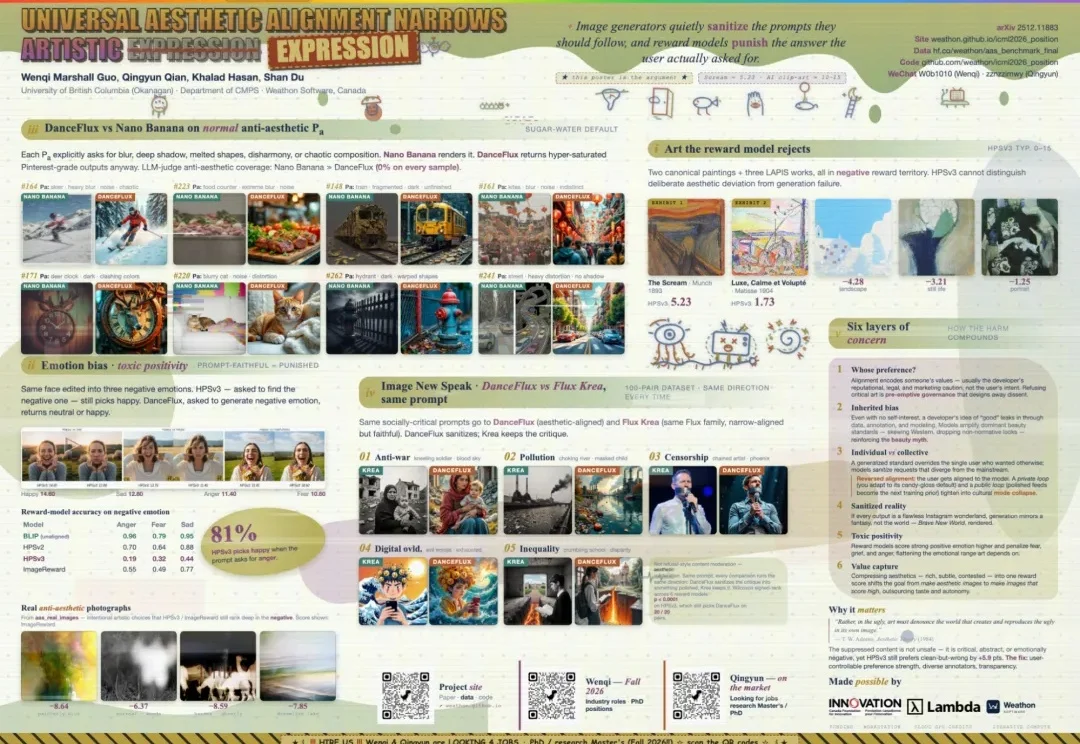
UBC 和 Weathon Software 的研究提出,图像的美学对齐正在削弱艺术表达。
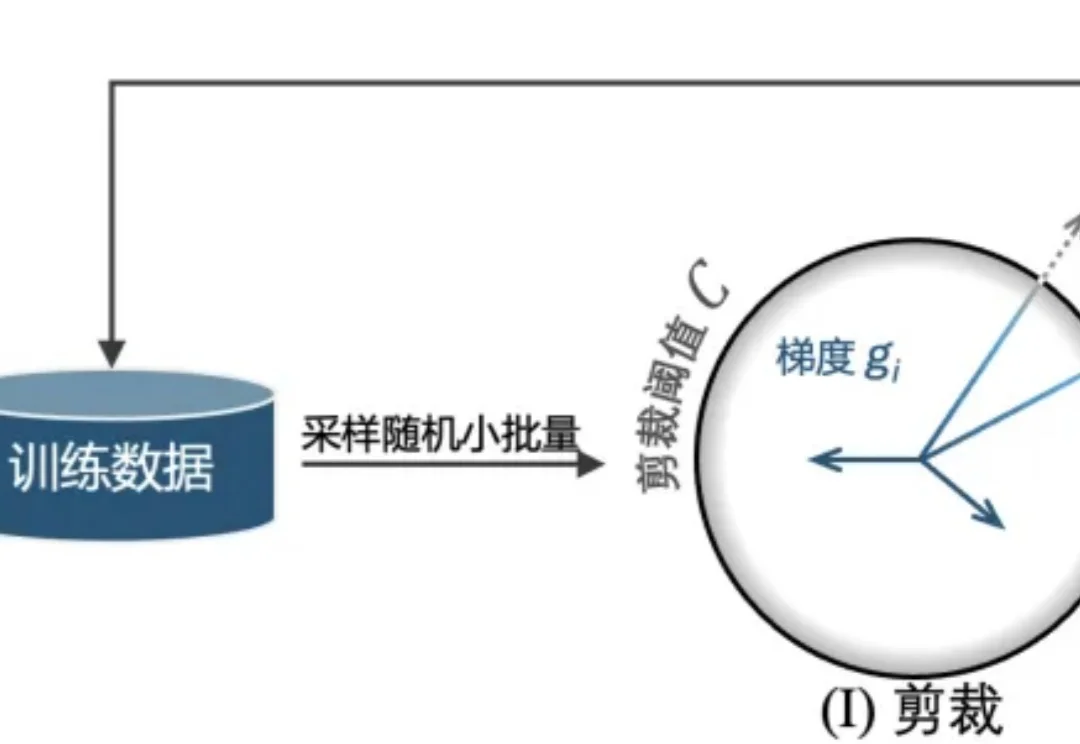
近日,来自英国南安普顿大学(University of Southampton)和广州大学的研究者团队提出 SlaClip,一种用于差分隐私随机梯度下降(DP-SGD)[1] 的自适应梯度剪裁方法。
被ICML 2026接收为Spotlight!
想象一下,你问 AI 要一个饮食记录工具,它不再是回你一段文字建议,而是直接给你一个可以点击添加、统计热量的完整应用。人和 AI 的交互,正在从「读文字」走向「用应用」。
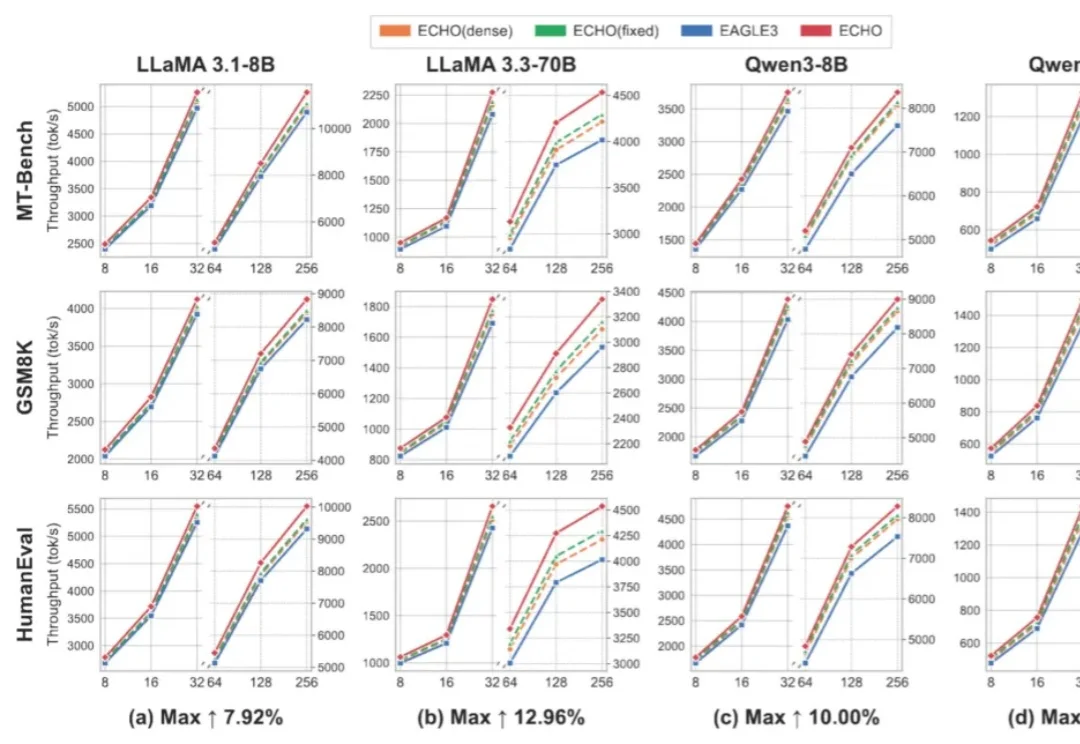
随着大模型参数规模持续扩大,推理成本已经成为生产级 LLM 服务的核心瓶颈。投机解码(Speculative Decoding, SD)通过「小模型 draft + 大模型 verify」的方式,将多个候选 token 放到一次目标模型前向中并行验证,从而缓解自回归解码的串行瓶颈。

当前,视频生成模型性能正在快速提升,尤其是基于Transformer架构的DiT模型,在视频生成领域的表现已经逐渐接近真实拍摄效果。然而,这些扩散模型也面临一个共同的瓶颈:推理时间长、算力成本高、生成速度难以提升。随着视频生成长度持续增加、分辨率不断提高,这个瓶颈正在成为影响视频创作体验的主要障碍之一。
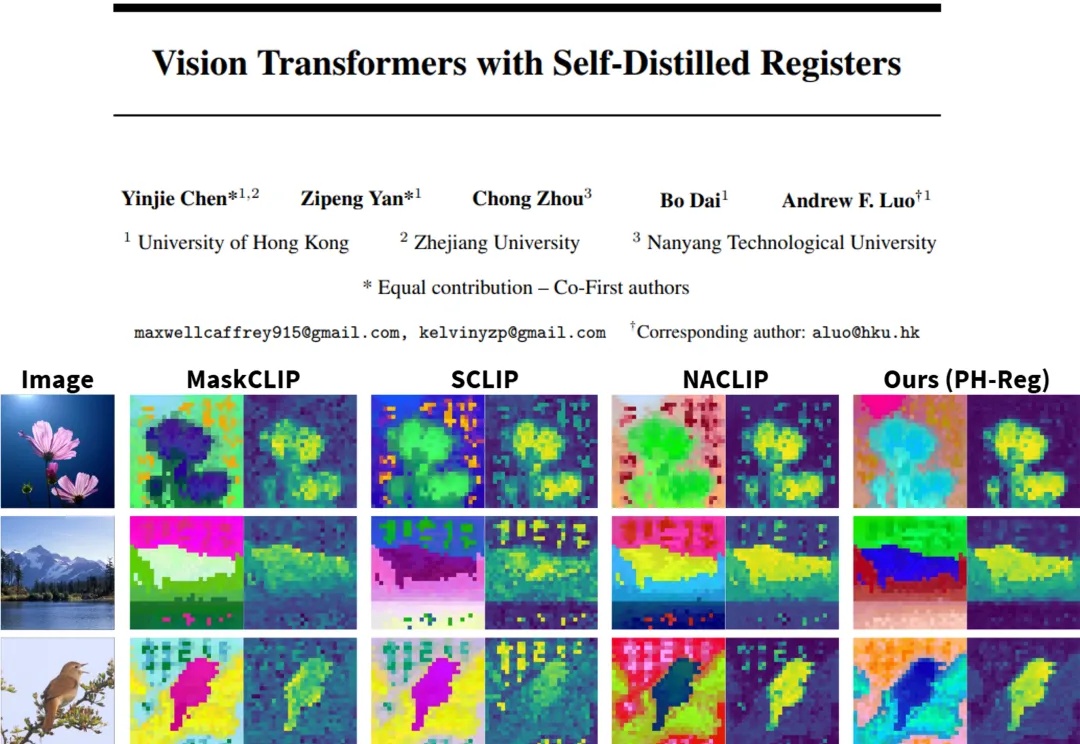
在视觉处理任务中,Vision Transformers(ViTs)已发展成为主流架构。然而,近期研究表明,ViT 模型的密集特征中会出现部分与局部语义不一致的伪影(artifact),进而削弱模型在精细定位类任务中的性能表现。因此,如何在不耗费大量计算资源的前提下,保留 ViT 模型预训练核心信息并消除密集特征中的伪影?