NeurIPS 2026 Spotlight|拒绝模型「自作主张」,VisInteract用交互搜索找回意图
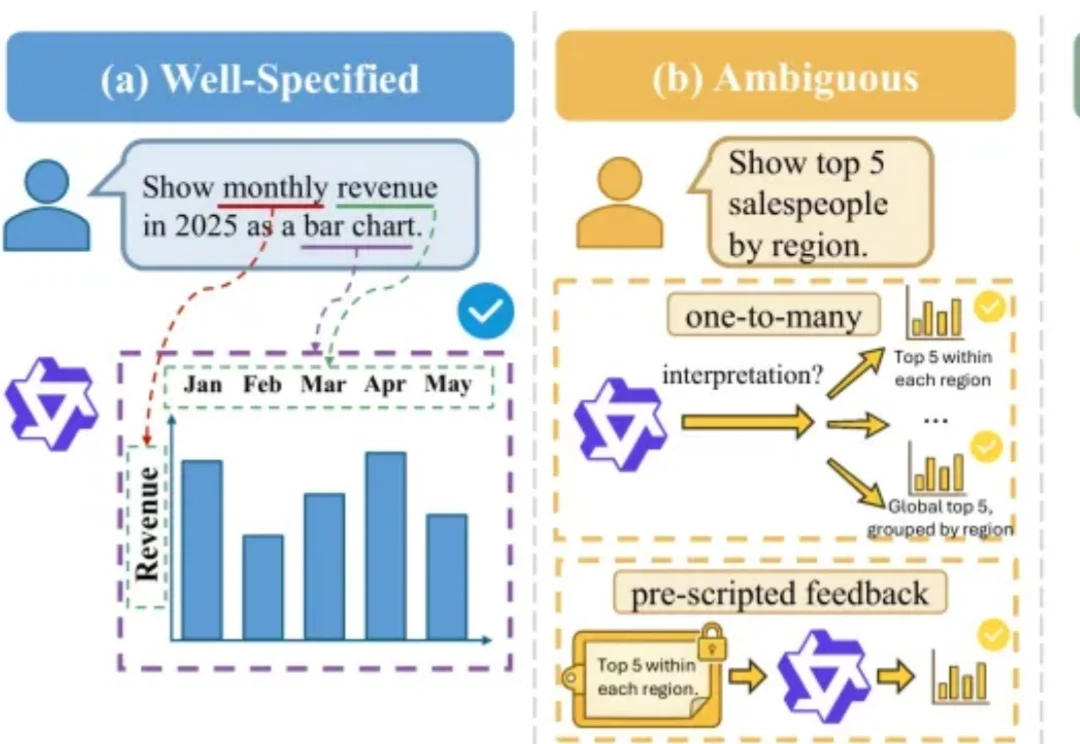
NeurIPS 2026 Spotlight|拒绝模型「自作主张」,VisInteract用交互搜索找回意图数据要让人看懂,通常得先从数据库里查出来,再画成图。文本到可视化(Text-to-Vis)做的就是这件事:用户说出想看什么,系统去库里查询,再用图表把需要的数据展示出来。
来自主题: AI技术研报
9190 点击 2026-10-08 11:26

 搜索
数据要让人看懂,通常得先从数据库里查出来,再画成图。文本到可视化(Text-to-Vis)做的就是这件事:用户说出想看什么,系统去库里查询,再用图表把需要的数据展示出来。
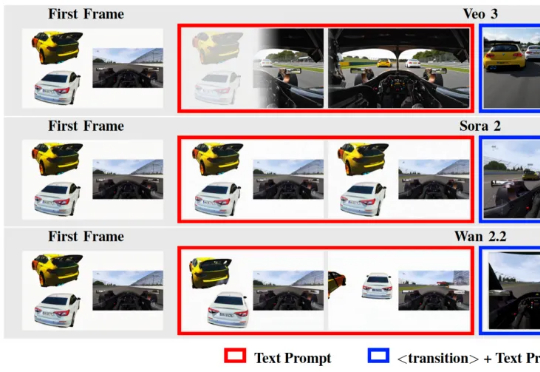
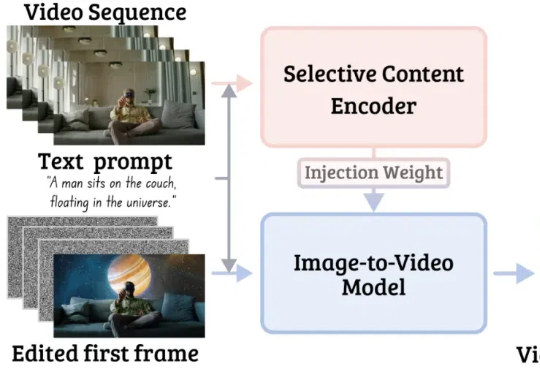
在 Text-to-Video / Image-to-Video 技术突飞猛进的今天,我们已经习惯了这样一个常识: 视频生成的第一帧(First Frame)只是时间轴的起点,是后续动画的起始画面。
论文一作刘少腾,Adobe Research实习生,香港中文大学博士生(DV Lab),师从贾佳亚教授。主要研究方向是多模态大模型和生成模型,包含图像视频的生成、理解与编辑。作者Tianyu Wang、Soo Ye Kim等均为Adobe Research Scientist。