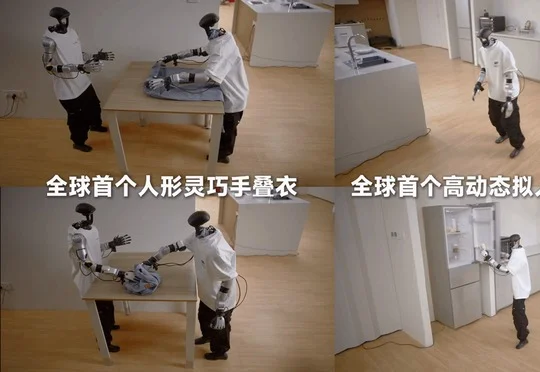
全球首次!杭州具身黑马比肩Figure,全身协同自主叠衣
全球首次!杭州具身黑马比肩Figure,全身协同自主叠衣西湖机器人升级通用大脑WR1,采用全球首创的通用大小脑双预训练系统架构,融合WM、VLA与GAE,完成双机器人协同折叠衣物及跨厨房、客厅、卧室的连续自主家务演示。
来自主题: AI资讯
7625 点击 2026-10-10 12:37

 搜索
西湖机器人升级通用大脑WR1,采用全球首创的通用大小脑双预训练系统架构,融合WM、VLA与GAE,完成双机器人协同折叠衣物及跨厨房、客厅、卧室的连续自主家务演示。
上海交通大学卢策吾、汶川团队联合穹彻提出LIFT(Late Reactive Injection of Force for VLA Post-Training),被CoRL 2026高分收录,该方法在保留预训练知识的前提下,仅通过20至30条在线带力数据后训练即可让VLA学会力反馈,显著提升叠毛巾、插书、汉诺塔圆环放置等接触密集型任务表现。
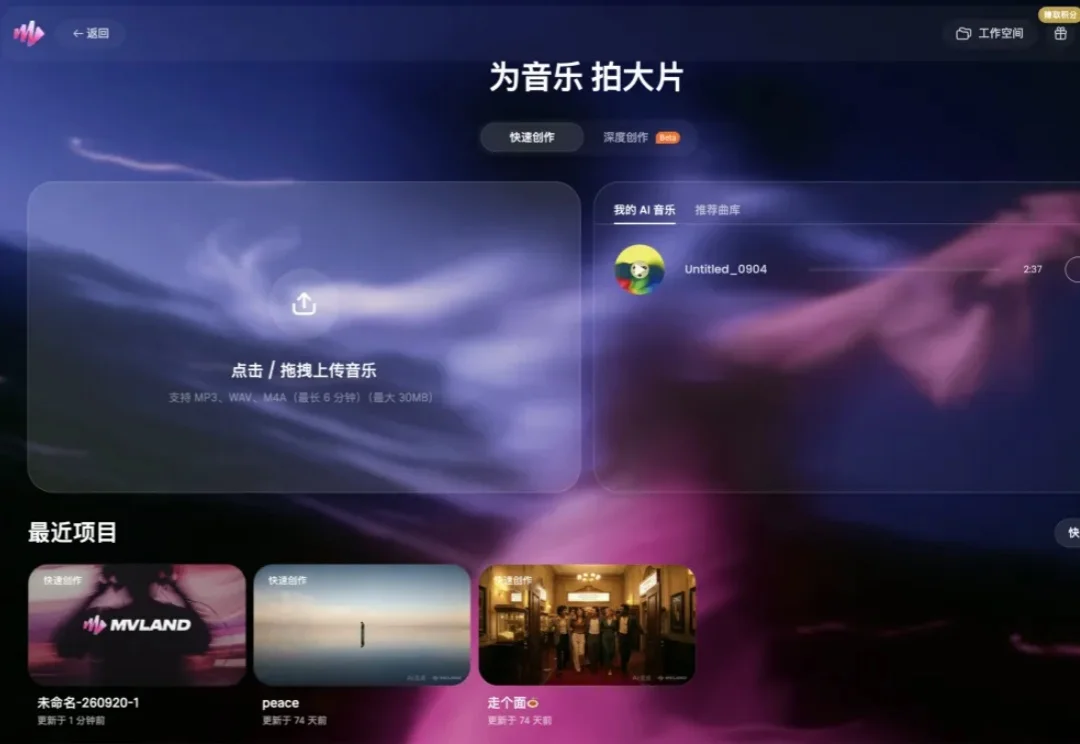
今天中午,看到 MVLAND上线了深度创作模式。
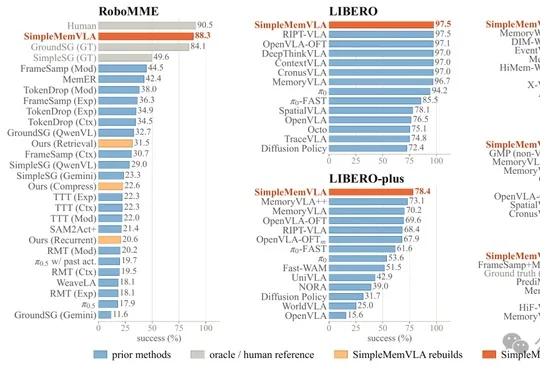
SimpleMemVLA由面壁智能联合华中科技大学等机构提出,将带时间戳的原生视觉历史直接作为机器人记忆上下文,在四项记忆基准取得SOTA并涌现视觉上下文学习能力,同时通过流式推理优化将60秒历史决策延迟从1.02秒降至0.68秒。
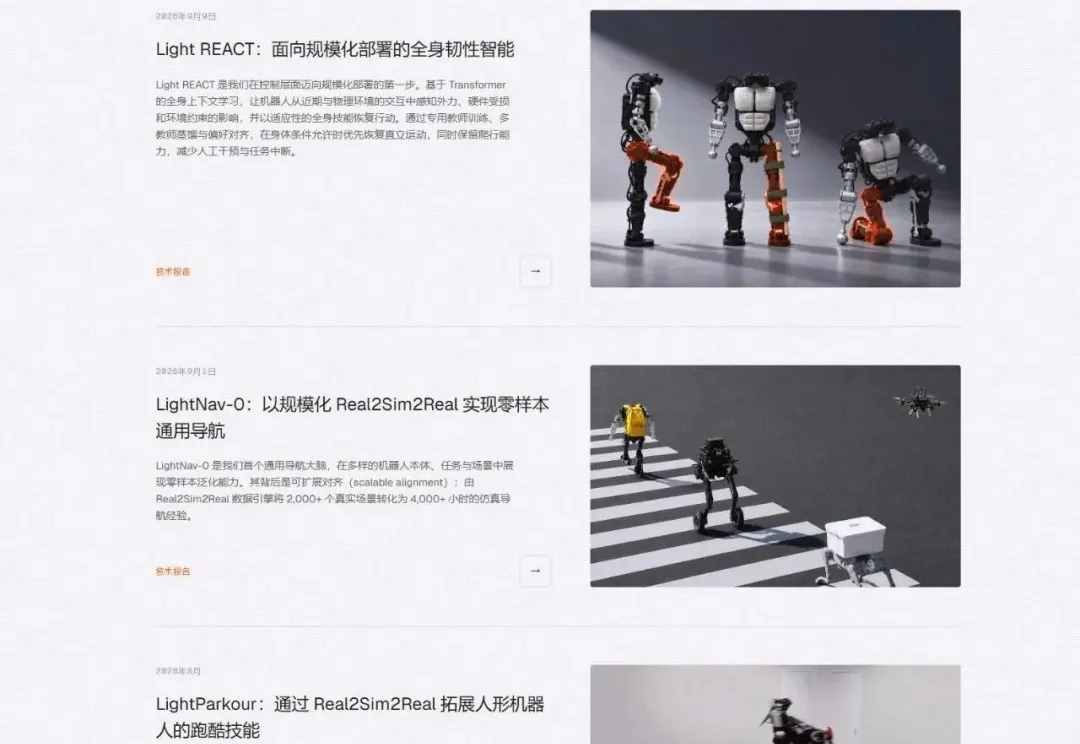
过去一年,具身智能的技术迭代明显加快。VLA、世界模型持续演进,强化学习重新成为机器人学习的重要技术路径,Sim2Real加速从仿真走向真机,全身控制能力也在快速突破。
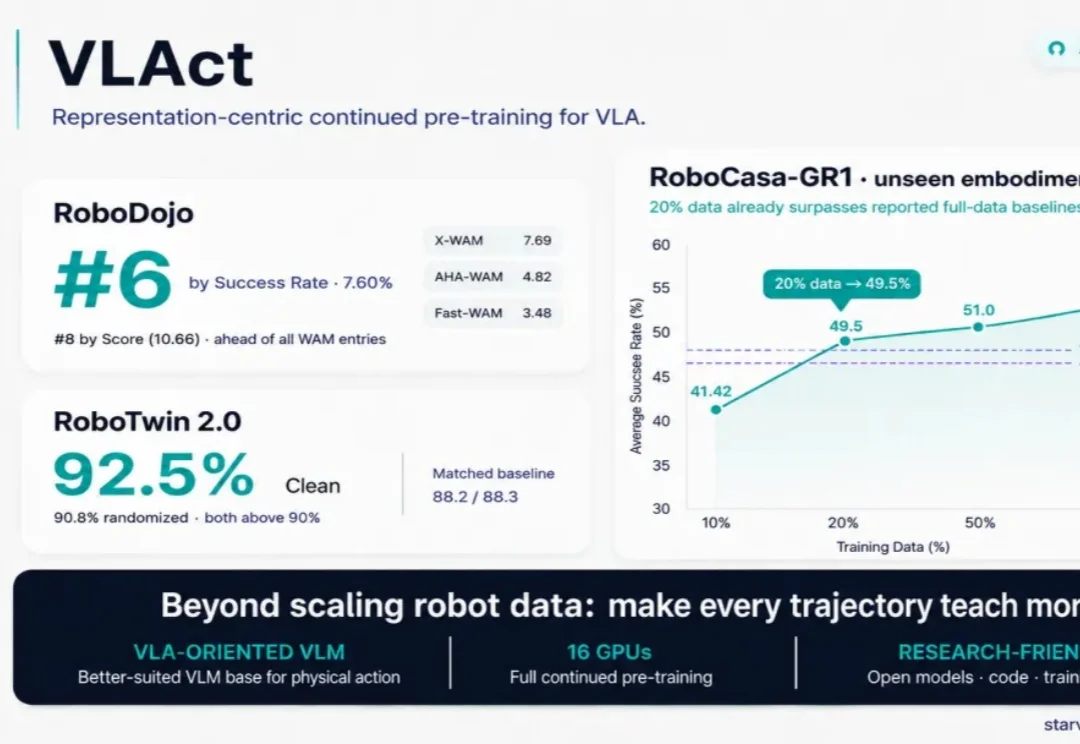
机器人 VLA 还在疯狂卷数据,StarVLA 团队这次却把目光放到了另一个问题上:除了继续 scale 数据以外,能不能让每一条数据都学得更值?
过去几年,机器人操作领域几乎被一批新概念重新 “刷屏”。 LLM Planner、VLA、Diffusion Policy、Flow Matching、Latent Action、World Mode
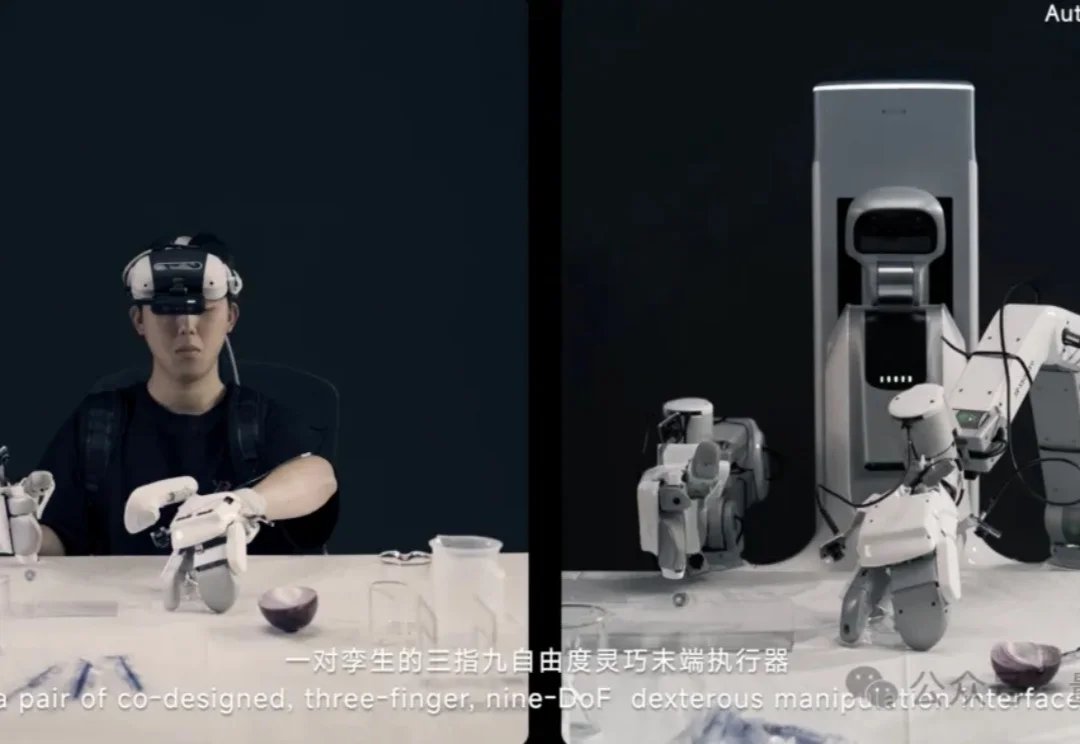
今年5月,英伟达机器人负责人Jim Fan在一场公开演讲中宣告:VLA、遥操已死。
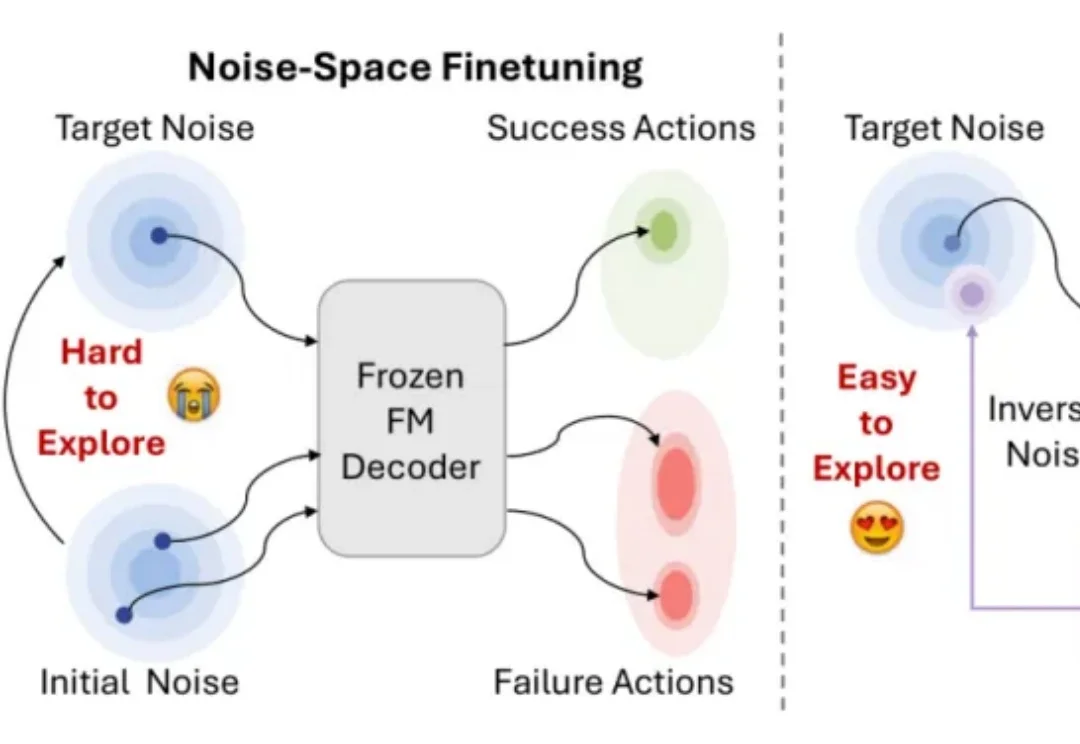
视觉 - 语言 - 动作模型(Vision-Language-Action Model,VLA)正在成为机器人操作的重要基础模型。经过少量示范微调后,VLA 已经能够完成抓取、放置、堆叠等多种任务。然而,一旦任务涉及精密接触、狭小容差或分布外位置,模型的成功率仍会明显下降。
S²-VLA 引入信念状态和自适应动态门控,仅用2B参数、7GB显存,长程操控超越7B模型。