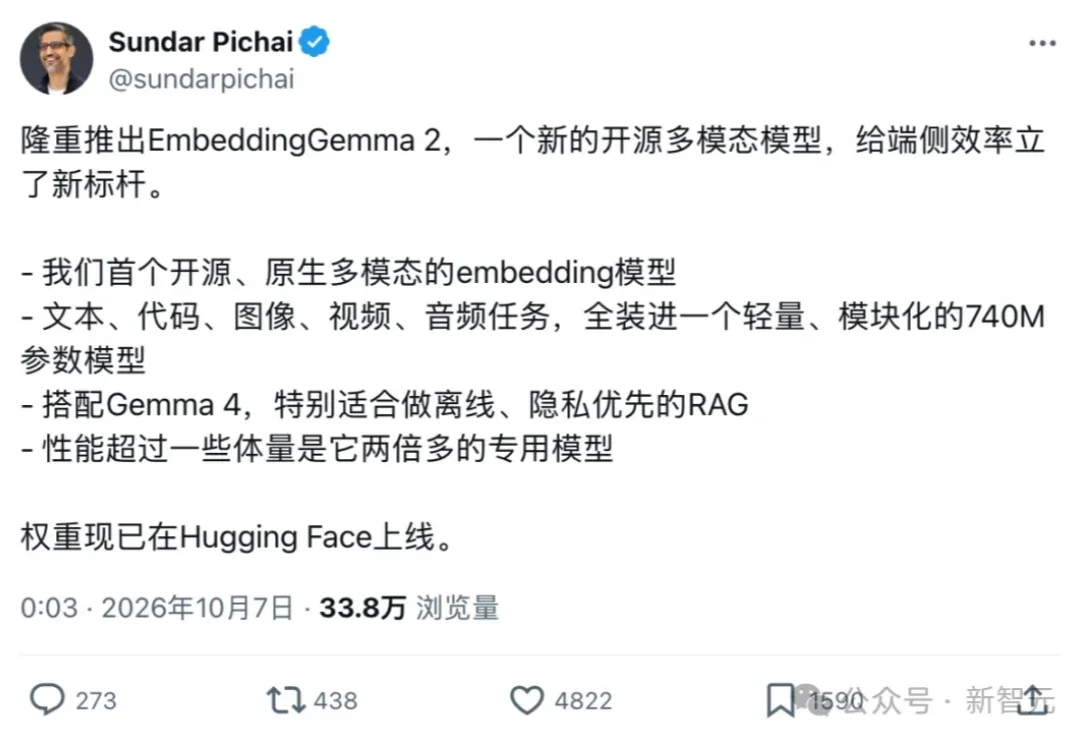
谷歌把AI搜索塞进手机!不到600MB,照片、视频、录音断网照样搜
谷歌把AI搜索塞进手机!不到600MB,照片、视频、录音断网照样搜10月6日,谷歌开源EmbeddingGemma 2,把一个能搜图、看视频、听声音的搜索引擎,塞进了一个内存不到600MB的小模型!
来自主题: AI资讯
8390 点击 2026-10-08 12:14

 搜索
10月6日,谷歌开源EmbeddingGemma 2,把一个能搜图、看视频、听声音的搜索引擎,塞进了一个内存不到600MB的小模型!
中国人民大学代文林、孟澄研究员团队提出的ME-Decoding方法被EMNLP 2026接收,该方法在解码时同时利用token概率与embedding相似度,从集合层面筛选低冗余候选token,在GSM8K和GPQA上取得所比较方法中最高的平均准确率,端到端GPU延迟仅增加约3%。
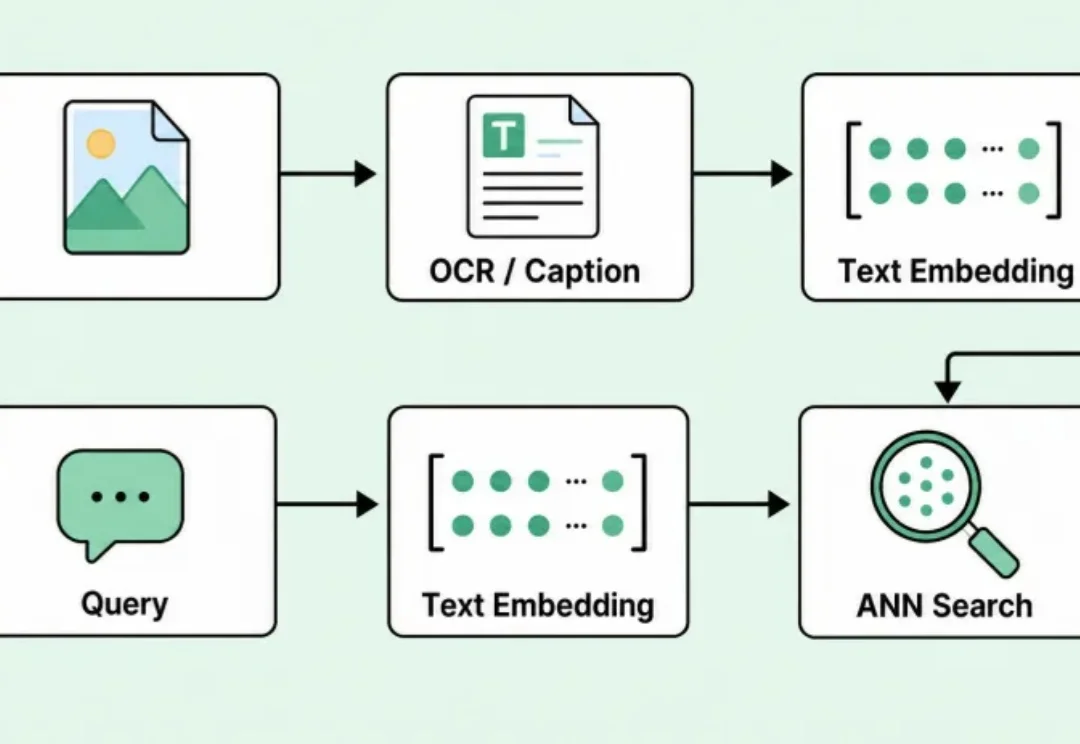
前不久,微信视觉团队开源了WeMM-Embedding。
研究团队提出了符号嵌入量子算法(Sign Embedding Quantum Algorithms),形成了一篇84页的量子算法论文。可以说,相比此前主要解决研究者给定的开放数学问题,这一次,AIM开始参与研究问题的提出与方向探索。
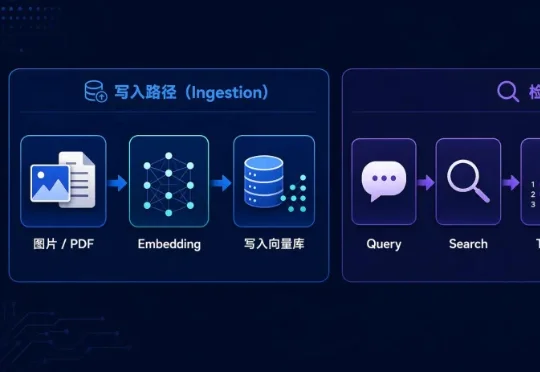
多模态 Agent 的记忆系统,过去很容易被理解成一个升级版 RAG:图片、图表、PDF 进来之后,先抽取内容、做 embedding、写进向量库;用户提问时,再用 query 做检索,把命中的top-k图片、文档页或图表一并塞进上下文,再交给多模态模型回答。整个过程中,所有原始模态信息都会不加选择的塞给大模型。
一篇发表于 2015 年的论文《LINE: Large-scale Information Network Embedding》被授予 Seoul Test of Time Award(时间检验奖)。这篇由国际知名 AI4S 科学家、Mila 终身教授、百奥几何公司创始人唐建博士领衔
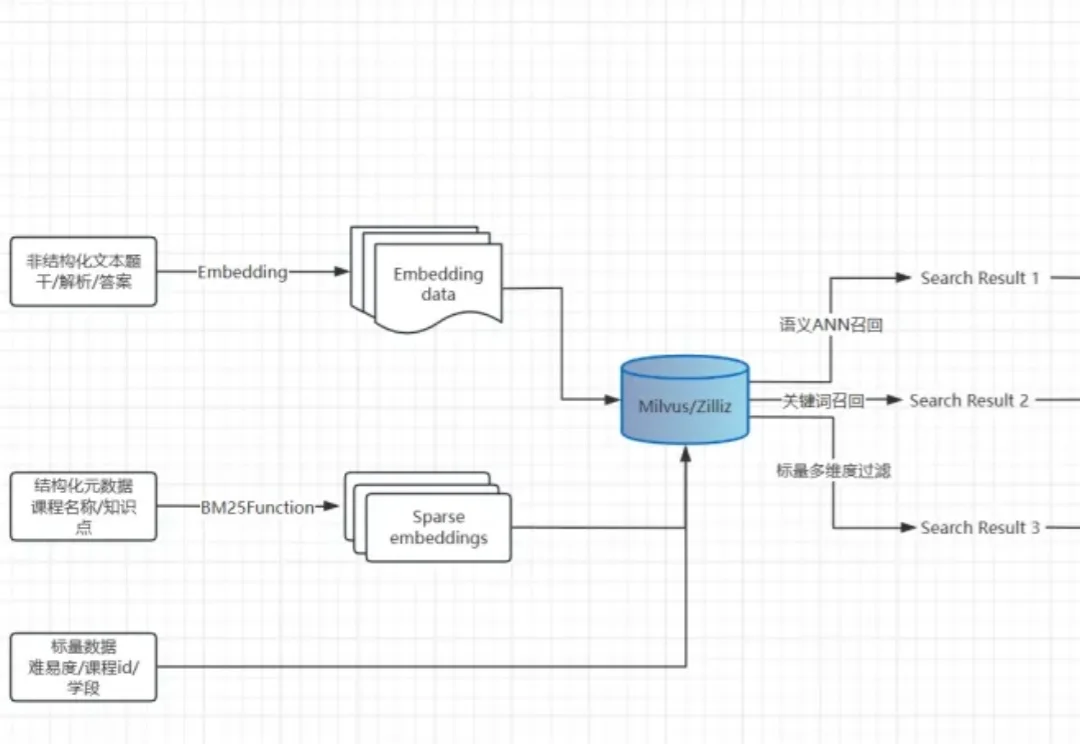
在教育科技领域,题库是核心资产,更是连接学生、教师与知识体系的关键入口。
jina-embeddings-v5-omni正式发布,我们把 v5-text 向量模型的能力延伸到图像、音频和视频。文本侧不变,v5-omni 产出的文本向量与 v5-text逐字节一致,无需重建任何已有索引。
Google悄悄干了一件大事——Gemini Embedding 2正式进入GA阶段,成为Gemini API中第一个原生多模态embedding模型。它能把文本、图片、视频、音频、PDF文档全部映射进同一个统一向量空间,支持100多种语言。
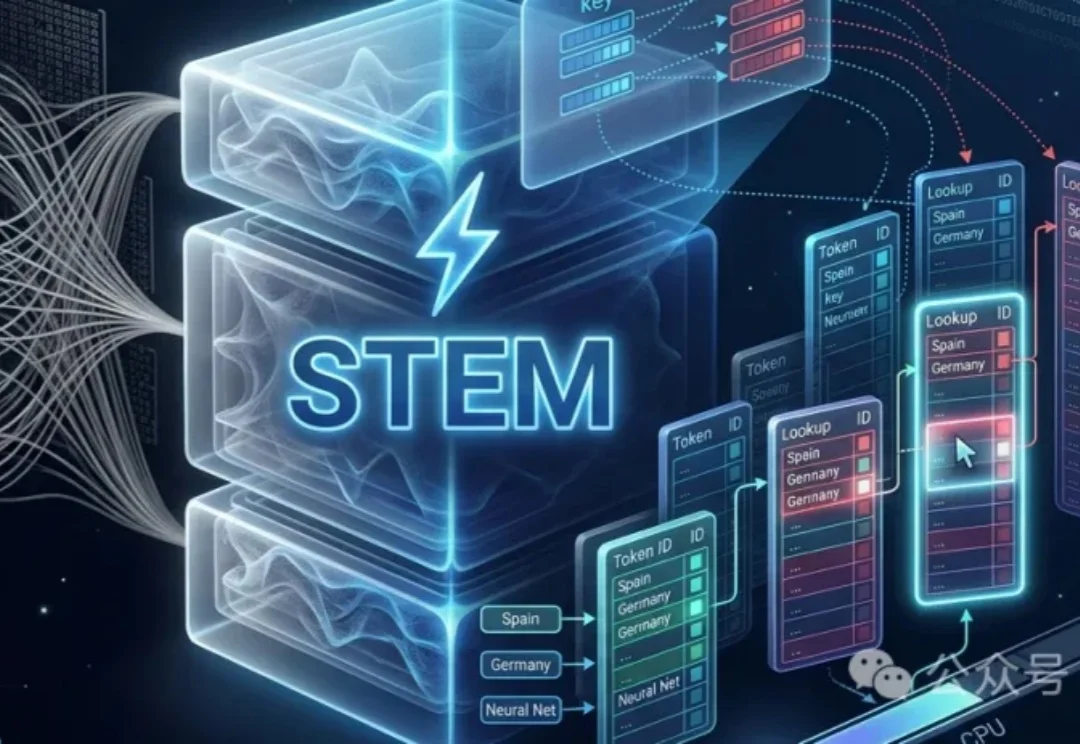
ICLR论文STEM架构率先提出「查表式记忆」架构,早于DeepSeek Engram三个月。它将Transformer的FFN从动态计算改为静态查表,用token索引的embedding表直接读取记忆,彻底解耦记忆容量与计算开销。