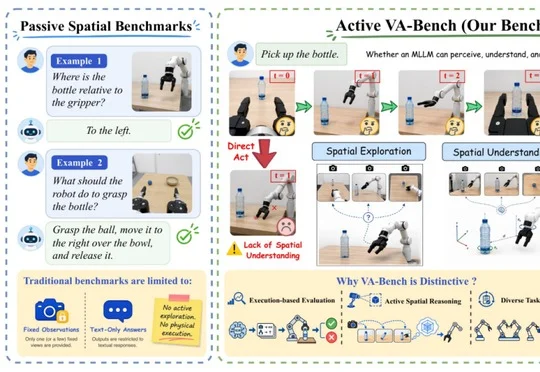
看懂不等于做对:VA-Bench测出大模型空间智能的执行断层
看懂不等于做对:VA-Bench测出大模型空间智能的执行断层VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
来自主题: AI技术研报
9238 点击 2026-10-05 23:29

 搜索
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
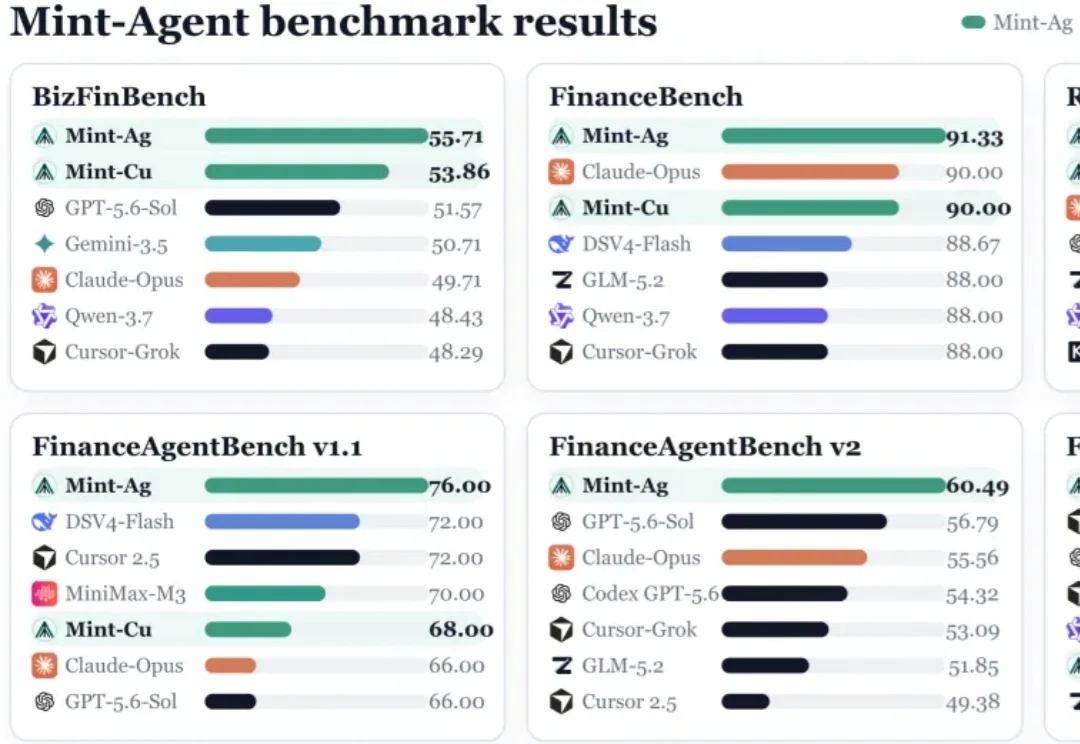
由华东师大智金院团队孵化的金融原生 Agentic Foundation Model 家族 Mint-Agent 正式发布。在 FinanceAgentBench v2 上,27B 的 Mint-Ag 达到 60.49%,超过 GPT-5.6-Sol 与 Claude Opus 4.8;单题推理成本分别仅为两者的约 22% 和 10%。
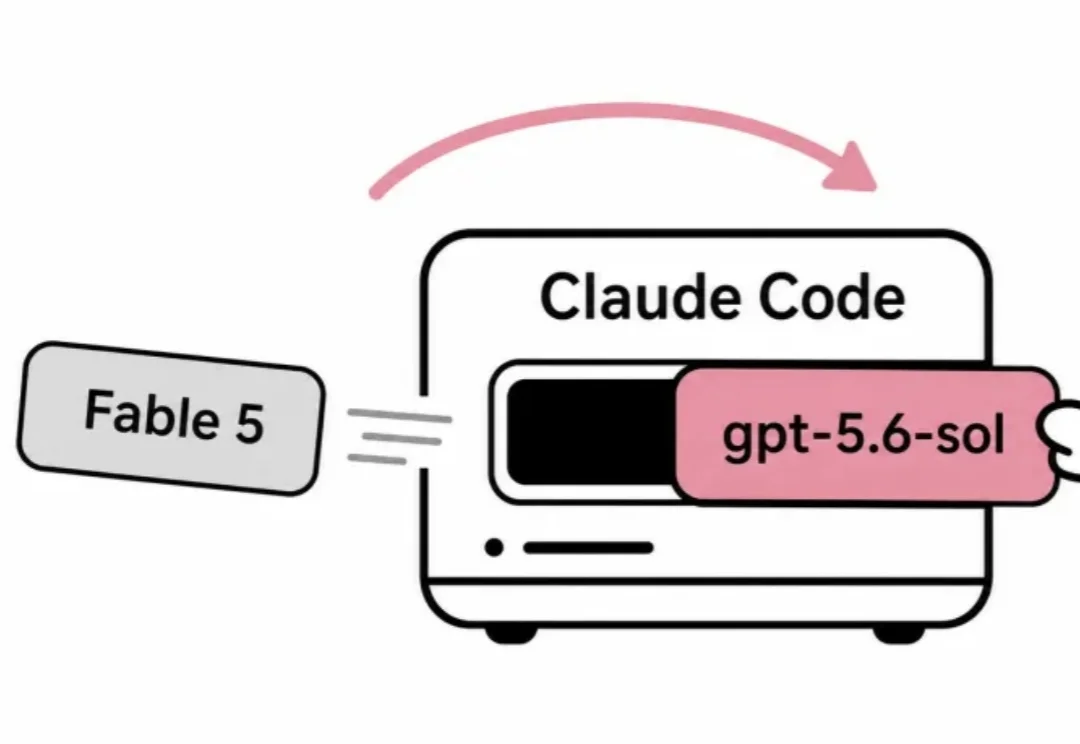
最近 Claude 又开始大面积封号,我的主号终究也没能幸免。
GPT-5.6-Sol 的攻防能力超越了 Claude Mythos 5!