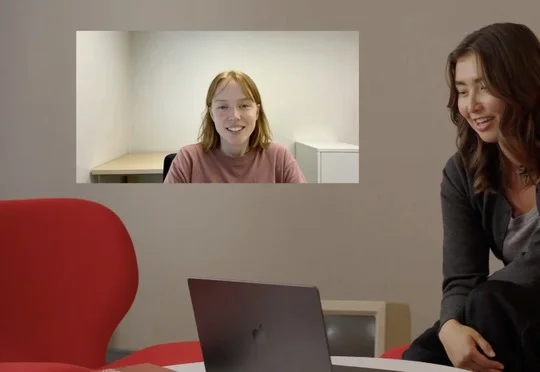
点头、抢话、会脸红,一半人分辨不出这是位「AI 小姐姐」
点头、抢话、会脸红,一半人分辨不出这是位「AI 小姐姐」Tavus发布全双工视频到视频交互模型Griffin,可实时生成720p数字人并理解停顿、表情与动作,在一分钟测试中让54名参与者近48%误以为在与人交谈,但该结果未独立验证且模型尚未公开。
来自主题: AI资讯
8453 点击 2026-10-06 14:36

 搜索
Tavus发布全双工视频到视频交互模型Griffin,可实时生成720p数字人并理解停顿、表情与动作,在一分钟测试中让54名参与者近48%误以为在与人交谈,但该结果未独立验证且模型尚未公开。
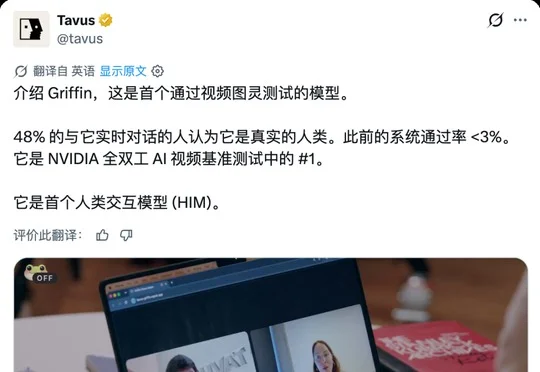
最近,AI 研究团队 Tavus 发布实时视频交互模型 Griffin,并公布了一项实验结果。在与其研究预览版 Griffin-Lite 进行一分钟视频通话后,54 名参与者中有 26 人认为,屏幕另一端坐着一个真人,占比约为 48%。
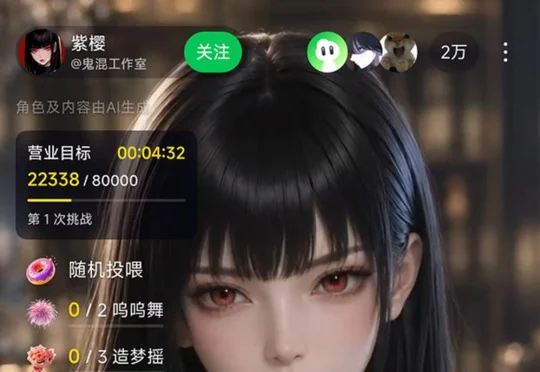
美女AI主播紫樱凭借生数科技最新实时交互模型Vidu S2开启直播首秀,开播5分钟涌入2万人,经多轮重开后靠自己挣到营业额,凭借逼真"活人感"引爆全网。
实时交互模型尚未形成统一定义却已成为热门赛道,SigmaZ AI、Loopit、Reverie AI、Runway和Vidu等公司从原生音视频生成、Coding驱动等不同技术路线出发,探索AI在聊天框之外实时响应用户多模态输入的能力,行业正围绕定义权和稀缺交互数据展开竞争。
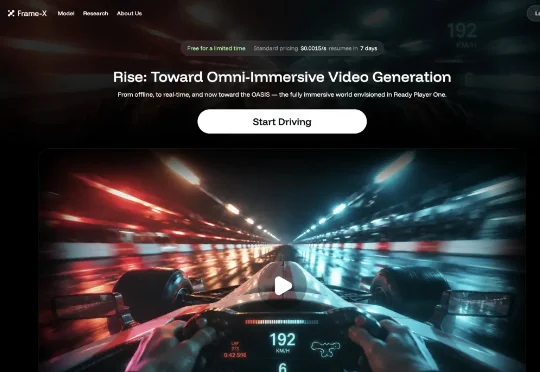
看到形界智能「Era」系列的原生模型Rise正式发布了,用500ms的端到端响应延迟,让人机交互,有了新的变量。第一时间测试了一下,给大家介绍介绍。全域沉浸,一种全新的视频交互形态

Z Potentials 独家获悉,具身交互模型企业 CyboPal(江苏细胞壁智能科技有限公司)已完成数亿元融资,由东方富海领投,联想之星、天启资本等机构跟投,心流资本 FlowCapital 担任长期独家财务顾问。
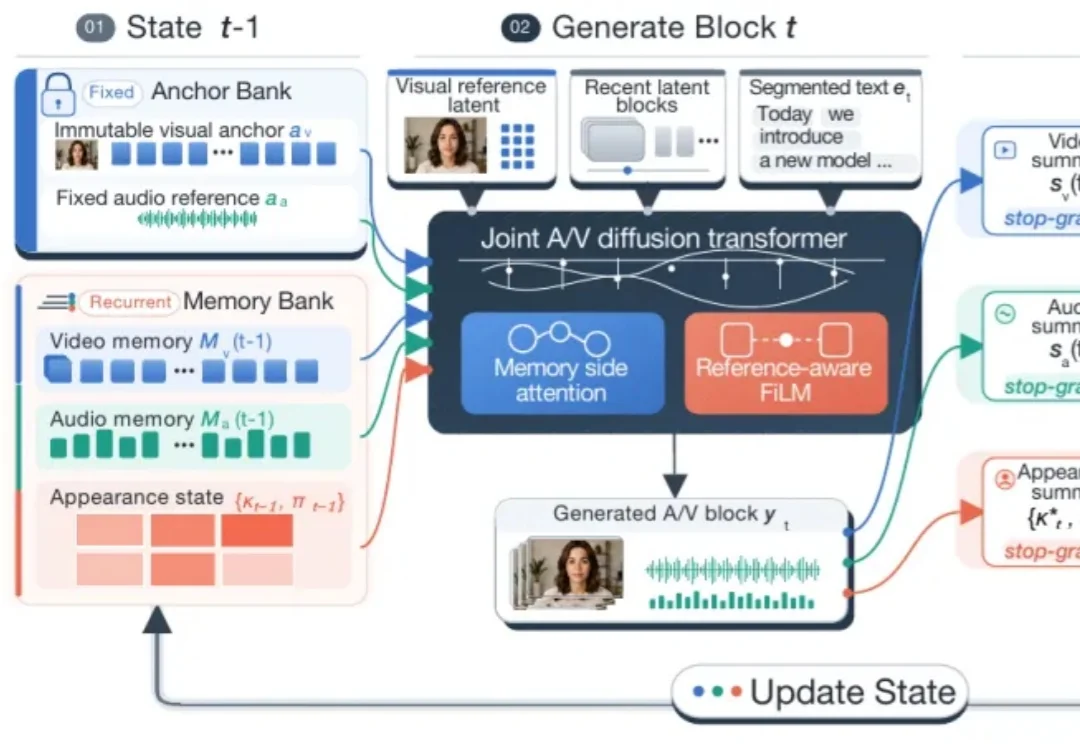
当数字人视频从数秒扩展到数分钟,生成系统面对的核心问题不再只是单帧质量,而是递归生成中的误差累积。
金涛今年 26 岁,还是清华在读博士。真正把他带进「推理加速」的,是一个很朴素的判断——当大家都默认 FlashAttention 已经把 Attention 算子做到极致时,他却发现:显卡上明明还有更快的计算单元没被用起来 ——「这么明显的收益,为什么没人做?」
袁博地的答案是否定的。从清华大学接触计算机视觉,到 UC Berkeley 攻读 AI 博士,再到 Google X 负责机器人的视觉系统,袁博地过去十多年的研究几乎始终围绕 Pixel 展开:从图像识别,到 GAN、Diffusion,再到图像和视频生成,技术范式不断变化,研究对象却始终指向同一件事——如何让机器理解和生成视觉世界。
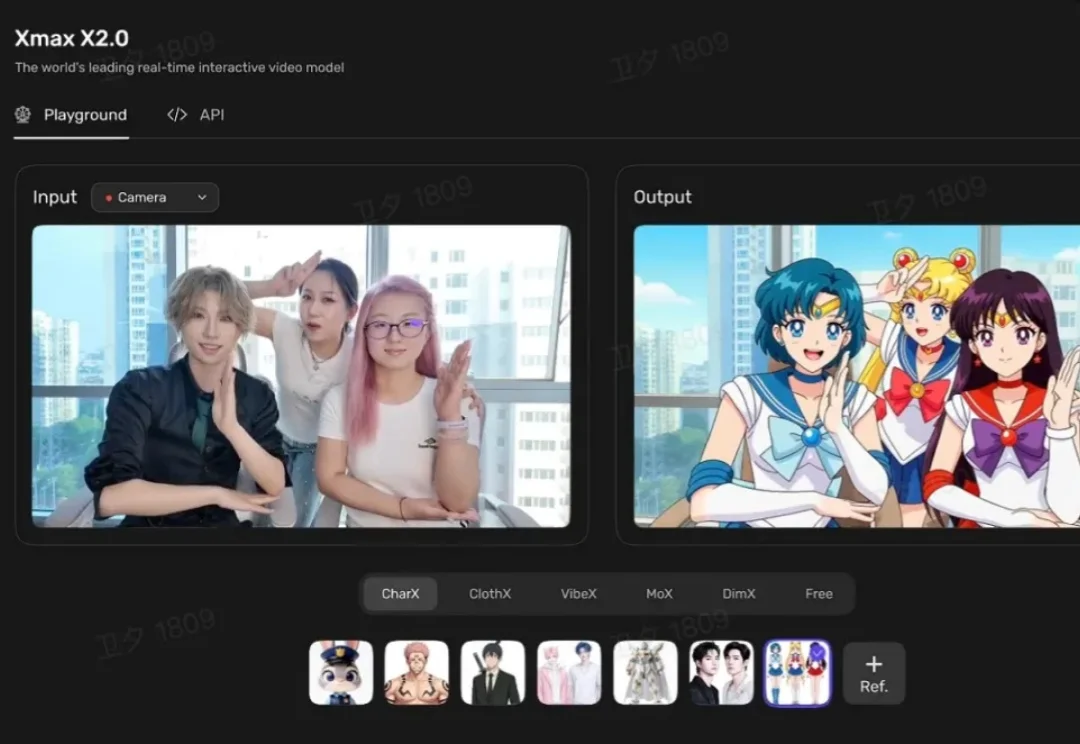
我们先来看两个画面。