何恺明团队发布多模态Harness框架
何恺明团队发布多模态Harness框架多模态模型的视觉原生Harness,来了!
来自主题: AI技术研报
8838 点击 2026-10-09 12:02

 搜索
多模态模型的视觉原生Harness,来了!
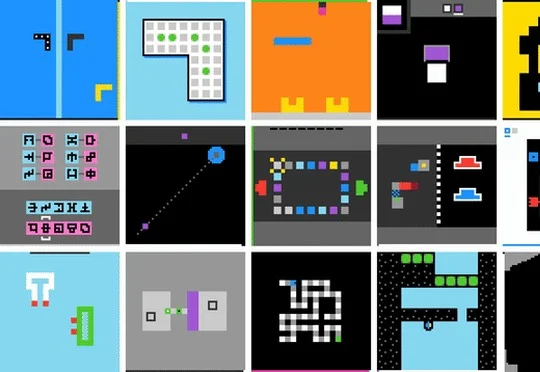
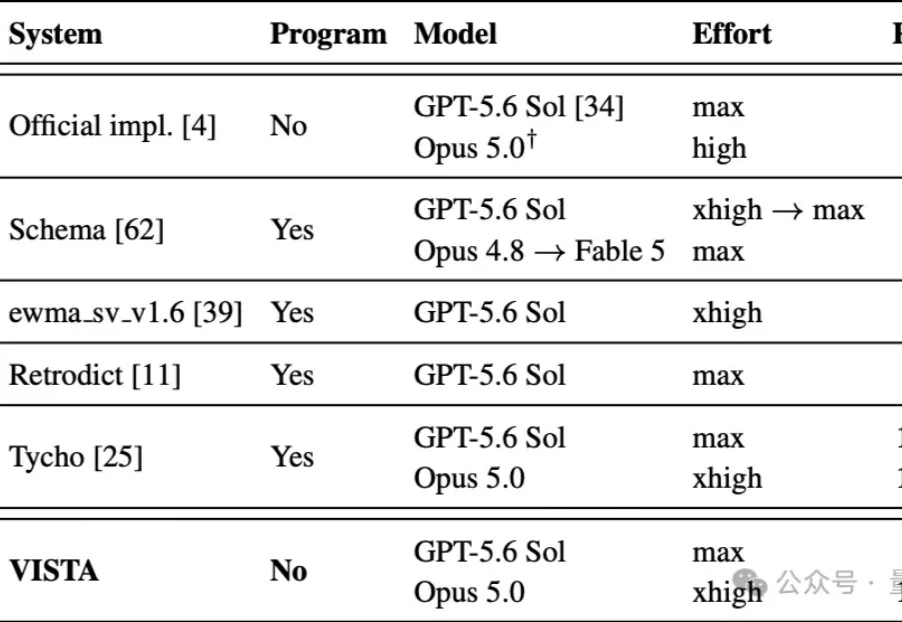
何恺明团队提出VISTA方法,将ARC-AGI-3的数字表换回图像并配备可随时翻看的视觉记忆相册,使Claude Opus 5拿下满分100分、GPT-5.6 Sol获得99分,证明卡住大模型的是眼睛和记性而非模型能力本身。

近日来自南京大学模式识别实验室(PRLab)的梁嘉骏、廖宇程,在司晨阳教授的指导下,联合新加坡南洋理工大学、英国帝国理工学院,提出连续扩散语言模型 AURORA-LM(Autoencoding Unified Representation for Continuous-Latent Diffusion Language Modeling),对连续空间下的语言建模作出了更多的思考和发现。
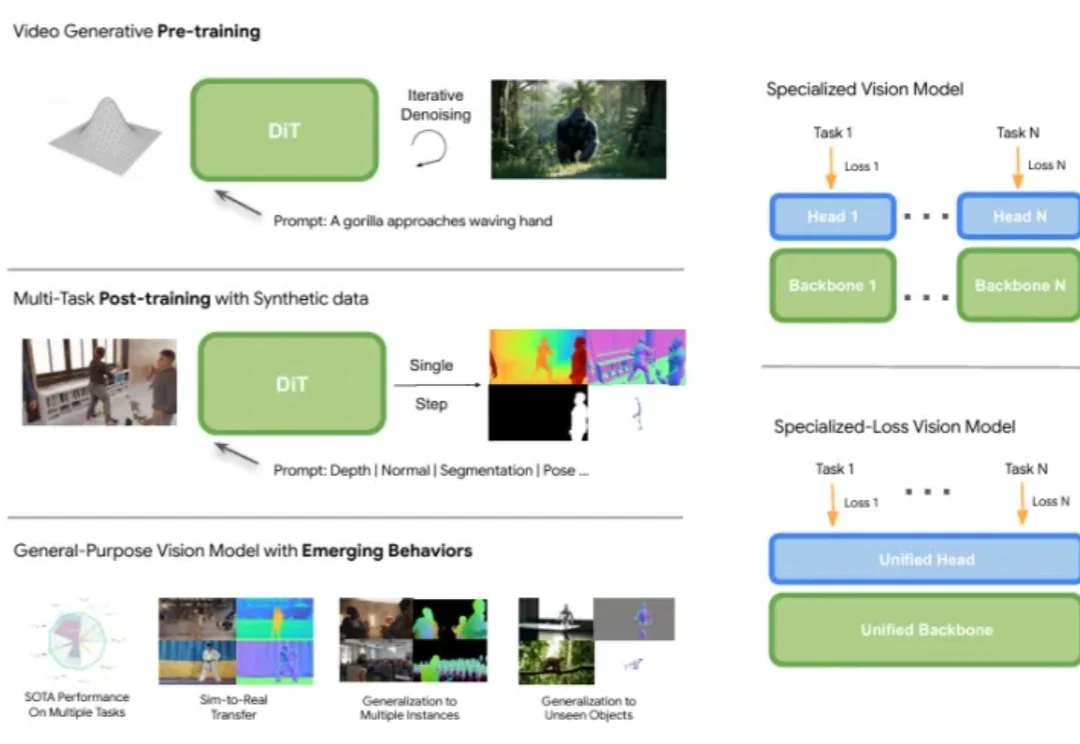
当下计算机视觉长期陷入“一任务一专用模型”内卷: 做深度估计要用DepthAnything,分割依赖SAM,人体姿态单独训练Sapiens,几何重建还得搭VGGT,各类网络骨干、解码器、损失函数完全割裂,研发与部署成本居高不下。
如果想开发一个视频理解应用,你会怎么做?
文本生成图像的领域早已经是一片红海,看上去已经卷无可卷了。
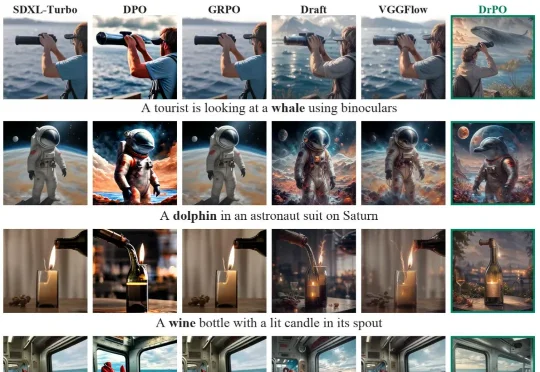
来自西湖大学和香港中文大学(深圳)的团队沿着这一思路提出 Drifting Preference Optimization(DrPO),把漂移场用于单步文生图模型的偏好后训练。在 DrPO 中,奖励只负责对候选图像排序,不参与反向传播。具体而言,针对同一个文本提示词,当前模型生成一组候选图像。高分样本在特征空间中产生吸引,低分样本产生排斥,并结合参考模型约束给出模型的更新方向。
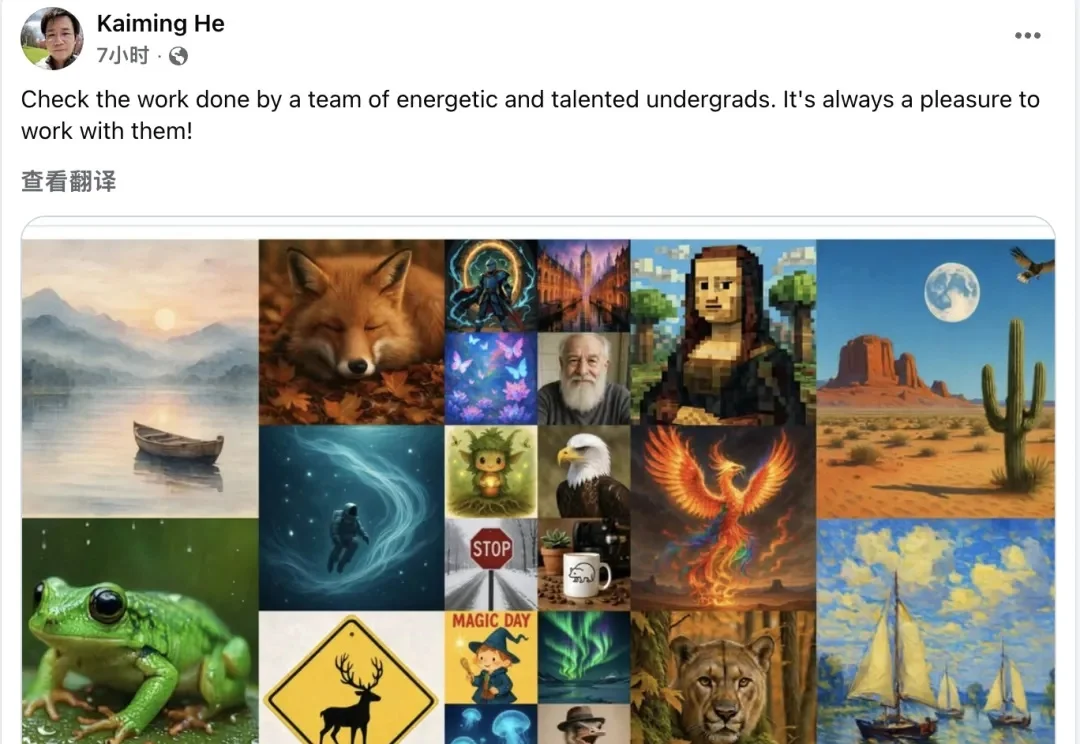
全员本科生! 刚刚,何恺明携本科生“军团”又放出一篇新论文。
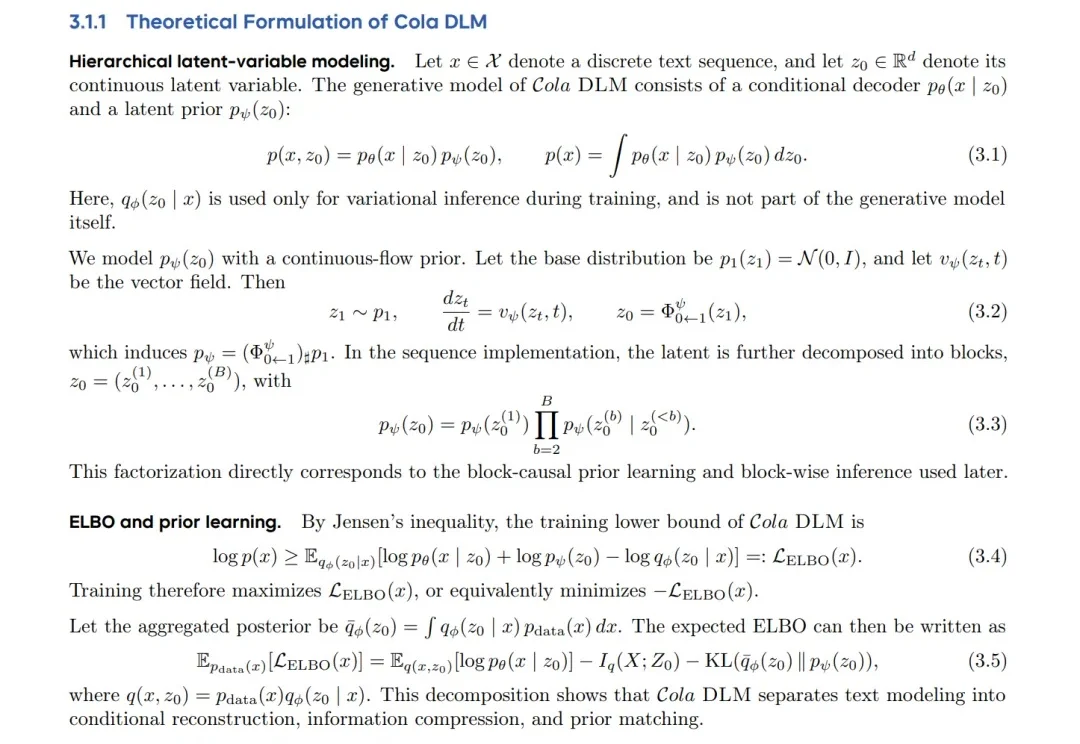
大语言模型真的只能走“预测下一个token”的路子吗?
何恺明,也下场做语言模型了。