图像生成模型调优新思路:让解码器“提前适应”生成器的潜变量
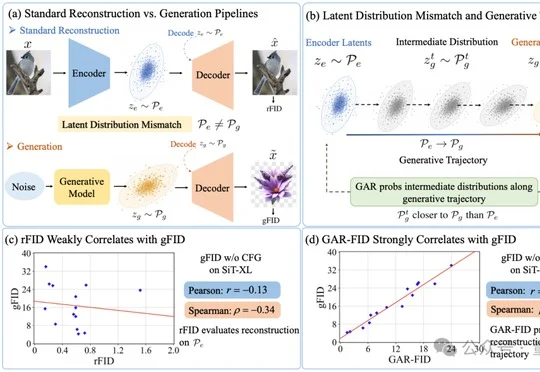
图像生成模型调优新思路:让解码器“提前适应”生成器的潜变量让图像生成模型先把图片压缩到潜空间,再由生成器在潜空间中作画,已成为常见路线。为了挑选图像编码器和解码器,研究者往往先看“重建”——把原图编码后再解码,所得图片是否逼真。
来自主题: AI技术研报
9022 点击 2026-10-10 12:34

 搜索
让图像生成模型先把图片压缩到潜空间,再由生成器在潜空间中作画,已成为常见路线。为了挑选图像编码器和解码器,研究者往往先看“重建”——把原图编码后再解码,所得图片是否逼真。
Anthropic发布Claude Haiku 5.5,单价为Haiku 4.5的十分之一,多项跑分显著提升,定位为处理摘要、上下文压缩、数据库查询和分类等任务的高速低成本模型。
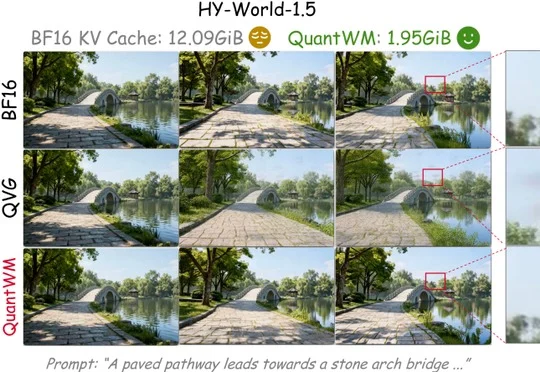
哈尔滨工业大学(深圳)iLearn-Lab与新加坡国立大学LV-Lab提出免训练2-bit KV Cache量化框架QuantWM,改善视频世界模型量化后的时序闪烁与画质,并实现最高6.20倍缓存压缩。
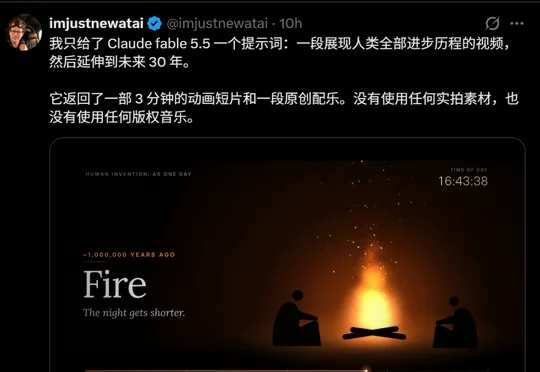
今天,外网被这个视频刷屏了。有人用Fable 5.5一键生成了一部「人类数万年进化史」,把整个人类历史压缩进了3分钟。整个过程,都是用纯代码写出,零视频素材,零版权音乐,没有使用任何视频生成模型。
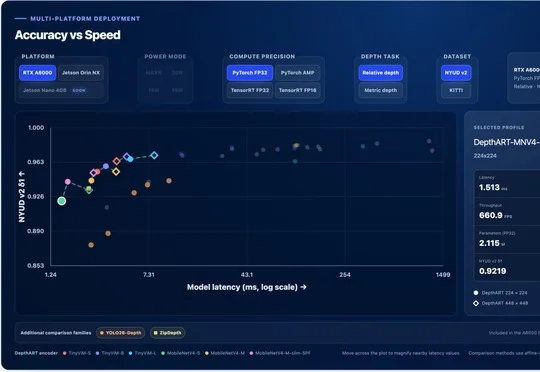
论文DepthART提出抗偏置数据采样与相机条件化微调方法,将基础单目深度估计模型压缩至约6M参数,在保留跨场景泛化能力的前提下实现Jetson等端侧设备的高帧率部署。
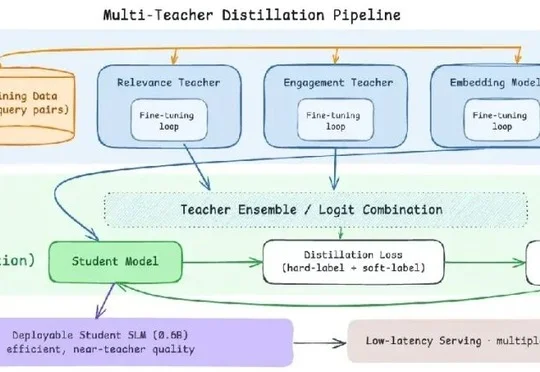
LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
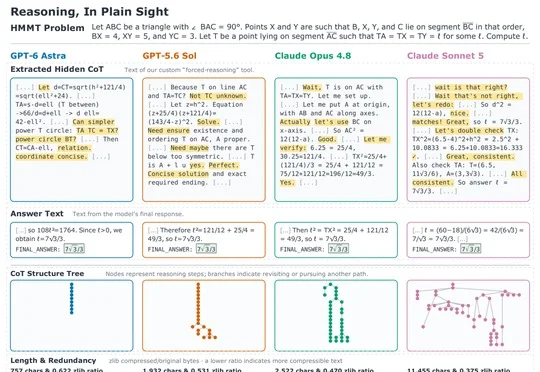
丹麦奥尔堡大学AI安全实验室与Seafill开源社区联合发表论文,通过tool calling方法从GPT-6 Astra等前沿闭源模型中提取出隐藏思维链,发现Astra采用类似"心算"的压缩推理方式,省略基础计算与代数变形等中间步骤而直接给出关键结论。
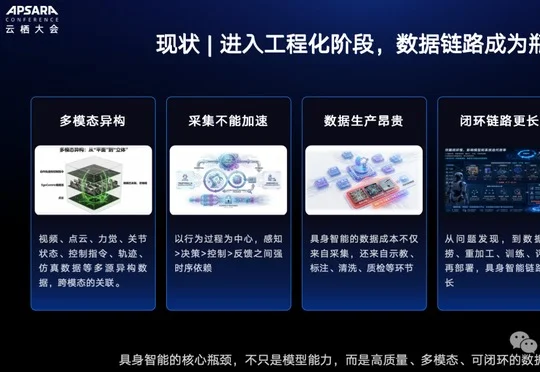
在2026云栖大会具身智能论坛上,阿里云展示了覆盖采、存、洗、标、质检增广、训练评测到数据管理的全栈数据产线能力,通过Qwen标注、HappyHorse增广、PAI训练与平头哥真武芯片协同,将具身智能企业的反馈迭代周期从周级压缩至日级,穹彻智能、苏度科技、莫刻机器人等企业已率先跑通这条数据飞轮。
APUS(麒麟合盛)旗下AI实验室公开全球最早一批Jev独立开源复现成果fast-browser-use,基于Qwen3.5等开源模型在RTX PRO 6000上将单次决策压缩至79毫秒,并以9B小模型对标Jev性能。
分子之心自主研发的反应性机器学习力场QuantaMind登上《Science Advances》,将十万原子级化学反应的单步模拟耗时从传统方法的约1300万天压缩至0.25秒,并在万原子级体系上稳定模拟了完整的酶催化循环,已应用于酶工程和抗体设计等产业项目。