万分之一——大模型后训练中的极端稀疏监督
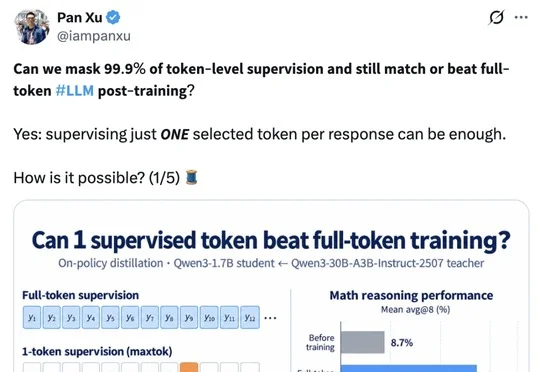
万分之一——大模型后训练中的极端稀疏监督亚马逊公司与杜克大学的研究表明,在大模型后训练的在线策略蒸馏(OPD)中,仅保留万分之一的极端稀疏监督信号即可显著提升学生模型的推理能力,且性能可匹配甚至超越密集全信号训练。
来自主题: AI技术研报
8541 点击 2026-10-04 22:03

 搜索
亚马逊公司与杜克大学的研究表明,在大模型后训练的在线策略蒸馏(OPD)中,仅保留万分之一的极端稀疏监督信号即可显著提升学生模型的推理能力,且性能可匹配甚至超越密集全信号训练。
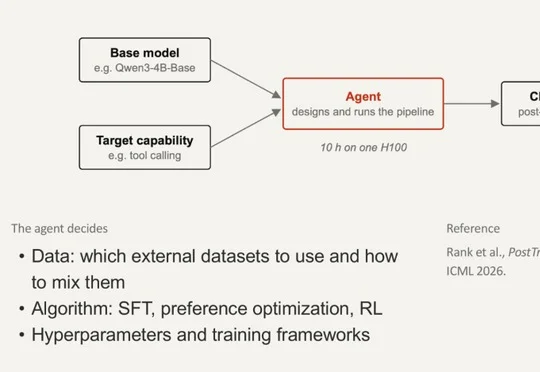
给定一个基座模型、一个目标能力和算力预算,RSI Agent 自己设计后训练算法、收集和整理数据、写代码、跑实验、迭代改进,最终交出一个训练好的模型,全程无人介入。在自主后训练基准 PostTrain
谷歌DeepMind确认Gemini 4进入后训练早期并加速发布,计划通过SpaceX发射搭载TPU芯片的卫星测试太空算力,前DeepMind工程师Robert O'Callahan因认为AI发展太快宣布辞职。
上海交通大学卢策吾、汶川团队联合穹彻提出LIFT(Late Reactive Injection of Force for VLA Post-Training),被CoRL 2026高分收录,该方法在保留预训练知识的前提下,仅通过20至30条在线带力数据后训练即可让VLA学会力反馈,显著提升叠毛巾、插书、汉诺塔圆环放置等接触密集型任务表现。
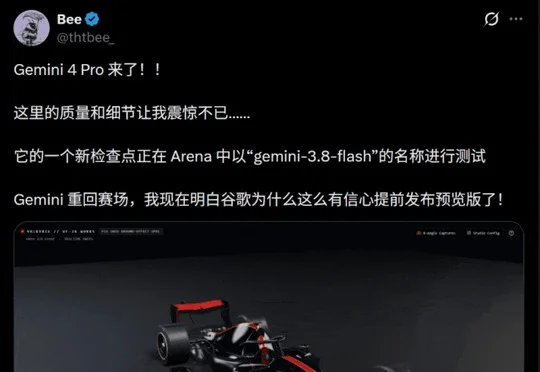
谷歌DeepMind掌门人首次确认Gemini 4 Pro已进入后训练早期阶段,开发者在实测中发现其新检查点在3D物理模拟、代码生成等任务上表现碾压Opus 5.5,且泄露参数显示其具备1000万Token上下文窗口和极具攻击性的定价,谷歌力争在年底前正式发布。
这个问题正随着推理模型和 RLVR 的发展变得更加重要。随着强化学习在大模型后训练中的作用不断增强,模型练什么、怎么练,也需要更仔细地安排。为了解决数据策略接入和效果比较中的麻烦问题,北大DCAI团队联合UCAS、上海算法创新研究院、中关村学院最新发布DataFlex-RL。
最近几个月,后训练成了 AI 行业最集中的议题。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
BAI资本成员企业Humanlaya(原壤智能)宣布完成由鼎晖香港基金领投的数亿元Pre-A轮融资,公司聚焦大模型后训练数据与评测,通过专家网络、高质量数据生产与Benchmark体系帮助模型提升在金融、法律、医疗等复杂专业任务中的能力。
字节跳动旗下豆包在日活跃用户突破2亿后收缩对话团队,通用Session团队规模预计缩减约一半,对话方向的产品后训练团队也在缩减,部分人员转岗至商业化及飞书团队,其余被裁撤,反映出对话产品商业化承压下豆包业务重心的调整。