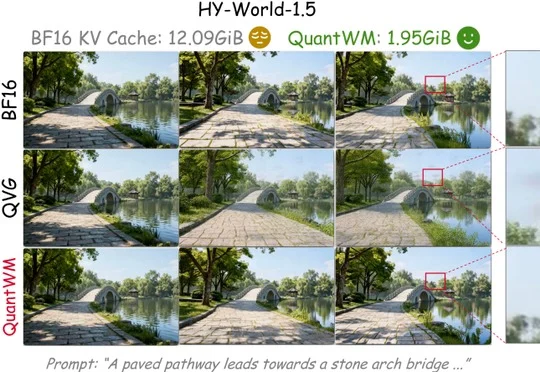
量化后画面闪烁?时序稳定的视频世界模型2-bit KV Cache压缩方案诞生
量化后画面闪烁?时序稳定的视频世界模型2-bit KV Cache压缩方案诞生哈尔滨工业大学(深圳)iLearn-Lab与新加坡国立大学LV-Lab提出免训练2-bit KV Cache量化框架QuantWM,改善视频世界模型量化后的时序闪烁与画质,并实现最高6.20倍缓存压缩。
来自主题: AI技术研报
8494 点击 2026-10-07 15:18

 搜索
哈尔滨工业大学(深圳)iLearn-Lab与新加坡国立大学LV-Lab提出免训练2-bit KV Cache量化框架QuantWM,改善视频世界模型量化后的时序闪烁与画质,并实现最高6.20倍缓存压缩。
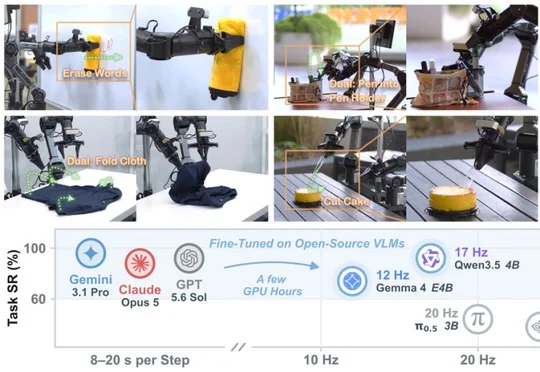
新加坡国立大学 Show Lab 发布的 Show-Harness 通过一套可被 VLM 理解的语义动作接口,使前沿视觉语言模型和轻量微调的 Qwen3.5-2B 能够跨模型、跨机器人本体直接操控真实机器人,并在跨任务、跨环境、跨本体实验中取得显著高于基线的成功率。
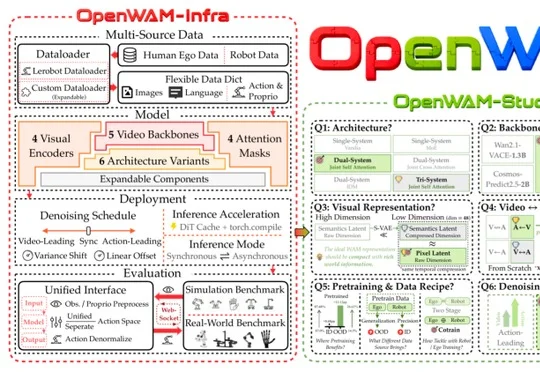
新加坡国立大学、清华大学、北京大学等七所高校联合开源世界动作模型 OpenWAM,由 OpenWAM-Infra 模块化基础设施、OpenWAM-Study 受控实验与 OpenWAM-α 大规模预训练基座模型组成,整合视频生成的世界动态先验与机器人动作学习,在多个仿真基准和真实机器人平台上验证了机器人预测环境变化并执行动作的能力。
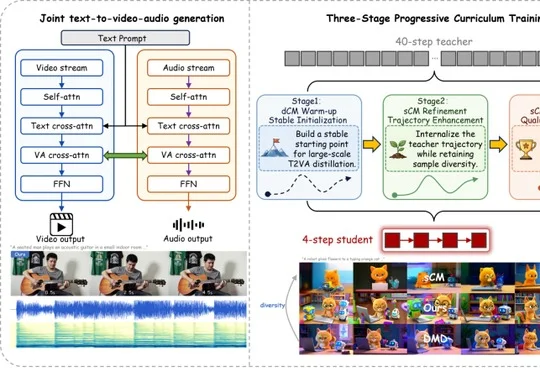
浙江大学、清华大学与新加坡国立大学团队推出TurboT2VA,采用分布蒸馏与轨迹蒸馏联合方案将音视频生成速度提升54.67倍,在单张H20上将1024×1792分辨率121帧的生成耗时从318.74秒降至5.83秒。
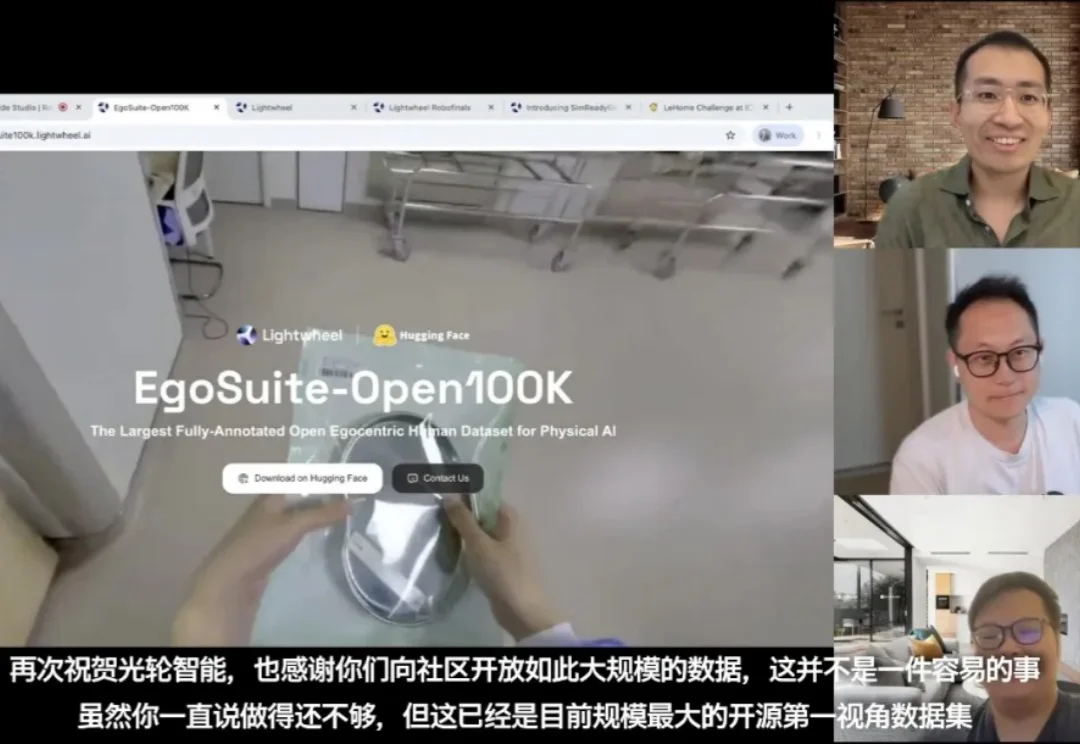
近日,机器人圈知名播客节目 RoboPapers 更新了一期专访,对象是光轮智能创始人兼 CEO 谢晨博士。这期节目的采访人是 RoboPapers 播客联合主持人 Michael Cho 和新加坡国立大学(NUS)助理教授 Jiafei Duan。后者是 MolmoAct 系列机器人模型的作者,研究方向正是机器人基础模型与可扩展数据采集。
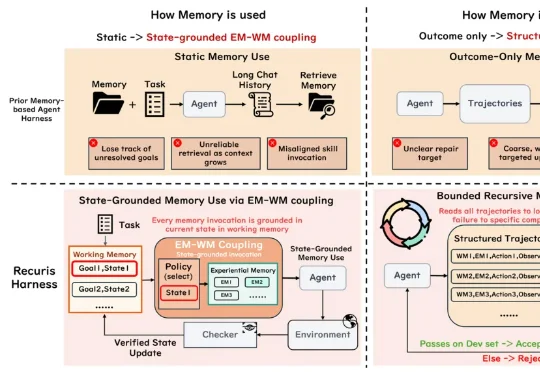
在此背景下,新加坡国立大学、普林斯顿大学与斯坦福、牛津等研究团队合作提出了 Recuris(Recursive Experiential–Working Memory Evolution),作为首个将递归自我改进应用在记忆控制层内的智能体架构,Recuris 通过三项核心技术突破,无需训练即成功实现了从 3B 小模型到 Claude Opus 5 的全面提升。
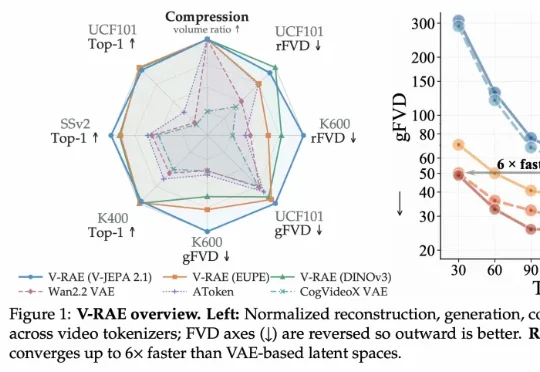
近日,新加坡国立大学 Minghui Guo 与牛津大学 Shengqiong Wu、Hao Fei 在论文《V-RAE: Rethinking Video Latent Spaces for Generation》中提出视频表征自编码器 V-RAE。该方法以冻结的视觉基础模型为编码器,通过轻量级时间池化压缩视频特征,并将具有丰富语义和时间连续性的表征直接用于视频重建、生成与未来预测。
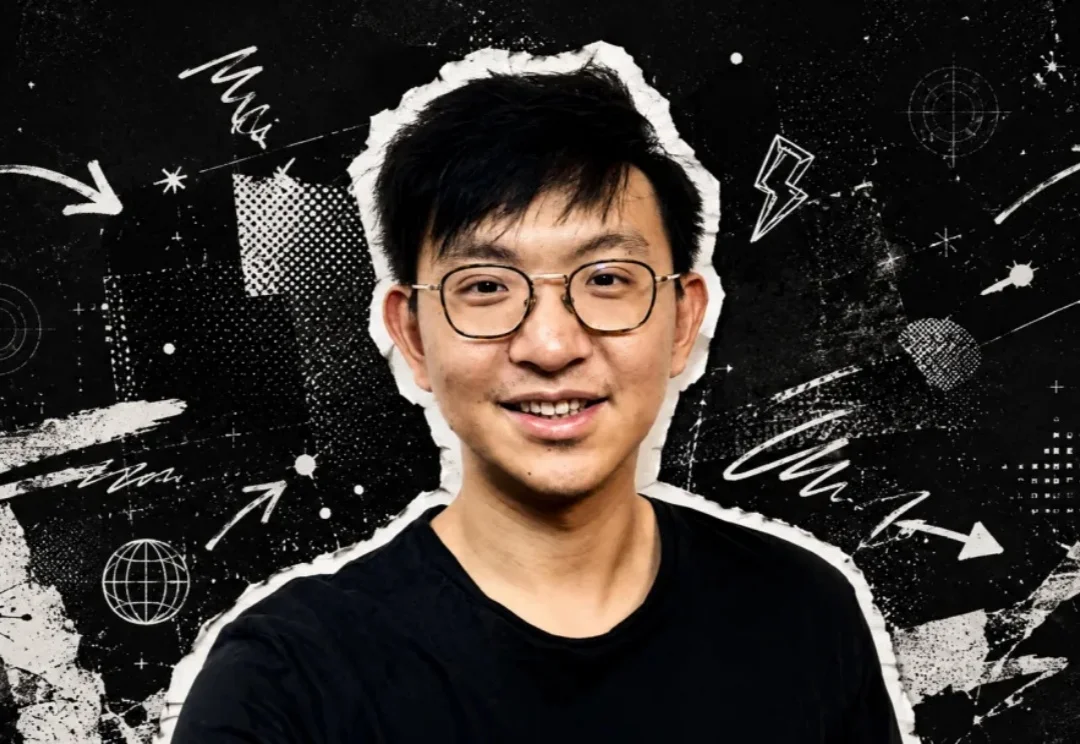
Z Potentials 独家获悉,新加坡国立大学博士,牛津大学博士后研究员林庆泓(Kevin)近期以首席研究员(Principal Researcher)身份加入世界模型公司 Video Rebirth,负责多模态智能体与世界模型相关研究。
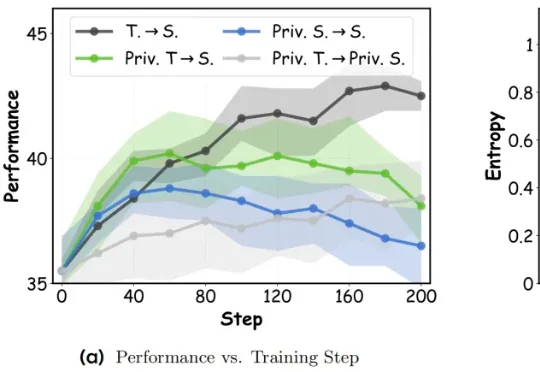
最近,来自新加坡国立大学、香港中文大学 MMLab、北京大学和京东探索研究院的研究团队提出了一种全新的在线策略蒸馏方法: DOPD (Dual On-policy Distillation) ,通过优势感知的双重蒸馏范式,成功破解了这一难题。
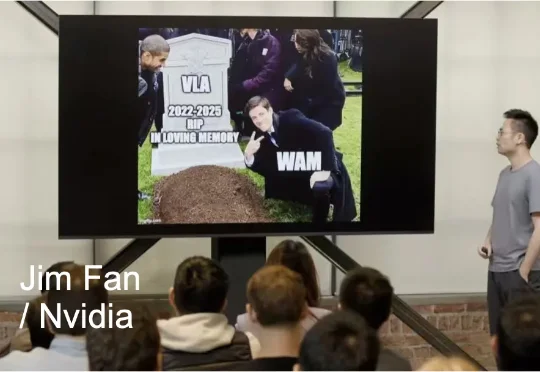
Jim Fan 押注的这条 “先预测世界,再生成动作” 的新路,正是当下具身智能领域最炙手可热的下一代范式 —— 世界动作模型(World Action Models,简称 WAM)。虽然 WAM 正在迅速成为各大顶尖实验室的核心发力点,但业界至今仍然缺乏对它的统一标准和系统梳理。近期,复旦大学可信具身智能研究院,上海创智学院,新加坡国立大学发表了首篇 WAM 的详细综述。